
 Italiano
 English
 Français
 Español
2. Uno sguardo di insieme#
Lo scopo di questo capitolo è duplice: da una parte, mira a descrivere la logica con cui ho organizzato i contenuti e a introdurre, in modo relativamente informale, i concetti cardine. Dall'altra, spiega come utilizzare le componenti interattive del libro. Come indicato nel Paragrafo 1.1, nel testo farò riferimento a un dataset ottenuto modificando un sottoinsieme del Superhero database. Gli esempi traggono quindi spunto dal mondo dei supereroi, ciascuno dei quali è descritto tramite gli attributi indicati nella 2.
Attributo |
Significato |
Contenuto |
|---|---|---|
|
identificativo univoco |
stringa |
|
nome completo |
stringa |
|
identità segreta |
stringa |
|
inclinazione morale |
|
|
luogo di nascita |
stringa |
|
editore/creatore |
stringa |
|
universo |
stringa |
|
anno di prima apparizione |
numero intero |
|
colore degli occhi |
stringa |
|
colore dei capelli |
stringa |
|
altezza in cm. |
numero in virgola mobile |
|
peso in kg. |
numero in virgola mobile |
|
forza |
numero intero (da |
|
intelligenza |
|
|
velocità |
numero intero (da |
|
resistenza |
numero intero (da |
|
abilità nel combattimento |
numero intero (da |
|
elenco dei superpoteri |
stringa |
Il dataset è memorizzato nel file heroes.csv contenuto nella directory
data del repository
associato al libro. Nel codice interattivo, il file è accessibile come
data/heroes.csv. I suoi contenuti sono rappresentati utilizzando il formato
CSV (comma separated values), uno standard comunemente usato per condividere
dati di dimensioni relativamente ridotte: ogni riga corrisponde a un supereroe,
e in essa i valori degli attributi nella 2 sono separati da
virgole. L'unica eccezione riguarda la prima riga del file, che contiene i nomi
degli attributi, anch'essi separati da virgole. La
3 mostra un estratto del dataset, visualizzandone
i valori di alcuni attributi per dieci supereroi selezionati casualmente.
Nel Capitolo 5 vedremo come caricare in memoria e analizzare i contenuti di questo file. Per ora, ci concentreremo su alcuni esempi preliminari. Quello contenuto nella Figura 5 è un primo esempio di grafico interattivo. Nel diagramma in alto, alcuni supereroi sono rappresentati tramite cerchi in un piano cartesiano: le coordinate del centro indicano peso e altezza, mentre il raggio esprime la forza. Il colore varia in base all'editore, utilizzando diverse sfumature di blu. Posizionando il puntatore su un cercio viene visualizzato il nome del supereroe corrispondente. Il diagramma inferiore mostra invece delle barre orizzontali che indicano il numero di supereroi per ciascun editore o creatore. È possibile selezionare un sottoinsieme di supereroi tracciando un rettangolo nel diagramma superiore: gli altri elementi del dataset vengono disattivati, colorandoli in grigio, e il grafico inferiore viene aggiornato per riflettere la distribuzione del gruppo selezionato. La selezione può essere spostata, e facendo clic al suo esterno si ripristina la visualizzazione originale.
import altair as alt
import pandas as pd

heroes = pd.read_csv('data/heroes.csv', index_col=0).convert_dtypes()

filter = (heroes['creator'].isin(heroes.creator.value_counts()[:15].index))
filter &= (heroes['weight']<200)
filter &= (heroes['height']<250)
source = heroes[filter].sample(1500)

# Create the selection for brushing
brush = alt.selection_interval()

points = alt.Chart(source).mark_point().encode(
            alt.X('weight', title='Weight'),
            alt.Y('height', title='Height'),
            alt.Size('strength', title='Strength'),
            color=alt.condition(brush, 'creator', alt.value('lightgray')),
            tooltip='name'
        ).add_params(brush)

bars = alt.Chart(source).mark_bar().encode(
            alt.Y('creator', title='Creator'),
            alt.X('count:Q', title='N. of superheroes'),
            alt.Color('creator:N', title='Creator').scale(scheme="blues"),
        ).transform_filter(
            brush
        ).transform_aggregate(
            count='count()',
            groupby=['creator']
        )
# Create the final interactive chart
chart = (points & bars).configure(background='#eaf3f5')
chart
Figura 5 Un esempio di grafico interattivo basato su altair.#
Interagendo con il grafico è possibile effettuare un’analisi esplorativa dei dati, per esempio per rispondere alle domande seguenti.
Qual è l'editore/creatore con più supereroi in assoluto?
Quale editore ha il maggior numero di supereroi alti meno di un metro?
Quale editore ha il maggior numero di supereroi con un peso compreso tra 80 e 100 kg.?
Qual è il supereroe più alto?
Molti aspetti possono essere analizzati anche senza interagire con il grafico, semplicemente osservandolo nella sua forma iniziale, come per le due domande qui sotto.
Esiste una relazione tendenziale tra peso e altezza dei supereroi?
Questa relazione cambia se consideriamo solo i supereroi di un determinato editore/creatore?
Domande come queste si affrontano con gli strumenti della statistica descrittiva, introdotta nei capitoli 7–15. Il suo obiettivo è estrarre informazioni da un dataset che descrive un insieme di individui, in tutto o in parte. Le tecniche impiegate possono essere di due tipi: qualitative o quantitative.
L'analisi qualitativa cerca di determinare la natura di un certo fenomeno (ad esempio, per rispondere alle domande 5 e 6 nell'elenco precedente). Spesso si basa su strumenti grafici, i cui risultati devono essere interpretati, introducendo un certo grado di soggettività.
L'analisi quantitativa, invece, ha come risultato uno o più valori numerici, che possono essere confrontate in modo oggettivo con altre misure (come i risultati di altre analisi).
Per semplicità, concentriamoci ora sul peso dei supereroi. Il grafico precedente è piuttosto affolalto: se da un lato è facile individuare le altezze minima e massima, dall'altro non è immediato capire se prevalgano i supereroi «leggeri» o quelli più «pesanti». Per chiarire questo aspetto, si può ricorrere a un istogramma, un grafico che evidenzia le frequenze con cui i diversi valori del peso compaiono nel dataset.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()
data = heroes.weight[heroes.weight < 200]

ax.hist(data, bins=30, density=True)
fig
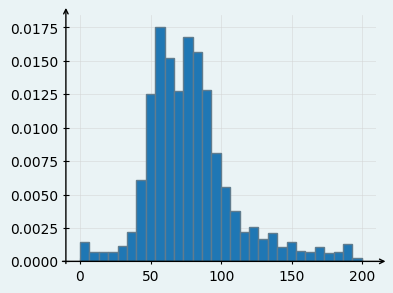
Figura 6 Un istogramma per il peso dei supereroi.#
Gli istogrammi sono spiegati in dettaglio nel Capitolo 7, ma per ora su come leggerne uno. Il grafico è composto da tanti rettangoli: ognuno di essi ha come base un intervallo \(I\) di possibili valori per il peso, e l'altezza è legata alla frazione di supereroi il cui peso rientra in quell'intervallo[1]. Guardando l'istogramma, notiamo due cose interessanti:
i supereroi che pesano più di 125 kg. sono più numerosi di quelli sotto i quaranta chili;
se escludiamo i pesi estremi, la distribuzione è grossomodo simmetrica, con le altezze dei rettangoli che crescono fino a circa 70 kg. e poi calano.
Questa è una prima forma di analisi esplorativa, anche senza grafici interattivi.
Dopo aver raccolto informazioni a partire dai dati, il passo successivo è provare a modellare matematicamente il processo che li ha generati. Per farlo dobbiamo cambiare: non ragioniamo sull'intero dataset, ma immaginiamo di poter osservare uno qualsiasi dei suoi elementi, senza sapere in anticipo quale sarà (ricordatevi della Legge di Franklin). Assumiamo semplicemente che ogni supereroe abbia la stessa possibilità di essere osservato rispetto a tutti gli altri. Nei capitoli 16–21 entreremo nella Teoria della Probabilità, che ci fornisce strumenti per gestire in modo rigoroso l'incertezza dovuta al non sapere quale supereroe osserveremo di verrà di volta. Ci concentreremo su degli eventi, cioè affermazioni che riguardano ciò che potremmo osservare. Per esempio, sono eventi le seguenti affermazioni:
osserveremo un supereroe cattivo (nell'ipotesi che l'inclinazione morale sia fissa, definita a priori e indicata dall'attributo
alignementdel dataset);se osserviamo un supereroe Marvel e un supereroe DC, il primo è più veloce del secondo;
se osserviamo due supereroi apparsi per la prima volta nello stesso anno, questi hanno lo stesso indice di intelligenza;
se osserviamo dieci supereroi, almeno uno di essi è collocato in uno degli universi di Star Wars.
Non sappiamo se queste affermazioni siano vere o false (tecnicamente, se i relativi eventi si verificano oppure no): dipende da cosa osserveremo. Qui entra in gioco la probabilità, che assegna un numero \(p \in [0, 1]\) per quantificare questa incertezza. Senza entrare, per ora, nei dettagli, l'incertezza è massima quando \(p\) si avvicina a \(\frac{1}{2}\) e diminuisce quando \(p\) tende ai suoi estremi. In particolare, più \(p\) è vicino a zero, meno possiamo ritenere veritiera l'affermazione, e se \(p = 0\) siamo sicuri che sia falsa; analogamente, man mano che \(p\) si avvicina a \(1\) cresce la confidenza che l'affermazione sia vera, cosa che diventa certa quando \(p = 1\). Vedremo che questa formalizzare ci permetterà di calcolare la probabilità di eventi complessi a partire da eventi più semplici. Ad esempio, per calcolare la probabilità dell'ultimo evento nell'elenco precedente basta conoscere la probabilità di osservare un supereroe proveniente da un universo Star Wars.
Molto spesso, gli eventi considerati fanno riferimento a una o più quantità numeriche. Pensate, per esempio, alla resistenza di un supereroe o alla sua altezza: ha senso chiedersi se sia massima o se rientri in un certo intervallo. È importante sottolineare che il fatto che ogni supereroe abbia le stesse chance degli altri di essere osservato non implica affatto che lo stesso valga per i valori che queste quantità possono assumere. Potete facilmente rendervene conto riguardando il precedente istogramma: un peso tra \(50\) e \(100\) kg. è molto più frequente rispetto a uno superiore ai cento chili. Diventa quindi necessario modellare anche queste quantità casuali. A tal fine, si introduce il concetto di variabile aleatoria e la relativa formalizzazione matematica. Per ora, concentriamoci sul caso specifico del peso dei supereroi, ricordando che in generale il procedimento può essere più complicato o semplicemente diverso. L'idea alla base della formalizzazione è quella di individuare una funzione \(f\), detta densità di probabilità, il cui grafico idealizza l'istogramma dei valori osservati, producendo una curva continua che ne mantiene le proprietà principali. Per il nostro esempio, queste proprietà sono la simmetria rispetto a un asse centrale l'andamento unimodale (cioè crescente fino a un valore massimo e decrescente da lì in avanti). Ci sono infinite funzioni che esibiscono queste due proprietà, ma per motivi troppo complessi da spiegare—ma che chiarirò più avanti—mi concentrerò su quella definita da:
dove \(x\) indica un generico peso e \(f(x; \mu, \sigma)\) restituisce l'altezza corrispondente nell'istogramma idealizzato. È importante evidenziare che \(f\) ha un solo argomento, denotato da \(x\), mentre \(\mu \in \mathbb R\) e \(\sigma \in \mathbb R^+\) sono due parametri che devono essere fissati per definire completamente la funzione. Il punto e virgola serve proprio a distinguere l'argomento dai parametri. Per la precisione, al variare di \(\mu\) e \(\sigma\) (2.1) definisce una famiglia di funzioni: ciascuna corrisponde a una variabile aleatoria, e noi ci riferiamo a questa è una famiglia come a un modello di variabile aleatoria. Nella Figura 7 potete osservare come cambia il grafico di \(f\) al variare dei suoi parametri. Agendo sui due selettori, associati a \(\mu\) e \(\sigma\), vedrete immediatamente come il grafico di \(f\) si aggiorna in base alle nuove impostazioni.
import asyncio
import matplotlib.pyplot as plt
import numpy as np
from js import document
from pyscript import display
from pyscript.web import page, when

mu = float(page['#pdf-mu-slider'][0].value)
sigma = float(page['#pdf-sigma-slider'][0].value)

x = np.linspace(0, 200, 400)
y = 1 / (sigma * np.sqrt(2 * np.pi)) * np.exp(-0.5 * ((x - mu) / sigma) ** 2)

fig_pdf, ax_pdf = plt.subplots()
curve_pdf, = ax_pdf.plot(x, y, alpha=0.5, color='tab:blue')


ax_pdf.set_xlabel('$x$', fontsize=12, ha='right')
#ax.xaxis.set_label_coords(1.07, 0.03)
ax_pdf.set_ylabel('$f$', fontsize=12, rotation=0)
#ax.yaxis.set_label_coords(0., 1.09)
ax_pdf.set_xlim(0, 200)
ax_pdf.set_ylim(0, 0.02)

@when("input", "#pdf-mu-slider, #pdf-sigma-slider")
def pdf_plot(event):

    mu = float(page['#pdf-mu-slider'][0].value)
    sigma = float(page['#pdf-sigma-slider'][0].value)
    page['#pdf-mu-value'][0].innerHTML = f'{mu:.1f}'
    page['#pdf-sigma-value'][0].innerHTML = f'{sigma:.1f}'

    y = 1 / (sigma * np.sqrt(2 * np.pi)) * np.exp(-0.5 * ((x - mu) /
        sigma) ** 2)
    curve_pdf.set_data(x, y)
    display(fig_pdf, target='graph-2', append=False)

display(fig_pdf, target='graph-2', append=False)
Figura 7 Grafico della densità di probabilità descritta da (2.1).#
Uno dei motivi per i quali si parla di «modello» di variabile aleatoria è legato al fatto che è possibile scegliere i valori dei suoi parametri in modo da adattare la funzione di densità di probabilità, e più in generale la corrispondente variabile aleatoria, a dati precedentemente osservati. Nel caso appena visto, ciò equivale a scegliere dei valori opportuni per \(\mu\) e \(\sigma\), facendo sì che il grafico di \(f\) si sovrapponga qualitativamente con quello dell'istogramma inizialmente ottenuto per il peso. Il grafico interattivo in Figura 8 vi permette di eseguire manualmente questa operazione, agendo sui selettori al fine di trovare un allineamento qualitativo tra i due grafici.
data = heroes['weight'][heroes['weight'] < 200].dropna()
mu = float(page['#model-mu-slider'][0].value)
sigma = float(page['#model-sigma-slider'][0].value)

x = np.linspace(0, 200, 400)
y = 1 / (sigma * np.sqrt(2 * np.pi)) * np.exp(-0.5 * ((x - mu) / sigma) ** 2)

fig, ax = plt.subplots()
ax.hist(data, bins=30, density=True, alpha=0.3, color='tab:blue')
curve, = ax.plot(x, y, alpha=0.5, color='tab:blue')

ax.set_xlabel(r'$x$', fontsize=12, ha='right')
ax.xaxis.set_label_coords(1.07, 0.03)
ax.set_ylabel(r'$f$', fontsize=12, rotation=0)
ax.yaxis.set_label_coords(0., 1.09)
ax.set_xlim(0, 200)
ax.set_ylim(0, 0.02)

@when("input", "#model-mu-slider, #model-sigma-slider")
def model_plot(event):

    mu = float(page['#model-mu-slider'][0].value)
    sigma = float(page['#model-sigma-slider'][0].value)
    page['#model-mu-value'][0].innerHTML = f'{mu:.1f}'
    page['#model-sigma-value'][0].innerHTML = f'{sigma:.1f}'

    y = (1 / (sigma * np.sqrt(2*np.pi))) * np.exp(-0.5 * ((x - mu) / sigma)**2)
    curve.set_data(x, y)
    display(fig, target='graph-4', append=False)

display(fig, target='graph-4', append=False)
Figura 8 Sovrapposizione del grafico della densità descritta da (2.1) all'istogramma di Figura 6. Agendo sui selettori è possibile trovare dei valori per i parametri che adattano il modello all'istogramma.#
Nell'ultima parte del libro, vedremo che esistono vari metodi per determinare automaticamente i parametri di un modello, in modo da adattarlo a un insieme di dati. Questo è uno degli scopi della statistica inferenziale, illustrata nei capitoli 22–25. Il punto di partenza è sempre un dataset, che in questo contesto rappresenta un campione di osservazioni effettuate su una popolazione più ampia. Su questa popolazione vogliamo fare delle ipotesi o trarre conclusioni, anche se non possiamo osservarla nella sua interezza. In altre parole, useremo il campione per ottenere informazioni su ciò che non sappiamo della popolazione. Il caso più semplice — e anche quello su cui ci concentreremo maggiormente — è quello in cui la popolazione è descritta da una variabile aleatoria, associata a un modello che dipende da uno o più parametri sconosciuti. L'obiettivo è quello di approssimare questi parametri, o altre quantità che dipendono da essi. Per esempio, consideriamo la popolazione dei supereroi nel nostro dataset e supponiamo di essere interessati al loro peso medio \(p\). Se abbiamo a disposizione solo un campione di cento supereroi, il buon senso suggerisce di usare la media del loro peso come approssimazione di \(p\). In generale, chiamiamo stimatore la funzione che viene applicata al campione per ottenere questo tipo di approssimazioni. Nel nostro esempio, lo stimatore utilizzato è la media aritmetica dei valori del campione, detta media campionaria. La 4 mostra come variano i valori di questo stimatore in seguito all'estrazione di dieci campioni differenti.
È natuarale che le medie campionarie ottenute dai dieci campioni siano diverse tra loro, dal momento che ogni campione è diverso. Tuttavia, i risultati ottenuti non variano drasticamente e tendono a concentrarsi attorno a \(79\), che è una buona approssimazione del valore corretto per il peso medio di tutti i supereroi (come potete verificare osservando il precedente istogramma). Ma possiamo essere certi che la media campionaria sia davvero il miglior stimatore possibile? E, più in generale, come possiamo valutare la bontà di uno stimatore, considerando anche la variabilità intrinseca che abbiamo appena evidenziato? Queste domande troveranno risposta nella parte dedicata alla statistica inferenziale. Questa parte, in un certo senso, mi permette di terminare il libro «chiudendo il cerchio»: sia perché mette in pratica in maniera sinergica quello che abbiamo visto nelle parti sulla statistica descrittiva e sul calcolo delle probabilità, sia perché permette di comprendere più a fondo la potenza di alcuni dei concetti e degli strumenti già incontrati—magari in modo relativamente informale—nelle parti precedenti.
Prima però di iniziare con la statistica descrittiva, è importante rivedere alcuni concetti fondamentali di programmazione degli elaboratori, e soprattutto prendere dimestichezza con gli strumenti computazionali che userò in tutto il libro. È questo lo scopo dei capitoli 4 e 5, che aprono la trattazione.
2.1. Esercizi#
Al termine di ogni capitolo sono proposti alcuni esercizi, la cui difficoltà di risoluzione è indicata dal numero di pallini racchuso tra parentesi.
Esercizio 1 (•)
Scaricate il dataset dei supereroi dal repository del libro e importatelo in un qualsiasi programma che gestisce fogli elettronici (tutti quelli più diffusi hanno la capacità di importare file CSV), in modo che ogni colonna contenga un diverso attributo. Focalizzatevi, diciamo, sulle prime trenta righe e considerate separatamente le varie colonne, al fine di farvi un'idea di come varino i valori associati ai singoli attributi.
Esercizio 2 (•••)
Riconsiderate l'esercizio precedente, guardando i contenuti di ogni singola colonna del file CSV senza utilizzare un elaboratore di fogli elettronici, ma usando solamente un terminale e i comandi di shell.
Esercizio 3 (••)
Sulla base dell'idea che vi siete fatti in merito dal dataset dei supereroi risolvendo gli esercizi precedenti, provate a suddividere gli attributi in gruppi omogenei basandovi non sul tipo di dato che viene utilizzato per rappresentare i valori corrispondenti (indicato nella colonna «Contenuto» della 2), bensì sulla natura degli attributi stessi.
Esercizio 4 (•)
Rispondete alle domande numerate da 1 a 4 nell'elenco che segue il primo grafico interattivo.
Esercizio 5 (••)
Rispondete alle domande 5 e 6 nell'elenco che segue il primo grafico interattivo. Verbalizzate il ragionamento che avete fatto e scrivetelo.
Esercizio 6 (••)
Formulate altre domande relative al dataset alle quali si possa trovare risposta utilizzando il primo grafico interattivo. Anche in questo caso, verbalizzate il ragionamento che va fatto per rispondere a queste domande.
Esercizio 7 (•)
Considerate i seguenti valori
e disegnate a mano il corrispondente istogramma, calcolando l'altezza di ogni rettangolo come il numero di valori che ricadono nell'intervallo corrispondente, e utilizzando i seguenti intervalli di riferimento: \([0, 5)\), \([5, 10)\), \([10, 15)\), \([15, 20)\). Confrontate la forma del grafico ottenuto con quanto mostrato nel testo, mettendo in luce le principali differenze.
Esercizio 8 (•)
Scrivete dieci possibili eventi che riguardano il dataset dei supereroi.
Esercizio 9 (••)
Scrivete un evento la cui probabilità è uguale a zero. Scrivete poi un evento avente \(1\) come probabilità.
Esercizio 10 (••)
Ponete \(\mu = \sigma = 1\) ed effettuate lo studio della funzione descritta in (2.1), disegnando a mano il grafico corrispondente e verificando che questo grafico abbia la stessa forma visualizzata nel secondo grafico interattivo.
Esercizio 11 (•)
Sulla base del risultato dell'esercizio precedente, e tenuto conto di quanto avete sperimentato lavorando sul secondo grafico interattivo, che ruolo hanno i parametri \(\mu\) e \(\sigma\) sul grafico di \(f\) definita in (2.1)?
Esercizio 12 (•)
Utilizzando il secondo grafico interattivo, determinate dei valori per \(\mu\) e \(\sigma\) che permettono di sovrapporre in modo ragionevole il grafico di \(f\) all'istogramma del peso dei supereroi.
Esercizio 13 (••)
Verbalizzate il ragionamento che avete fatto per convincervi che \(79\) è approssimativamente il valore medio del peso dei supereroi.