
 Italiano
 English
 Français
 Español
20.4. Le distribuzioni geometriche#
Bruce Banner si trasforma in Hulk ogni volta che non riesce a controllare un attacco d'ira. Ipotizziamo che, indipendentemente da tutto il resto, ciò avvenga con una prefissata probabilità: possiamo dunque modellare la trasformazione nei termini di un esperimento bernoulliano. Convenzionalmente, definiamo questo esperimento in modo che il successo si verifichi quando Banner si arrabbia e si trasforma in Hulk; al contrario, il fallimento avviene quando lui si arrabbia ma non si trasforma. Nel momento in cui iniziamo a leggere un fumetto, possiamo domandarci dopo quante arrabbiature Bruce Banner diventerà Hulk. La risposta sarà «uno» se la trasformazione avverrà al primo colpo di rabbia, «due» se il primo attacco d'ira sarà superato ma il secondo no, e così via. In linea di principio, non possiamo stabilire a priori un numero massimo di arrabbiature entro il quale Banner si trasformerà. Pertanto siamo di fronte a un esperimento casuale i cui esiti possono essere associati a tutti i numeri interi positivi. Questo tipo di esperimento è ben descritto dalla famiglia delle distribuzioni geometriche.
20.4.1. Il modello geometrico#
Un processo di conteggio alternativo rispetto a quello binomiale consiste nel considerare un esperimento di Bernoulli descritto dalla corrispondente probabilità di successo \(p \in (0, 1]\), e ripetendolo in condizioni di indipendenza fino a che non si ottiene per la prima volta un successo come esito. Questo processo viene modellato utilizzando la distribuzione geometrica, definita di seguito.
Definizione 48 (La famiglia delle distribuzioni geometriche)
Fissato \(p \in (0, 1]\), la distribuzione geometrica di parametro \(p\) è definita dalla funzione di massa di probabilità
Userò la sintassi \(X \sim \mathrm G(p)\) per indicare che una variabile aleatoria \(X\) segue una distribuzione geometrica di parametro \(p\). L'insieme di tutte le distribuzioni geometriche al variare dei valori del reltivo parametro prende il nome di famiglia delle distribuzioni geometriche.
Siccome le varie ripetizioni dell'esperimento di Bernoulli di parametro \(p\) sono tra loro indipendenti, si ha
e quindi una distribuzione geometrica descrive il numero di ripetizioni di un esperimento di Bernoulli che hanno come esito un fallimento che precedono l'esecuzione del medesimo esperimento che per la prima volta ha come esito un successo. Il supporto di una siffatta variabile aleatoria è l'insieme \(\mathbb N \cup \{ 0 \}\) dei numeri naturali allargato in modo da comprendere la specificazione \(0\), che corrisponde al caso in cui l'esperimento viene eseguito una e una sola volta perché il primo esito che si verifica è un successo (e pertanto il numero di insuccessi ottenuti è nullo).
Il motivo per il quale l'insieme dei possibili valori del parametro \(p\) è un intervallo semiaperto a sinistra è legato alla natura del processo di conteggio. Il valore \(p=1\) è ammissibile, sebbene in questo caso ogni esecuzione dell'esperimento di Bernoulli avrebbe come esito un successo, e quindi la distribuzione degenera nella descrizione della costante \(0\). Al contrario, la possibilità che \(p\) sia nullo va esclusa a priori, perché in questo caso non sarebbe mai possibile avere come esito un successo, e quindi la ripetizione dell'esperimento non terminerebbe mai. Questo implicherebbe in un certo qual senso che la specificazione assunta assume un valore infinito, cosa che è proibita dalla Definizione 25.
Si verifica facilmente che sommando i valori di massa di probabilità per tutte le specificazioni della distribuzione si ottiene come risultato 1:
Nomenclatura
La distribuzione geometrica prende il nome dalla serie omonima, utilizzata nel penultimo passaggio dell'equazione precedente e definita da
a patto che che \(|\alpha| < 1\). Nel nostro caso questa condizione equivale a \(0 < p < 2\), che è sempre verificata, essendo \(p \in (0, 1]\).
La forma analitica per la funzione di ripartizione di una generica distribuzione geometrica si ottiene nel modo seguente:
Teorema 42
Fissato \(p \in (0, 1]\) e data \(X \sim \mathrm G(p)\), \(\forall n \in \mathbb N \cup \{ 0 \}\) e \(\forall x \in \mathbb R\)
Dimostrazione.
Indipendentemente dal valore di \(n\) si ha che
dove nel terzultimo passaggio ho applicato la sostituzione \(i = x - (n + 1)\). Pertanto \(F_X(n; p) = \mathbb P(X \leq n) = 1 - \mathbb P(X > n) = 1 - (1-p)^{n+1}\). Fissato ora un generico \(x \in \mathbb R^+\) e indicato con \(\lfloor x \rfloor\) l'intero ottenuto troncando \(x\) (o, equivalentemente, arrotondandolo per difetto), l'evento \(X \leq x\) equivarrà a \(X \leq \lfloor x \rfloor\). Tenuto infine conto del fatto che le specificazioni di una distribuzione geometrica sono non negative, si ottiene
come forma più generale per la funzione di ripartizione.
La Figura 76 mostra i grafici delle funzioni di massa di probabilità e di ripartizione di una generica distribuzione geometrica. Essendo in questo caso infinito il supporto della distribuzione, il primo grafico contiene in teoria un numero infinito di bastoncini, e solo quelli relativi ai valori più piccoli delle specificazioni sono mostrati effettivamente. È possibile modificare il valore del parametro \(p\) agendo sul relativo selettore e verificare in che modo i grafici vengono modificati.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as st
from pyscript import display
from pyscript.web import page, when

p_1 = float(page['#p'][0].value)
G_1 = st.geom(p_1, loc=-1)

x_1 = np.arange(0, 11)
y_1 = G_1.pmf(x_1)

fig_1, ax_1 = plt.subplots()

cdf_y = [0] + list(G_1.cdf(x_1))
cdf_xmin = list(range(-1, 11))
cdf_xmax = list(range(0, 11)) + [20]
cdf = ax_1.hlines(cdf_y, cdf_xmin, cdf_xmax)
pmf_lines = ax_1.vlines(x_1, 0, y_1, color='k')
pmf_dots = ax_1.plot(x_1, y_1, 'o')[0]

ax_1.set_xlabel('$x$', fontsize=12, ha='right')
ax_1.set_ylabel('$f, F$', fontsize=12, rotation=0)
ax_1.set_xlim(-1, 11)
ax_1.set_ylim(0, 1.1)
ax_1.set_xticks(range(0, 12, 2))

@when("input", "#p")
def geometric_plot(event):
    p_1 = float(page['#p'][0].value)
    page['#p-value'][0].innerHTML = f'{p_1:.1f}'

    G_1 = st.geom(p_1, loc=-1)

    x_1 = np.arange(0, 11)
    y_1 = G_1.pmf(x_1)

    cdf_y = [0] + list(G_1.cdf(x_1))
    cdf_xmin = list(range(-1, 11))
    cdf_xmax = list(range(0, 11)) + [20]
    cdf_segments = [[[xmin, y_val], [xmax, y_val]]
                    for y_val, xmin, xmax in zip(cdf_y, cdf_xmin, cdf_xmax)]

    cdf.set_segments(cdf_segments)

    # Update PMF vertical lines
    pmf_segments = [[[xi, 0], [xi, yi]] for xi, yi in zip(x_1, y_1)]
    pmf_lines.set_segments(pmf_segments)

    pmf_dots.set_data(x_1, y_1)

    display(fig_1, target='graph-1', append=False)

display(fig_1, target='graph-1', append=False)
Figura 76 Grafici della funzione di massa di probabilità e di ripartizione per il modello geometrico.#
20.4.2. Valore atteso e varianza della distribuzione geometrica#
Il calcolo dei valori attesi che coinvolgono la distribuzione geometrica richiede tipicamente di valutare il valore di serie infinite. Pertanto conviene iniziare dal seguente risultato intermedio.
Lemma 4
Per ogni \(\alpha \in (-1, 1)\) valgono le seguenti identità:
Dimostrazione.
Osservando che \(i \alpha^{i - 1}\) è la derivata prima di \(\alpha^i\) rispetto ad \(\alpha\), otteniamo:
e ciò completa la dimostrazione della prima identità, tenendo conto del fatto che i valori considerati per \(\alpha\) garantiscono sempre che la serie geometrica converga. Procedendo in modo analogo,
il che dimostra anche la seconda identità.
Questo risultato ci permette di calcolare agevolmente il valore atteso della distribuzione.
Teorema 43
Dati \(p \in (0, 1]\), e \(X \sim \mathrm G(p)\),
Dimostrazione.
Applicando la definizione di valore atteso si ottiene
e quindi ponendo \(\alpha = 1 - p\) e applicando la prima identità del Lemma 4 si ottiene
che dimostra la proposizione.
La Figura 77 visualizza graficamente l'andamento del valore atteso della distribuzione geometrica in funzione del corrispondente parametro \(p\).
fig, ax = plt.subplots()

p = np.arange(0.01, 1.01, 0.01)
e = (1 - p) / p

ax.plot(p, e)
ax.set_ylim(0, 10)
fig
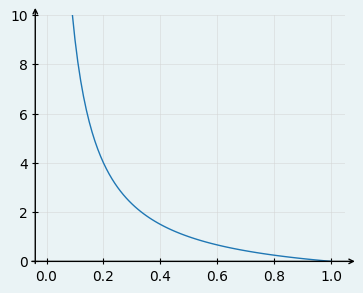
Figura 77 Grafico del valore atteso del modello geometrico in funzione del valore del suo parametro \(p\).#
Il risultato è coerente con il significato dato a questo parametro: più il suo valore si avvicina a \(1\), più è probabile che si ottenga un successo nel primo esperimento bernoulliano alla base della distribuzione geometrica, così che il numero atteso di fallimenti tende a \(0\). Parimenti, quando \(p\) diminuisce diventa meno probabile ottenere un successo e quindi aumenta il numero atteso di esecuzioni dell'esperimento casuale da effettuare. In particolare, al tendere di \(p\) a zero l'esperimento bernoulliano non avrà mai successo e quindi il numero atteso di ripetizioni tenderà a infinito.
Procedendo in modo simile a quanto abbiamo visto per il valore atteso è possibile calcolare anche la varianza della distribuzione.
Teorema 44
Data \(X \sim \mathrm G(p)\) con \(p \in (0, 1]\),
Dimostrazione.
Il calcolo del momento secondo si ottiene applicando la seconda identità del Lemma 4:
e di conseguenza
è il valore per la varianza della distribuzione geometrica.
Come già fatto per il valore atteso, nella Figura 78 è possibile vedere l'andamento della varianza \(\mathbb V(X)\) al variare del parametro \(p \in (0, 1]\) di una variabile aleatoria \(X \sim \mathrm G(p)\).
fig, ax = plt.subplots()

x = np.arange(0.01, 1.01, 0.01)
y = list(map(lambda p: (1-p)/p**2, x))

plt.plot(x, y)
plt.ylim(0, 50)
fig
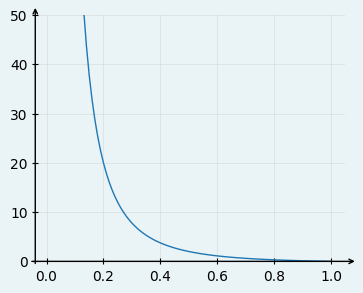
Figura 78 Grafico della varianza del modello geometrico in funzione del valore del suo parametro \(p\).#
Anche in questo caso il grafico ottenuto è coerente con l'esperimento casuale alla base della distribuzione: al diminuire di \(p\) la massa di probabilità si concentra su un insieme sempre più grande di valori, dunque la varianza aumenta. Quando \(p=1\) il numero di insuccessi è sempre nullo e quindi la variabile aleatoria degenera in una costante che per definizione ha varianza nulla.
20.4.3. Assenza di memoria e tempi di attesa#
La distribuzione geometrica gode di una particolare proprietà, descritta dal seguente teorema.
Teorema 45
Dati \(p \in (0, 1]\) e \(X \sim \mathrm G(p)\), per ogni \(x, y \in \mathbb N\)
Dimostrazione.
Nella dimostrazione del Teorema 42 abbiamo visto che \(\mathbb P(X > x) = (1 - p)^{\lfloor x \rfloor +1}\), pertanto \(\mathbb P(X \geq x) = \mathrm P(X \geq \lfloor x \rfloor) = \mathrm P(X > \lfloor x \rfloor - 1) = (1-p)^{\lfloor x \rfloor}\). Sfruttando questo risultato otteniamo
e quindi la tesi è dimostrata.
La proprietà espressa da (20.7) prende il nome di assenza di memoria. Essa indica che durante la ripetizione dell'esperimento bernoulliano alla base della distribuzione geomatrica, il fatto che sia avvenuto un numero \(n\) (anche elevato) di insuccessi consecutivi non permette di dire alcunché sul numero di successivi insuccessi prima che si verifichi il primo successo. In altre parole, non c'è nessuna differenza, da un punto di vista probabilistico, dalla ripetizione degli esperimenti che vanno dal \(n+1\)-esimo in poi e dal ricominciare da capo la ripetizione.
20.4.4. I momenti della distribuzione geometrica (*)#
Fissato \(p \in (0, 1]\), la funzione generatrice dei momenti per una variabile aleatoria \(X \sim \mathrm{g}(p)\) ha la seguente forma analitica:
ed è definita per i valori di \(t\) per i quali è garantita la convergenza della serie geometrica contenuta in (20.8), cioè quando \(| (1 - p) \mathrm e^t | < 1\), che equivale a \(t < - \log(1-p)\). Pertanto le prime quattro derivate della funzione generatrice dei momenti saranno
Pertanto:
\(\mathbb E(X) = m_X^\prime(0) = \frac{1-p}{p}\), a conferma di quanto abbiamo ricavato nel Teorema 43;
\(\mathbb E(X^2) = m_X^{\prime(0)\prime} = \frac{(1 - p)(2 - p)}{p^2}\), come ottenuto nella dimostrazione del Teorema 44;
i momenti terzo e quarto sono rispettivamente \(\mu_3^\prime = m_X^{\prime\prime\prime}(0) = \frac{(1-p)(p^2 -6p + 6)}{p^3}\) e \(\mu^\prime_4 = m_X^{\mathrm{IV}}(0) = \frac{1-p}{p} (24 - 36p + 14p^2 - p^3)\).
Per calcolare i momenti centrali si può utilizzare il
teo-central-moments: posto \(Y \triangleq X - \frac{1-p}{p}\) si ha
e pertanto i primi due momenti centrali sono \(\mu_1 = m_Y^\prime(0) = 0\), come deve necessariamente essere, e \(\mu_2 = m_Y^{\prime\prime}(0) = \frac{1 - p}{p^2}\), che coincide con la varianza della distribuzione geometrica ricavata nel Teorema 44. Analogamente
da cui si ricava che il terzo momento centrale è
e quindi la skewness della distribuzione è pari a
Infine,
e
e pertanto la curtosi della distribuzione geometrica è
che è sempre strettamente positiva, il che rende la distribuzione leptocurtica: tenderà a produrre più valori fuori scala se confrontata con una distribuzione normale con gli stessi valore atteso e deviazione standard. Questo fatto è abbastanza ovvio, avendo la distribuzione geometrica una coda a destra. In particolare, più \(p\) si avvicina a \(1\) e più la curtosi aumenta, coerentemente con il fatto che in questi casi la distribuzione tende a degenerare alla costante \(0\). La Figura 79 illustra il grafico skewness-curtosi per la famiglia delle distribuzioni geometriche.
fig, ax = plt.subplots()

p = np.linspace(0.01, 0.99, 300)
skewness = (2 - p) / (1 - p)**0.5
kurtosis = 6 + p**2 / (1 - p)

plt.plot(skewness, kurtosis)
fig
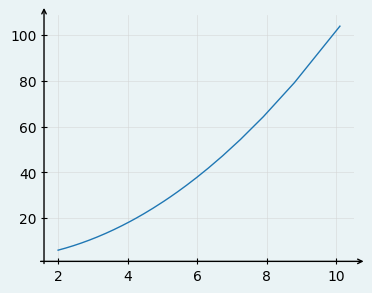
Figura 79 Il grafico skewness-curtosi del modello geometrico.#
20.4.5. Quantili della distribuzione geometrica#
Abbiamo visto nel Teorema 42 come nella distribuzione geometrica sia possibile semplificare la sommatoria alla base del calcolo della funzione di ripartizione. Questo permette di calcolare in modo abbastanza agevole un generico quantile della distribuzione. Infatti, dato \(p \in (0, 1]\) e applicando (20.6) a una variabile aleatoria \(X \sim \mathrm G(p)\), dato un generico livello \(q \in [0, 1]\) si ha
Pertanto la mediana, il primo e il terzo quartile della distribuzione saranno
come evidenziato nel diagramma a scatola di Figura 80, nel quale ho fissato \(p = 0.2\). Il baffo a destra della scatola è parzialmente tratteggiato per enfatizzare il fatto che si estende fino a \(+\infty\).
fig, ax = plt.subplots(figsize=(6, 0.3))

p = 0.2
third_quartile = np.ceil(-2 / np.log2(1 - p)) - 1
median = np.ceil(-1 / np.log2(1 - p)) - 1
first_quartile = np.ceil((np.log2(3) - 2) / np.log2(1 - p)) - 1

lw = 1
height = 0.2

ax.plot([median, median], [-height, height], c='k', linewidth=1.5)

ax.plot([0, 0], [-.1, .1], c='k', linewidth=lw)
ax.plot([0, first_quartile], [0, 0], c='k', linewidth=lw)

ax.plot([first_quartile, first_quartile], [-height, height],
         c='k', linewidth=lw)

ax.plot([third_quartile, third_quartile], [-height, height],
         c='k', linewidth=lw)

ax.plot([first_quartile, third_quartile], [height, height],
         c='k', linewidth=lw)
ax.plot([first_quartile, third_quartile], [-height, -height],
         c='k', linewidth=lw)

ax.plot([third_quartile, third_quartile*1.2], [0, 0], c='k', linewidth=lw)
ax.plot([third_quartile*1.2, third_quartile*1.5], [0, 0],
         'k--', linewidth=lw)

ax.text(0, -0.5, '0', ha='center')
ax.text(median+.2, -0.6,
         f'{median}',
         ha='center')

ax.text(first_quartile+.5, 0.6,
         f'{first_quartile}',
         ha='center')

ax.text(third_quartile+.1, 0.6,
         f'{third_quartile}',
         ha='center')

ax.axis('off')
pad = .5
ax.set_xlim(0-pad, third_quartile*1.5+pad)
fig
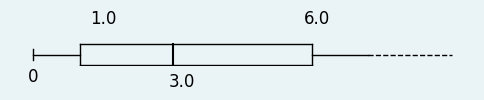
Figura 80 Diagramma a scatola della distribuzione geometrica di parametro \(p = 0.2\).#
20.4.6. Implementazione della distribuzione geometrica#
Un modo intuitivo di simulare l'estrazione di valori da una distribuzione
geometrica consiste nel ripetere l'esecuzione del corrispondente esperimento
bernoulliano, fermandosi quando si ottiene il primo successo e restituendo il
numero di tentativi effettuati. Partendo dalla classe bernoulli implementata
in scipy.stats, è possibile definire in modo semplice la seguente funzione
che permette di simulare una generica distribuzione geometrica, specificando il
valore del corrispondente parametro come argomento.
from scipy.stats import bernoulli

def geom_rv(p):
    """Simulate the extraction of a value from the geometric distribution

    :param p: parameter of the geometric distribution
    :type p: float
    :raises ValueError: if p is not in the interval (0, 1]
    :return: simulated value of the distribution
    :rtype: int
    """
    if p <= 0 or p > 1:
        raise ValueError(f"{p} is not a valid parameter" \
                         " for the geometric distribution.")
    i = 0
    while bernoulli(p) == 0:
        i +=1

    assert i >= 0 and type(i) == int

    return i + 1

[geom_rv(.3) for _ in range(10)]
[1, 1, 1, 1, 1, 1, 1, 1, 1, 1]
Si potrebbe dimostrare che esistono metodi che utilizzano approcci più
efficienti per simulare la distribuzione geometrica, per esempio evitando l'uso
di cicli. È questo l'approccio seguito dalla classe geom fornita dal package
scipy.stats, che nella Figura 81 viene utilizzata
per generare una sequenza in modo analogo a quanto fatto usando la funzione
geom_rv nell'esempio precedente.
from scipy.stats import geom

g = geom(.3, loc=-1)
g.rvs(10)
array([0, 0, 1, 1, 1, 2, 0, 2, 1, 1])
import pandas as pd

fig_sim, ax_sim = plt.subplots()

@when("input", "#p-sim, #m-sim")
def geometric_simulation(event):

    p_sim = float(page['#p-sim'][0].value)
    page['#p-sim-value'][0].innerHTML = f'{p_sim:.1f}'
    m_sim = int(page['#m-sim'][0].value)

    G_sim = st.geom(p_sim, loc=-1)
    x_sim = G_sim.rvs(m_sim)

    freq_sim = pd.Series(x_sim).value_counts(normalize=True)
    freq_sim = freq_sim.reindex(np.arange(0, 11), fill_value=0).values

    ax_sim.clear()
    x_sim = np.arange(11)
    ax_sim.bar(x_sim, freq_sim, facecolor='lightgray', edgecolor='gray', width=.1)

    ax_sim.vlines(x_sim, 0, G_sim.pmf(x_sim))
    ax_sim.plot(x_sim, G_sim.pmf(x_sim), 'o')

    ax_sim.set_xlim(-1, 11)
    ax_sim.set_ylim(0, 1.1)

    display(fig_sim, target='graph-2', append=False)

geometric_simulation(None)
Figura 81 Diagramma a barre delle frequenze di un insieme di osservazioni estratte da un modello geometrico, sovrapposto al diagramma a bastoncini della corrispondente funzione di massa di probabilità.#