
 Italiano
 English
 Français
 Español
18.4. Probabilità condizionata#
Immaginiamo di fissare un esperimento casuale \(\mathscr E\) e definire il corrispondente spazio di probabilità \((\Omega, \mathsf A, \mathbb P)\). Dato un generico evento \(E \in \mathsf A\), se dopo che \(\mathscr E\) è stato eseguito noi sapessimo qual è l'esito \(\omega \in \Omega\) che è stato osservato, sapremmo automaticamente se \(E\) si è verificato oppure no. Immaginiamo di non conoscere con precisione \(\omega\), ma di avere accesso a qualche forma parziale di informazione: più precisamente, supponiamo di sapere che si sia verificato un altro evento \(F\), e — sulla base di questa informazione — di voler valutare se la probabilità di \(E\) ne risulti in qualche modo influenzata.
import matplotlib as mpl
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import Polygon

rosso, blu = np.meshgrid(range(1, 7), range(1, 7))
rosso, blu = rosso.ravel(), blu.ravel()

in_e = rosso + blu >= 8
in_f = blu >= 4
in_intersezione = in_e & in_f
solo_e = in_e & ~in_f
solo_f = in_f & ~in_e
fuori = ~(in_e | in_f)

with mpl.rc_context({'figure.figsize': (3, 3),
           'figure.dpi': 150,
           'figure.titlesize': 8,
           'xtick.labelsize': 7,
           'ytick.labelsize': 7,
           'axes.labelsize': 7,}):

  fig, ax = plt.subplots()

  bg_color = '#eaf3f5'
  fill_color = '#d6e4f7'
  highlight = '#aac5e8'
  dot_color = '#2255aa'
  edge_color = '#333333'

  ax.set_facecolor(bg_color)

  ax.axhspan(3.5, 6.5, facecolor=fill_color, alpha=0.65, zorder=0)
  ax.add_patch(
    Polygon(
      [(1.0, 6.5), (6.5, 6.5), (6.5, 1.0)],
      closed=True,
      facecolor=highlight,
      edgecolor="none",
      alpha=0.6,
      zorder=0,
    )
  )

  ax.axhline(3.5, color=edge_color, linestyle="--", linewidth=1.0, zorder=1)
  ax.plot([1.0, 6.5], [6.5, 1.0], color=edge_color, linestyle="--",
    linewidth=1.0, zorder=1)

  ax.scatter(rosso[fuori], blu[fuori], s=20, c="white",
    edgecolors=edge_color, linewidths=0.5, zorder=3)
  ax.scatter(rosso[solo_e], blu[solo_e], s=20, c=highlight,
    edgecolors=edge_color, linewidths=0.5, zorder=4)
  ax.scatter(rosso[solo_f], blu[solo_f], s=20, c=fill_color,
    edgecolors=edge_color, linewidths=0.5, zorder=4)
  ax.scatter(rosso[in_intersezione], blu[in_intersezione],
    s=20, c=dot_color, edgecolors=edge_color, linewidths=0.5, zorder=5)

  ax.text(1.5, 4.5, r"$F \setminus E$", ha="center", va="center", fontsize=7)
  ax.text(4.5, 5.5, r"$E \cap F$", ha="center", va="center", fontsize=7)
  ax.text(5.85, 2.45, r"$E \setminus F$", ha="center", va="center", fontsize=7)

  ax.set_xlabel("Risultato del dado rosso")
  ax.set_ylabel("Risultato del dado blu")
  ax.set_xticks(range(1, 7))
  ax.set_yticks(range(1, 7))
  ax.set_xlim(0.5, 6.5)
  ax.set_ylim(0.5, 6.8)
  ax.grid(True, color=edge_color, alpha=0.12)
  ax.set_aspect("equal")
  plt.show()
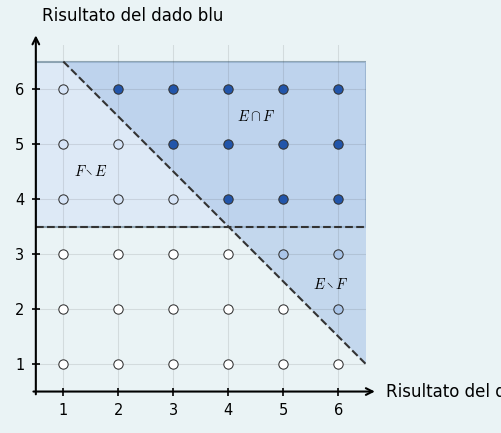
Figura 24 Rappresentazione cartesiana degli eventi \(E =\) «la somma dei due dadi è almeno \(8\)» e \(F =\) «il dado blu mostra almeno \(4\)» nel lancio di due dadi distinguibili. I \(36\) punti della griglia rappresentano gli esiti elementari di \([1 .. 6]^2\).#
Esempio 36
La Figura 24 mostra lo spazio degli esiti nello spazio di probabilità che descrive il risultato del lancio di due dadi bilanciati e distinguibili, uno rosso e uno blu. Nella figura è evidenziato il diagramma di Venn degli eventi \(E =\) «la somma dei due risultati è almeno \(8\)» e \(F =\) «il risultato del dado blu è almeno \(4\)». In particolare, i cerchi rispettivamente al di sopra e a destra delle linee tratteggiate gialla e blu individuano esiti in \(F\) e in \(E\). Applicando la regola classica per il calcolo delle probabilità, si ottiene \(\mathbb P(E) = \frac{5}{12}\): dal diagramma si vede infatti che esattamente quindici dei \(36\) cerchi individuano una somma dei risultati ottenuti che è maggiore o uguale a \(8\). Analogamente, è facile convincersi che \(F\) si può verificare in \(18\) modi diversi, dei quali solo \(12\) portano anche \(E\) a verificarsi. Sapere quindi che \(F\) si è verificato aumenta la probabilità di \(E\), portandola a \(\frac{2}{3}\).
La probabilità condizionata è uno strumento che ci permette di capire quanto, in generale, l'incertezza su un evento \(E\) venga modificata nel momento in cui è noto che un altro evento si è verificato.
Definizione 22 (Probabilità condizionata)
Siano \(E, F \in \mathsf A\) due eventi in uno spazio di probabilità \((\Omega, \mathsf A, \mathbb P)\): se \(\mathbb P(F) \neq 0\) si definisce probabilità condizionata di \(E\) dato \(F\) (o, più brevemente, probabilità di \(E\) dato \(F\)) il rapporto
Quando invece \(\mathbb P(F) = 0\), la probabilità \(\mathbb P(E \mid F)\) è indefinita.
La formula della definzione precedente si può leggere in modo molto concreto: quando sappiamo che \(F\) si è verificato, smettiamo di considerare tutti gli esiti non contenuti in esso (che, per definizione, non possono essere stati osservati) e ridistribuiamo la probabilità totale \(1\) sui soli esiti che restano. In questo senso, la probabilità condizionata non modifica l'evento \(E\), ma cambia l'universo di riferimento nel quale lo stiamo misurando: quello che prima era \(\Omega\), ora è diventato \(F\).
Nota
Fissato un evento \(B\) tale che \(\mathbb P(B) \neq 0\), la funzione che a ogni evento \(A\) associa il valore \(\mathbb P(A \mid B)\) si comporta a tutti gli effetti come una nuova probabilità. In questo senso, condizionare rispetto a \(B\) equivale a introdurre un nuovo spazio di probabilità, nel quale l'universo effettivo è \(B\) e continuano a valere tutte le proprietà generali già viste.
Per esempio, restano validi il teorema sull'evento complementare,
o la formula generale per l'unione di due eventi,
In modo analogo, valgono anche la monotonia e tutte le altre proprietà che discendono dagli assiomi di Kolmogorov, purché si legga la probabilità sempre all'interno del contesto fissato da \(B\).
In uno spazio equiprobabile, la Definizione 22 assume una forma ancora più trasparente:
cioè la probabilità condizionata è semplicemente la proporzione degli esiti di \(F\) che appartengono anche a \(E\).
Esempio 37 (Due dadi e probabilità condizionata)
Riconsiderando lo spazio di probabilità dell’Esempio 36, e gli eventi \(E\) e \(F\), il diagramma di Venn in Figura 24 ci permette di verificare che
\(|F| = 18\), perché per il dado blu ci sono tre valori possibili (\(4\), \(5\) e \(6\)), mentre quello rosso può assumere qualunque valore in \([1 .. 6]\);
\(|E \cap F| = 12\), perché tra questi \(18\) esiti ce ne sono \(12\) in cui la somma è almeno \(8\).
Ne segue che
confermando quanto già ricavato nel precedente esercizio.
Esempio 38 (Una teca di supereroi)
Supponiamo che Nick Fury estragga uniformemente una scheda da una teca che contiene otto personaggi: Iron Man, Thor, Hulk, Black Widow, Superman, Wonder Woman, Batman e Storm. Consideriamo gli eventi \(V =\) «il personaggio sa volare» e \(S =\) «il personaggio ha super-forza». I personaggi in \(V\) sono Iron Man, Thor, Superman e Storm, quindi \(|V| = 4\). Tra questi, quelli che appartengono anche a \(S\) sono Thor e Superman, dunque \(|S \cap V| = 2\). Pertanto
L'informazione «il personaggio sa volare» riduce la nostra attenzione a quattro schede; una volta ristretto l'universo a queste, la domanda diventa semplicemente quale frazione di esse rappresenti un personaggio con super-forza.
18.4.1. Regola di fattorizzazione#
La definizione di probabilità condizionata si può riscrivere moltiplicando i due membri di (18.9) per \(\mathbb P(F)\). In questo modo si ottiene una formula che permette di calcolare la probabilità dell'intersezione di due eventi, fattorizzandola in un prodotto di probabilità.
Teorema 13 (Regola di fattorizzazione)
Siano \(E, F \in \mathsf A\) due eventi. Se \(\mathbb P(F) \neq 0\), allora vale
Se inoltre \(\mathbb P(E) \neq 0\), allora si può scrivere anche
Intuitivamente, la regola di fattorizzazione si legge molto bene da destra verso sinistra: per far sì che si verifichino contemporaneamente \(F\) ed \(E\), può accadere prima \(F\), e poi, nel mondo in cui \(F\) è vero, può accadere anche \(E\). La probabilità dell'intersezione viene quindi scomposta nel prodotto di due termini, uno «esterno» e uno «interno» al caso considerato.
Esempio 39 (Fattorizzare il caso dei due dadi)
Riprendiamo gli eventi dei due esempi precedenti. Siccome lo spazio di probabilità considerato è equiprobabile, ispezionando il diagramma di Venn della Figura 24 si ottiene
Analogamente, dall’Esempio 37 sappiamo che \(\mathbb P(E \mid F) = \frac{12}{18} = \frac{2}{3}\): applicando la regola di fattorizzazione otteniamo pertanto
Il risultato coincide con il conteggio diretto degli esiti nell'intersezione \(E \cap F\), che sono \(12\) su \(36\). Il vantaggio della fattorizzazione è che il calcolo diventa naturale anche quando non è immediato conteggiare il numero di esiti nell'intersezione, ed è più facile ragionare prima nei termini di uno degli eventi, considerando poi quello rimanente, condizionandone l'osservazione a quella del primo.
18.4.2. Teorema delle probabilità totali#
Oltre che per calcolare la probabilità dell'intersezione di eventi, la regola di fattorizzazione è utile quando vogliamo determinare \(\mathbb P(E)\) distinguendo casi diversi. Cominciamo dal caso più semplice, in cui lo spazio degli esiti è suddiviso in due parti distinte, descritte da un evento \(F\) e dal suo complementare \(\overline{F}\). In questa situazione, ogni modo in cui può verificarsi \(E\) ricade necessariamente in uno dei due casi \(E \cap F\) oppure \(E \cap \overline{F}\). Più precisamente,
per la proprietà distributiva dell'intersezione sull'unione, si ha \((E \cap F) \cup (E \cap \overline{F}) = E \cap (F \cup \overline{F}) = E \cap \Omega = E\);
l'associatività e la commutatività dell'intersezione implicano \((E \cap F) \cap (E \cap \overline{F}) = E \cap (F \cap \overline{F}) = E \cap \varnothing = \varnothing\).
In altre parole, \(E\) si può esprimere come l'unione dei due eventi disgiunti \(E \cap F\) ed \(E \cap \overline{F}\), e dal terzo assioma di Kolmogorov si ottiene
come evidenziato nella Figura 25. Se inoltre \(0 < \mathbb P(F) < 1\), applicando la regola di fattorizzazione ai due addendi otteniamo
che rappresenta l'enunciato della forma più semplice del teorema delle probabilità totali. Questa formula permette di calcolare la probabilità di un evento relativamente complesso, che diventa più facile da gestire quando lo si considera a fronte del risultato di un altro evento, che lo condiziona. Più precisamente, lo spazio campionario viene suddiviso in due casi mutuamente esclusivi che esauriscono tutte le possibilità, e la probabilità di \(E\) si ottiene sommando i contributi di tutti questi casi.
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon
from myst_nb import glue

MATH_SIZE = 9
EDGE_COLOR = '#333333'
BG_COLOR = '#eaf3f5'
FILL_COLOR = '#d6e4f7'
HIGHLIGHT = '#aac5e8'
BOX_X0, BOX_Y0 = 0.2, 0.2
BOX_W, BOX_H = 11.6, 7.6

E_XY = (6.0, 4.0)
E_W, E_H = 6.6, 4.1
LINE_TOP = (5.2, BOX_Y0 + BOX_H)
LINE_BOTTOM = (6.15, BOX_Y0)

fig, ax = plt.subplots(facecolor=BG_COLOR)
ax.set_facecolor(BG_COLOR)
ax.set_aspect('equal')
ax.axis('off')
ax.set_xlim(0, 12)
ax.set_ylim(0, 8)

ax.add_patch(FancyBboxPatch((BOX_X0, BOX_Y0), BOX_W, BOX_H,
                            boxstyle='square,pad=0',
                            facecolor=BG_COLOR, edgecolor=EDGE_COLOR,
                            linewidth=1.1, zorder=0))

left_clip = Polygon([
  (BOX_X0, BOX_Y0),
  (BOX_X0, BOX_Y0 + BOX_H),
  LINE_TOP,
  LINE_BOTTOM,
], closed=True, facecolor='none', edgecolor='none')
right_clip = Polygon([
  LINE_TOP,
  (BOX_X0 + BOX_W, BOX_Y0 + BOX_H),
  (BOX_X0 + BOX_W, BOX_Y0),
  LINE_BOTTOM,
], closed=True, facecolor='none', edgecolor='none')
ax.add_patch(left_clip)
ax.add_patch(right_clip)

left_part = Ellipse(xy=E_XY, width=E_W, height=E_H,
          facecolor=FILL_COLOR, edgecolor='none', zorder=1)
right_part = Ellipse(xy=E_XY, width=E_W, height=E_H,
           facecolor=HIGHLIGHT, edgecolor='none', zorder=1)
ax.add_patch(left_part)
ax.add_patch(right_part)
left_part.set_clip_path(left_clip)
right_part.set_clip_path(right_clip)

ax.add_patch(Ellipse(xy=E_XY, width=E_W, height=E_H,
                      facecolor='none', edgecolor=EDGE_COLOR,
                      linewidth=1.2, zorder=4))
ax.plot([LINE_TOP[0], LINE_BOTTOM[0]], [LINE_TOP[1], LINE_BOTTOM[1]],
    color=EDGE_COLOR, linewidth=1.2, zorder=4)

ax.text(11.5, 7.5, r'$\Omega$', fontsize=MATH_SIZE, ha='right', va='top')
ax.text(11, 0.7, r'$F$', fontsize=MATH_SIZE, ha='center')
ax.text(1., 0.7, r'$\overline{F}$', fontsize=MATH_SIZE, ha='center')
ax.text(8.9, 5.8, r'$E$', fontsize=MATH_SIZE, ha='center')
ax.text(4.35, 3.73, r'$E \cap F$', fontsize=MATH_SIZE, ha='center')
ax.text(7.5, 3.73, r'$E \cap \overline{F}$', fontsize=MATH_SIZE, ha='center')

plt.tight_layout()
glue('prob-totali-binario', fig, display=False)
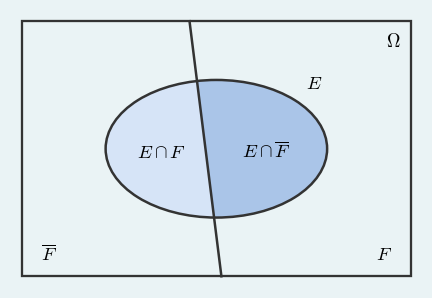
Figura 25 Diagramma di Venn per la forma più semplice del teorema delle probabilità totali. Gli eventi \(F\) e \(\overline{F}\) formano una partizione di \(\Omega\), mentre l'evento \(E\) si scompone nell'unione disgiunta di \(E \cap F\) ed \(E \cap \overline{F}\).#
Esempio 40
Un osservatorio segreto monitora le missioni di alcuni individui dell'universo di Heroes, allo scopo di individuare e prevenire paradossi temporali. In particolare, le missioni vengono divise in due categorie:
missioni ad alta instabilità, affidate a personaggi delle cui azioni è difficile prevedere l'effetto (come Hiro Nakamura, che manipola spazio e tempo, o Peter Petrelli, che può replicare i poteri delle persone vicine);
missioni a instabilità moderata, gestite da personaggi con poteri più controllabili (per esempio Claire Bennet, che è in grado di rigenerarsi, o Matt Parkman, che possiede capacità telepatiche).
La probabilità che si verifichi un paradosso temporale è \(0.35\) per le missioni ad alta instabilità e \(0.1\) in quelle a instabilità moderata. Inoltre, un quarto di tutte le missioni è ad alta instabilità.
La probabilità dell'evento \(P\) che si verifica quando durante una missione viene generato un paradosso temporale si può calcolare applicando (18.11):
In altre parole, anche se solo una parte relativamente piccola delle missioni coinvolge poteri molto instabili, questi incidono molto sul rischio complessivo perché hanno una probabilità decisamente più alta di generare paradossi temporali.
from matplotlib.patches import Ellipse, FancyBboxPatch, Polygon

MATH_SIZE = 9
EDGE_COLOR = '#333333'
BG_COLOR = '#eaf3f5'
PART_COLORS = ['#d6e4f7', '#c5d8f0', '#aac5e8', '#8eb3dc']
BOX_X0, BOX_Y0 = 0.2, 0.2
BOX_W, BOX_H = 11.6, 7.6

E_XY = (6.0, 4.0)
E_W, E_H = 8.8, 4.0
TOP_X = [BOX_X0, 3.6, 5.7, 7.9, BOX_X0 + BOX_W]
BOTTOM_X = [BOX_X0, 4.4, 6.4, 8.6, BOX_X0 + BOX_W]

fig, ax = plt.subplots(facecolor=BG_COLOR)
ax.set_facecolor(BG_COLOR)
ax.set_aspect('equal')
ax.axis('off')
ax.set_xlim(0, 12)
ax.set_ylim(0, 8)

ax.add_patch(FancyBboxPatch((BOX_X0, BOX_Y0), BOX_W, BOX_H,
              boxstyle='square,pad=0',
              facecolor=BG_COLOR, edgecolor=EDGE_COLOR,
              linewidth=1.1, zorder=0))

clips = []
for index in range(4):
  clip = Polygon([
      (TOP_X[index], BOX_Y0 + BOX_H),
      (TOP_X[index + 1], BOX_Y0 + BOX_H),
      (BOTTOM_X[index + 1], BOX_Y0),
      (BOTTOM_X[index], BOX_Y0),
  ], closed=True, facecolor='none', edgecolor='none')
  ax.add_patch(clip)
  clips.append(clip)

for color, clip in zip(PART_COLORS, clips):
  part = Ellipse(xy=E_XY, width=E_W, height=E_H,
          facecolor=color, edgecolor='none', zorder=1)
  ax.add_patch(part)
  part.set_clip_path(clip)

ax.add_patch(Ellipse(xy=E_XY, width=E_W, height=E_H,
            facecolor='none', edgecolor=EDGE_COLOR,
            linewidth=1.2, zorder=4))

for top_x, bottom_x in zip(TOP_X[1:-1], BOTTOM_X[1:-1]):
  ax.plot([top_x, bottom_x], [BOX_Y0 + BOX_H, BOX_Y0],
          color=EDGE_COLOR, linewidth=1.2, zorder=4)

ax.text(11.5, 7.5, r'$\Omega$', fontsize=MATH_SIZE, ha='right', va='top')
ax.text(2.0, 0.7, r'$F_1$', fontsize=MATH_SIZE, ha='center')
ax.text(4.95, 0.7, r'$F_2$', fontsize=MATH_SIZE, ha='center')
ax.text(7.35, 0.7, r'$F_3$', fontsize=MATH_SIZE, ha='center')
ax.text(10.2, 0.7, r'$F_4$', fontsize=MATH_SIZE, ha='center')
ax.text(2.0, 5.65, r'$E$', fontsize=MATH_SIZE, ha='center')
ax.text(2.9, 3.8, r'$E \cap F_1$', fontsize=MATH_SIZE, ha='center')
ax.text(5.1, 3.8, r'$E \cap F_2$', fontsize=MATH_SIZE, ha='center')
ax.text(7.1, 3.8, r'$E \cap F_3$', fontsize=MATH_SIZE, ha='center')
ax.text(9.15, 3.8, r'$E \cap F_4$', fontsize=MATH_SIZE, ha='center')

plt.tight_layout()
glue('prob-totali-partizione', fig, display=False)
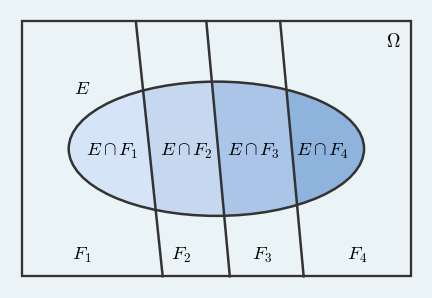
Figura 26 Diagramma di Venn schematico per il teorema delle probabilità totali, quando viene considerata la partizione \(\mathcal P = \{ F_1, F_2, F_3, F_4 \}\) di \(\Omega\).#
La formulazione generale del teorema delle probabilità totali estende il ragionamento fatto finora, considerando più di due possibili alternative. Come evidenziato nella Figura 26, ciò equivale a ragionare nei termini di una partizione \(\mathcal P\) di \(\Omega\). Anche in questo caso, ogni parte di \(E\) sarà contenuta al più in uno e un solo blocco della partizione, e la probabilità si ottiene sommando i contributi dei blocchi di quest'ultima.
Teorema 14 (Teorema delle probabilità totali)
Sia \(\mathcal P = \{ F_1, \dots, F_n \}\) una partizione di \(\Omega\) composta da eventi \(F_i \in \mathsf A\), tali che \(\mathbb P(F_i) \neq 0\), per ogni \(i = 1, \dots, n\). Fissato un generico \(E \in \mathsf A\), vale
Dimostrazione.
Come si evince anche dalla Figura 26, per ogni \(i \neq j\) si ha \((E \cap F_i) \cap (E \cap F_j) = E \cap (F_i \cap F_j) = E \cap \varnothing = \varnothing\), tenuto conto dell'associativitià e della commutatività dell'intersezione. Inoltre, considerando la distributività dell'intersezione sull'unione, si ha
il che permette di esprimere \(E\) come l'unione di eventi disgiunti, e dunque di calcolarne la probabilità come
Per ogni \(i = 1, \dots, n\) si ha per ipotesi \(\mathbb P(F_i) \neq 0\), e la regola di fattorizzazione implica \(\mathbb P(E \cap F_i) = \mathbb P(E \mid F_i) \mathbb P(F_i)\), da cui si ottiene la tesi.
Anche in questo caso, la scelta di \(\mathcal P\) rappresenta una parte molto importante del ragionamento: bisogna considerare una partizione che rende il calcolo delle probabilità condizionate \(\mathbb P(E \mid F_i)\) più facile rispetto a quella di \(\mathbb P(E)\).
Esempio 41 (Scegliere un dado tra tre)
Consideriamo tre dadi bilanciati a sei facce: il primo è un dado ordinario con le facce numerate da \(1\) a \(6\); il secondo ha le facce numerate come \(1\), \(3\), \(4\), \(5\), \(5\) e \(6\); il terzo ha le facce numerate con \(2\), \(4\), \(5\), \(5\), \(6\) e \(6\). Indichiamo con \(D_1\), \(D_2\) e \(D_3\) gli eventi che si verificano, rispettivamente, quando viene scelto il primo, il secondo e il terzo dado, e supponiamo che le relative probabilità siano \(\mathbb P(D_1) = \frac{1}{2}\), \(\mathbb P(D_2) = \frac{1}{3}\) e \(\mathbb P(D_3) = \frac{1}{6}\).
Immaginiamo di selezionare uno dei tre dadi con queste probabilità, e di lanciarlo. Sia \(E =\) «il risultato del lancio è almeno \(5\)». Allora
Poiché \(\{ D_1, D_2, D_3 \}\) è una partizione dello spazio degli eventi che non contiene l'insieme vuoto, apllicando il teorema delle probabilità totali si ottiene
La formula finale nell'esempio precedente mette in risalto un'altra interpretazione del teorema delle probabilità totali: la probabilità di \(E\) si può esprimere come la media delle tre probabilità condizionate, pesata rispetto alle probabilità degli eventi \(D_1\), \(D_2\) e \(D_3\).
Esempio 42 (Volare, distinguendo per universo narrativo)
Consideriamo nove schede che descrivono Iron Man, Thor, Hulk, Black Widow, Wolverine, Storm, Batman, Superman e Invincible, e immaginiamo di selezionarne una dopo averle mischiate, in modo che ogni scheda abbia la stessa probabilità di essere estratta. Sia \(V =\) «la scheda riguarda un eroe che sa volare», e immaginiamo di volerne calcolare la probabilità. Consideriamo la seguente suddivisione dello spazio campionario in tre sottoinsiemi:
\(M =\) «è stata estrata la scheda di un eroe Marvel» (dunque uno tra i primi sei nell'elenco iniziale);
\(D =\) «è stata estrata la scheda di un eroe DC» (Batman o Superman);
\(I =\) «è stata estrata la scheda di un eroe Image Comics» (che deve necessariamente essere Invincible, perché è l'unico eroe Image Comics nell'elenco).
È chiaro che \(\{ M, D, I \}\) rappresenta una partizione di \(\Omega\), con
dunque una partizione che permette di considerare l'applicazione del teorema delle probabilità totali, in quanto nessun evento ha probabiltà nulla. Inoltre,
tra i personaggi Marvel volano Iron Man, Thor e Storm, dunque \(\mathbb P(V \mid M) = 3/6 = 1/2\);
tra i personaggi DC vola solo Superman, quindi \(\mathbb P(V \mid D) = 1/2\);
l'unico personaggio Image è Invincible, che vola, quindi \(\mathbb P(V \mid I) = 1\).
Applicando il teorema delle probabilità totali otteniamo
Naturalmente, si otterrebbe il medesimo risultato anche contando direttamente quanti tra i personaggi elencati sanno volare, e applicando la regola classica per il calcolo delle probabilità. Il vantaggio del teorema delle probabilità totali è quello di organizzare il calcolo per casi: un'idea che tornerà utile ogni volta che le probabilità condizionate risultano più facili da calcolare rispetto alla probabilità che non conosciamo.
Esempio 43
Il Professor X sospetta che alcuni allievi della scuola ospitata nella X-mansion abbiano usato le proprie abilità per alterare i risultati degli esami di fine anno. Per farsi un'idea di quanti tra essi lo abbiano fatto, senza esporre nessuno, organizza la seguente rilevazione: in un'urna vengono poste cento sfere, numerate da uno a \(100\). Ogni allievo estrae una sfera e osserva il numero riportato, senza che nessuno possa sapere di quale numero si tratti. Se tale numero è minore o uguale a \(70\), allora l'allievo risponde alla domanda «Hai usato i tuoi poteri per cambiare il risultato dell'esame?». Altrimenti, risponde alla domanda di controllo «Il numero che hai estratto è pari?». In entrambi i casi, la risposta deve essere «sì» oppure «no» e la sfera deve essere reinserita nell'urna. Questo modo di procedere garantisce che, anche conoscendo la risposta data da ogni singolo studente, il Prof. X non possa sapere a quale domanda si riferisce. Così facendo, vengono incentivate risposte sincere, in funzione dell'anonimità garantita dal protocollo adottato.
Ipotizzando che l'estrazione delle sfere avvenga in un contesto equiprobabile, la probabilità dell'evento \(C =\) «è stata data risposta alla domanda di controllo» è \(\frac{3}{10}\). Indichiamo con \(S\) l'evento «si osserva una risposta affermativa». Poiché tra le cento sfere ce ne sono cinquanta con un numero pari e cinquanta con un numero dispari, si ha \(\mathbb P(S \mid C) = \frac{1}{2}\). Infine, \(\{ C, \overline C \}\) è una partizione dello spazio degli eventi che non contiene \(\varnothing\), quindi il teorema delle probabilità totali ci dice che
ovvero \(\mathbb P(S) = \frac{1}{2} \cdot \frac{3}{10} + \mathbb P(S \mid \overline C) \cdot \frac{7}{10}\), o equivalentemente
Supponiamo ora che, al termine del sondaggio, \(25\) risposte su \(100\) siano «sì». Nell'accezione frequentista della probabilità, e assumendo che il numero complessivo di risposte sia abbastanza grande, possiamo considerare la frequenza relativa osservata, \(\frac{25}{100} = \frac{1}{4}\), come una buona approssimazione di \(\mathbb P(S)\). Sostituendo questo valore in (18.13) otteniamo \(\mathbb P(S \mid \overline C) \approx \frac{1}{7}\), il che suggerisce che circa un settimo degli allievi abbia usato i propri poteri per alterare il risultato dell'esame (approssimativamente il \(14 \%\)).
Metodo della risposta randomizzata
Il procedimento illustrato in questo esempio è noto come metodo della risposta randomizzata [Warner, 1965]. Si tratta di una tecnica di rilevazione statistica progettata per raccogliere dati veritieri su argomenti delicati, nei quali il timore di essere riconosciuti può indurre i partecipanti a mentire o a rifiutarsi di rispondere. Esempi di argomenti delicati includono:
il consumo di sostanze stupefacenti o l'abuso di alcol;
l'evasione fiscale o i comportamenti illegali sul lavoro;
le pratiche sessuali a rischio;
episodi di bullismo o di violenza subita;
l'uso scorretto di risorse accademiche (plagio, copiatura).
Il principio è semplice: un meccanismo casuale nel quale i rispondenti hanno fiducia (come il lancio di una moneta o l'estrazione da un'urna) decide ogni volta quale domanda riceve un partecipante. Chi somministra il sondaggio conosce solo la risposta («sì» oppure «no»), non la domanda, e quindi non può risalire al comportamento del singolo. In questo modo, la sincerità è incentivata strutturalmente, e non affidata alla buona volontà.
È importante sottolineare che (18.13) è un'identità esatta quando si conosce davvero \(\mathbb P(S)\). Nell'esempio, però, \(\mathbb P(S)\) viene rimpiazzata con la frequenza relativa delle risposte affermative, assumendo che il numero complessivo di risposte sia abbastanza grande perché, in ottica frequentista, tale frequenza approssimi bene la probabilità corrispondente. In questo passaggio il valore risultante potrebbe, in linea di principio, essere minore di \(0\) o maggiore di \(1\). Ciò avviene tipicamente quando il numero di risposte raccolte non è sufficientemente elevato, ma anche quando il numero di risposte affermative osservate è troppo lontano da quello atteso sotto le ipotesi del modello.
Esempio 44
Il quartiere di Wertham è sorvegliato da tre squadre di Misfits, formate in anni diversi nel corso dei servizi sociali obbligatori. Il prospetto seguente indica le percentuali degli interventi gestite da ciascuna squadra, unitamente al tasso di interventi che si concludono in modo disastroso — per colpa dei poteri ancora non padroneggiati.
Squadra |
Componenti |
Quota di interventi |
Tasso di disastri |
|---|---|---|---|
A |
Nathan, Simon, Alisha, Kelly e Curtis |
55 % |
3 % |
B |
Rudy e Seth |
30 % |
4 % |
C |
Finn, Jess e Abbey |
15 % |
5 % |
Indichiamo con \(A\), \(B\) e \(C\) gli eventi che corrispondono al fatto che un intervento sia stato gestito dalla squadra omonima, e con \(D\) l'evento «l'intervento si è concluso in modo disastroso». Le probabilità dei primi tre eventi si ricavano immediatamente dal prospetto precedente: \(\mathbb P(A) = 0.55\), \(\mathbb P(B) = 0.30\) e \(\mathbb P(C) = 0.15\). La probabilità di \(D\) si può ricavare a partire da queste ultime, applicando il teorema delle probabilità totali. Infatti \(\{ A, B, C \}\) è una partizione dello spazio degli esiti, in quanto ogni intervento è affidato a una e una sola squadra. I dati a disposizione definiscono inoltre la probabilità di un intervento disastroso, condizionato rispetto alla squadra che lo ha preso in carico: \(\mathbb P(D \mid A) = 0.03\), \(\mathbb P(D \mid B) = 0.04\) e \(\mathbb P(D \mid C) = 0.05\). Nessuna delle probabilità degli eventi condizionanti è nulla, quindi
La probabilità che un intervento scelto a caso si concluda in modo disastroso corrisponde al \(3.6 \%\) del totale. Ciò è dovuto al fatto che la squadra C, che è quella meno efficiente, ha un peso sul totale degli interventi molto ridotto (\(15 \%\)) e contribuisce solo per \(0.75\) punti percentuali al risultato finale. È invece la squadra A — quella più affidabile — a pesare di più sul risultato complessivo, proprio perché gestisce la maggioranza degli interventi. Intuitivamente, quando si è in presenza di più fonti, il rischio complessivo dipende non solo dai tassi specifici di ciascuna di esse, ma anche dalla loro quota di contributo al totale.
18.4.3. Teorema di Bayes#
Le formule viste finora permettono di calcolare quantità come \(\mathbb P(E \mid F)\), cioè la probabilità di \(E\) quando sappiamo che vale \(F\). È importante però non attribuire automaticamente a questa scrittura un significato temporale: condizionare rispetto a \(F\) non vuol dire necessariamente che prima accada \(F\) e poi accada \(E\). Più spesso, il legame tra i due eventi è di natura causale, piuttosto che temporale: \(F\) rappresenta un'ipotesi, una causa o una condizione che aiuta a spiegare perché \(E\) sia più o meno plausibile. Proprio per questo ha senso anche scambiare i due ruoli. In molte situazioni conosciamo infatti la probabilità dell'effetto \(E\) sotto una certa ipotesi \(F\), cioè \(\mathbb P(E \mid F)\), ma dopo avere osservato \(E\) vogliamo risalire a quanto diventi plausibile l'ipotesi stessa, cioè a \(\mathbb P(F \mid E)\).
Esempio 45
Supponiamo di essere coinvolti in una campagna di test clinici, volti a valutare la presenza di una specifica condizione (per esempio un'infezione, una carenza ormonale o una mutazione genetica). Indichiamo con \(C\) l'evento che si verifica quando la condizione è presente in un individuo, e con \(P\) l'evento che corrisponde a un test positivo su un individuo. Di solito si conosce bene \(\mathbb P(P \mid C)\), cioè la probabilità che il test individui la condizione quando essa è davvero presente. Per chi riceve il referto, però, la domanda più interessante è quella inversa: se il test è positivo, qual è la probabilità che la condizione ci sia davvero, cioè quanto vale \(\mathbb P(C \mid P)\)? In questo caso non stiamo invertendo un ordine temporale, ma un nesso esplicativo: la condizione, se presente, spiega la positività del test, e dall'effetto osservato cerchiamo di risalire alla possibile causa.
Il teorema di Bayes permette di calcolare le probabilità condizionate proprio quando si effettua questo cambio di prospettiva. Nella formulazione più semplice, il condizionamento viene fatto in termini di due possibili opzioni, come indicato nel teorema seguente.
Teorema 15 (Teorema di Bayes I)
Siano \(E, F \in \mathsf A\) due eventi tali che \(\mathbb P(E) \neq 0\) e \(0 < \mathbb P(F) < 1\). Allora
Dimostrazione.
Dalla definizione di probabilità condizionata, applicando la regola di fattorizzazione si ottiene
e poiché \(\{ F, \overline{F} \}\) è una partizione di \(\Omega\) che permette l'applicazione del teorema delle probabilità totali,
Sostituendo questa espressione nel denominatore si ottiene la tesi.
La formula alla base del teorema si può interpretare nel modo seguente. Il numeratore valuta quanto è probabilità che \(E\) si verifichi simultaneamente all'ipotesi \(F\). Il denominatore confronta questo contributo con quello dell'ipotesi alternativa, che coinvolge \(\overline{F}\). Se \(E\) è molto più probabile sotto l'ipotesi \(F\) che sotto \(\overline{F}\), allora l'osservazione di \(E\) tende ad aumentare il valore di \(\mathbb P(F \mid E)\). Viceversa, se è più probabile osservare \(E\) in concomitanza con \(\overline{F}\), il verificarsi del primo evento andrà a diminuire la probabilità condizionata.
Figura 27 Ritratto ritenuto raffigurare Thomas Bayes (Autore ignoto, attribuzione del soggetto incerta. Immagine di pubblico dominio. Fonte: Wikimedia Commons).#
Nomenclatura
L’espressione teorema di Bayes fa riferimento a Thomas Bayes, ministro presbiteriano e matematico inglese, presumibilmente ritratto[1] nella Figura 27. Il risultato è associato al suo saggio postumo An Essay Towards Solving a Problem in the Doctrine of Chances [Bayes, 1763], comunicato alla Royal Society nel 1763 dal suo amico Richard Price. La forma oggi più diffusa è però il frutto di successive riformulazioni e generalizzazioni, dovute in particolare a Pierre-Simon Laplace. Per questo, nella letteratura si incontrano anche le espressioni formula di Bayes, regola di Bayes e, talvolta, formula o teorema di Bayes-Laplace.
Esempio 46 (Un test clinico)
Riprendendo l’Esempio 45, supponiamo che:
la condizione oggetto del test sia presente in un generico individuo con probabilità \(\mathbb P(C) = 0.001\) (cioè nel \(0.1 \%\) dei casi);
il test sia positivo nel \(99 \%\) dei casi in cui la condizione è presente, cioè \(\mathbb P(P \mid C) = 0.99\);
il tasso di falsi positivi del test sia dell’\(1 \%\), cioè \(\mathbb P(P \mid \overline{C}) = 0.01\).
Applicando il teorema di Bayes si ricava la probabilità \(\mathbb P(C \mid P)\):
Quindi, a fronte di un test positivo, la probabilità che la condizione sia presente in un individuo è solo di circa il \(9\%\). Il punto cruciale è che la condizione resta molto rara nella popolazione, e quindi i falsi positivi, pur pochi in termini relativi, possono superare i veri positivi in valore assoluto. Anche in questo caso, non stiamo invertendo una sequenza temporale: il test positivo è l'evidenza osservata, mentre la condizione è l'ipotesi causale a cui vogliamo risalire.
Il risultato può sembrare sorprendente, e infatti viene talvolta presentato come un piccolo paradosso: è un caso tipico di ciò che si discute sotto il nome di fallacia del tasso di base. Un test che sembra molto affidabile non basta, da solo, a rendere probabile una condizione che è per sua natura molto rara. L'interpretazione frequentista può aiutare a comprendere meglio questo punto. Se immaginiamo di sottoporre al test \(2\,000\) individui, ci aspettiamo in media che la condizione sia presente in circa due persone (lo \(0.1 \%\) di \(2\,000\)). Di queste, il \(99 \%\) risulterà positivo: i conti ci dicono che dovrebbero essere \(0.99 \cdot 2 = 1.98\) individui, ma dobbiamo pensare in termini di numeri interi. Arrotondiamo quindi il risultato e diciamo che saranno positivi al test entrambi gli individui. Nei restanti \(1998\), la condizione non è presente, ma il tasso di falsi positivi fa sì che venga erroneamente rilevata in venti di essi — anche in questo caso, il numero previsto dalla formula sarebbe \(0.01 \cdot 1\,998 = 19.98\), ma va arrotondato. Concludendo, ci aspettiamo circa \(22\) test positivi, a fronte di due soli individui in cui la condizione è presente: calcolando il rapporto tra questi valori si ottiene \(2/22 \approx 9\%\), che è coerente con il valore di \(\mathbb P(C \mid P)\) ottenuto applicando il teorema di Bayes.
Esempio 47 (Due dadi: Bayes con due ipotesi)
Riconsideriamo l'esperimento che consiste nel lanciare due dadi bilanciati e distinguibili, e in particolare gli eventi \(E =\) «la somma dei due risultati è almeno \(8\)» e \(F =\) «il dado blu mostra almeno \(4\)». Nell’Esempio 37 abbiamo visto che \(\mathbb P(E \mid F) = \frac{2}{3}\), e dalla Figura 24 è facile convincersi del fatto che \(\mathbb P(F) = \frac{1}{2}\). Immaginiamo di voler calcolare \(\mathbb P(F \mid E)\), e cioè la probabilità che il risultato del dado blu sia almeno \(4\), sapendo che la somma dei risultati è maggiore o uguale a otto. Per applicare il teorema di Bayes è necessario valutare preventivamente \(\mathbb P(E \mid \overline F)\): sempre ispezionando il diagramma di Venn, si vede che dei diciotto esiti nei quali il risultato del dado blu è al più uguale a \(3\), solamente per \((6, 2)\), \((5, 3)\) e \((6, 3)\) la somma è almeno \(8\) solo in , quindi \(\mathbb P(E \mid \overline{F}) = \frac{1}{6}\), e
Quindi, sapendo che la somma è almeno \(8\), la probabilità che il dado blu abbia mostrato almeno \(4\) è pari a \(4/5\).
L'esempio precedente mostra che, in generale, \(\mathbb P(E \mid F) \neq \mathbb P(F \mid E)\): nel caso in questione, infatti, \(\mathbb P(E \mid F) = 2/3\), mentre \(\mathbb P(F \mid E) = 4/5\).
Il risultato del teorema di Bayes si estende facilmente al caso in cui il condizionamento riguardi più di due ipotesi possibili. Il ragionamento da seguire resta lo stesso, ma al posto della coppia \(F\), \(\overline{F}\) si considera una generica partizione dello spazio degli esiti.
Teorema 16 (Teorema di Bayes II)
Sia \(\mathcal P = \{ F_1, \dots, F_n \}\) una partizione di \(\Omega\) i cui blocchi sono membri dell'algebra \(\mathsf A\) e hanno probabilità non nulla. Se \(E \in \mathsf A\) è un evento tale che \(\mathbb P(E) \neq 0\), allora per ogni \(i = 1, \dots, n\) vale
Dimostrazione.
Partendo dalla definizione di probabilità condizionata, sfruttando la commutatività dell'intersezione e applicando la regola di fattorizzazione si ha
Poiché \(\mathcal P\) permette di applicare il teorema delle probabilità totali, si ha che
e sostituendo questa espressione nel denominatore della formula precedente si ottiene la tesi.
Esempio 48 (Un personaggio volante di quale editore è?)
Riconsideriamo le schede dell’Esempio 42, in cui abbiamo indicato con \(M\), \(D\) e \(I\) gli eventi che corrispondono rispettivamente all'estrazione di un personaggio Marvel, DC e Image Comics, e con \(V\) l'evento «il personaggio sa volare». Abbiamo già visto che
Siccome \(\{ M, D, I \}\) formano una partizione di \(\Omega\) che permette l'applicazione del teorema di Bayes, avremo
e analogamente \(\mathbb P(D \mid V) = \frac{1}{5}\) e \(\mathbb P(I \mid V) = \frac{1}{5}\). Sapere che il personaggio vola ci permette quindi di aggiornare la nostra valutazione iniziale sull'editore, come evidenziato nello schema che segue.
Marvel |
DC |
Image Comics |
|
|---|---|---|---|
Incondizionata |
\(0.67\) |
\(0.22\) |
\(0.11\) |
Condizionata a \(V\) |
\(0.6\) |
\(0.2\) |
\(0.2\) |
La Marvel resta l'ipotesi più probabile, ma i rapporti tra le tre alternative sono cambiati: ora Image comics e DC sono equiprobabili, mentre a priori il secondo editore aveva una probabilità doppia rispetto al primo.
Più in generale, questo modo di leggere il teorema di Bayes costituisce uno dei fondamenti dell’inferenza bayesiana. In questa prospettiva, una situazione nella quale si possono verificare due o più opzioni, associate ad altrettanti eventi \(F_1, \dots, F_n\), viene modellata dapprima tramite delle probabilità a priori, che quantificano il grado di plausibilità che si ipotizza per queste opzioni sulla base di informazioni inizialmente disponibili. A seguito del verificarsi di un evento \(E\) — detto evidenza — e partendo dai valori di verosimiglianza \(\mathbb P(E \mid F_1), \dots, \mathbb P(E \mid F_n)\), che misurano quanto l'evidenza osservata sia compatibile con le ipotesi, si utilizza il teorema di Bayes perottenere le probabilità a posteriori \(\mathbb P(F_1 \mid E), \dots, \mathbb P(F_n \mid E)\), che permettono di aggiornare le probabilità delle varie ipotesi, incorporando l'informazione portata dall'evidenza \(E\).
Come ho già sottolineato, il punto concettuale essenziale in questo passaggio sistematico da una valutazione a priori ad una a posteriori delle probabilità non è l'inversione di una successione temporale di eventi, bensì la revisione della conoscenza disponibile in un dato istante, sulla base di nuova informazione: si parte da un quadro iniziale di plausibilità, si osservano nuovi dati e si ridistribuisce in modo razionale il peso assegnato alle ipotesi concorrenti. In questa prospettiva, una valutazione a posteriori ottenuta in un dato momento può a sua volta diventare la valutazione a priori in una fase successiva, qualora siano disponibili ulteriori osservazioni. È questa dinamica di aggiornamento a caratterizzare l'approccio bayesiano e a renderlo centrale in molti problemi di classificazione, diagnosi e inferenza statistica.
Esempio 49 (Un indizio nell'Umbrella Academy)
Immaginiamo di dover stabilire quale tra i sette fratelli Hargreeves abbia lasciato un messaggio anonimo nella casa dell’Umbrella Academy. Indichiamo con \(C\) l'ipotesi «l'autore del messaggio è Numero Cinque». Possiamo adottare come valutazione iniziale, cioè prima di osservare il contenuto del messaggio, l'ipotesi che ciascuno dei sette fratelli sia ugualmente plausibile come autore; in tal caso \(\mathbb P(C) = \frac{1}{7}\) e \(\mathbb P(\overline{C}) = \frac{6}{7}\). Ipotizziamo ora che il messaggio che osserviamo contenga dei riferimenti precisi a salti temporali e a linee temporali alternative, e indichiamo con \(E\) l'evento corrispondente. Siccome, tra tutti i fratelli, solo Numero Cinque ha il potere di viaggiare tra diverse linee temporali, così che per esempio \(\mathbb P(E \mid C) = 0.9\), mentre \(\mathbb P(E \mid \overline{C}) = 0.05\). Applicando il teorema di Bayes si ottiene
L'osservazione del messaggio porta quindi a rivedere drasticamente la valutazione iniziale: l'ipotesi che l'autore sia Numero Cinque passa da \(1/7 \approx 14.3\%\) a \(3/4 = 75\%\). Questo esempio mostra bene che, in ottica bayesiana, la nuova informazione non sostituisce arbitrariamente la valutazione iniziale, ma la trasforma in modo controllato alla luce della maggiore o minore compatibilità dell'evidenza con le ipotesi in gioco.
Esempio 50
Carol Danvers rileva un segnale di soccorso Kree di origine incerta. Potrebbe provenire da uno di tre pianeti, indicati di seguito, ognuno con la probabilità inizialmente stimata.
Pianeta |
Probabilità a priori |
|---|---|
Hala |
\(1/2\) |
Torfa |
\(1/3\) |
Kree-Lar |
\(1/6\) |
Carol raggiunge inizialmente Hala, e non riesce a intercettare il segnale. Le tempeste solari nel sistema planetario generano interferenze magnetiche su Hala, che fanno sì che, anche se il segnale provenisse davvero da lì, lei riuscirebbe a localizzarlo con probabilità \(1 - \alpha\) — dove \(\alpha \in [0, 1]\) modella l'intensità di tali tempeste.
Alla luce di queste informazioni, possiamo usare il teorema di Bayes per rivedere le probabilità a priori inizialmente considerate. Definiamo rispettivamente con \(H\), \(T\) e \(K\) gli eventi che si verificano quando il segnale proviene da Hala, Torfa o Kree-Lar, e sia \(E =\) «la ricerca del segnale su Hala ha dato esito negativo». Sicuramente, \(\mathbb P(E \mid H) = \alpha\) (è la probabilità di non rilevare il segnale su Hala, nel caso in cui il segnale provenga effettivamente da quel pianeta). Inoltre, \(\mathbb P(E \mid T) = \mathbb P(E \mid K) = 1\), perché quando si cerca di localizzare il segnale su Hala, sicuramente l'operazione avrà esito negativo se questo proviene da un altro pianeta. Sulla base di queste probabilità e di quelle a priori, il teorema delle probabilità totali permette di calcolare
Infine, dal teorema di Bayes si ottiene
Va notato che il valore di \(\alpha\) modifica notevolmente il modo in cui l'esito negativo della scansione aggiorna le probabilità:
se \(\alpha \to 0\), le interferenze su Hala sono trascurabili, quindi diventa impossibile che il segnale provenga da questo pianeta, mentre la probabilità che arrivi da Torfa è doppia rispetto a Kree-Lar (in proporzione alle probabilità a priori);
se invece \(\alpha \to 1\), le interferenze rendono la scansione inutile: l'esito della ricerca su Hala non aggiunge informazione e le probabilità a posteriori restano invariate.
18.4.4. Vero o falso?#
Analizzate ciascuna delle seguenti affermazioni sulla probabilità condizionata, e dite se è vera o falsa, motivando il vostro ragionamento. Cliccate su di essa per visualizzare la risposta corretta.
Per qualunque coppia di eventi con probabilità non nulla, \(\mathbb P(E \mid F) = \mathbb P(F \mid E)\).
Falsa. In generale le due quantità sono diverse: dalla Definizione 22 è facile verificare che le due probabilità coincidono solo quando \(\mathbb P(E) = \mathbb P(F)\).
Se \(E\) e \(F\) sono mutuamente esclusivi e \(\mathbb P(F) \neq 0\), allora \(\mathbb P(E \mid F) = 0\).
Vera. Se \(E \cap F = \varnothing\), allora \(\mathbb P(E \cap F) = 0\) e dunque, per la Definizione 22,
Intuitivamente, sapere che \(F\) si è verificato riduce l’universo di riferimento a \(F\), e se \(E\) e \(F\) non hanno esiti in comune, in questo nuovo universo \(E\) risulta impossibile.
Fissato un evento \(F\) con \(\mathbb P(F) \neq 0\), la funzione \(E \mapsto \mathbb P(E \mid F)\) è una funzione di probabilità su \((\Omega, \mathsf A)\).
Vera. Come mostrato nella nota al paragrafo sulla probabilità condizionata, \(\mathbb P(\cdot \mid F)\) soddisfa tutti e tre gli assiomi di Kolmogorov: la non-negatività segue da quella di \(\mathbb P\), la normalizzazione vale perché \(\mathbb P(\Omega \mid F) = \mathbb P(\Omega \cap F) / \mathbb P(F) = 1\) e l’additività per eventi disgiunti si trasferisce in modo diretto dalla probabilità originale.
La probabilità condizionata \(\mathbb P(E \mid F)\) è definita anche quando \(\mathbb P(F) = 0\).
Falsa. La Definizione 22 richiede esplicitamente
\(\mathbb P(F) \neq 0\), perché altrimenti il rapporto in eq-prob-cond
avrebbe denominatore nullo. Dietro questo problema formale si nasconde il fatto
che la definizione di probabilità condizionata consiste nel restringere la
probabilità all'evento \(F\) e poi rinormalizzarla dividendo per \(\mathbb P(F)\).
Se \(\mathbb P(F)=0\), tale rinormalizzazione non è possibile.
Il teorema delle probabilità totali richiede che ogni blocco della partizione abbia probabilità non nulla.
Vera. Il Teorema 14 richiede esplicitamente \(\mathbb P(F_i) \neq 0\) per ogni \(i\). Questa ipotesi è necessaria perché la dimostrazione si basa sulla regola di fattorizzazione \(\mathbb P(E \cap F_i) = \mathbb P(E \mid F_i)\mathbb P(F_i)\), che richiede a sua volta che la probabilità condizionata \(\mathbb P(E \mid F_i)\) sia definita.
Conoscere \(\mathbb P(E \mid F)\) e \(\mathbb P(F)\) è sufficiente per calcolare \(\mathbb P(E)\).
Falsa. La regola di fattorizzazione (introdotta nel Teorema 13) permette di ricavare \(\mathbb P(E \cap F) = \mathbb P(E \mid F)\mathbb P(F)\), ma per ottenere \(\mathbb P(E)\) serve anche il contributo di \(E\) al di fuori di \(F\). Ciò è evidente, per esempio, nella forma del teorema delle probabilità totali espressa in (18.11):
cioè occorre conoscere anche \(\mathbb P(E \mid \overline{F})\) e \(\mathbb P(\overline{F})\).
18.4.5. Esercizi#
Esercizio 127 (•)
Considerate l'esperimento del lancio di due dadi bilanciati e distinguibili, soffermandovi sugli eventi \(A =\) «la somma dei due risultati è uguale a \(7\)» e \(B =\) «il dado blu mostra un numero pari». Verificate che \(\mathbb P(A \mid B) \neq \mathbb P(B \mid A)\).
Solution to Esercizio 127 (•)
L'evento \(B\) contiene \(18\) esiti, perché il dado blu può mostrare \(2\), \(4\) o \(6\), mentre il dado rosso è arbitrario. Tra questi, quelli in cui la somma è \(7\) sono \((5, 2)\), \((3, 4)\) e \((1, 6)\), dunque
Analogamente, \(A\) contiene invece i sei esiti \((1, 6)\), \((2, 5)\), \((3, 4)\), \((4, 3)\), \((5, 2)\) e \((6, 1)\).` Tra questi, quelli in cui il dado blu è pari sono ancora tre, quindi
I due valori sono dunque diversi.
Esercizio 128 (••)
Consideriamo lo schedario dell’Esempio 38, che contiene le otto schede dedicate a Iron Man, Thor, Hulk, Black Widow, Superman, Wonder Woman, Batman e Storm. Siano \(V\) ed \(S\), rispettivamente, gli eventi «il personaggio può volare» e «il personaggio ha super-forza».
Calcolate \(\mathbb P(V)\) e \(\mathbb P(S \mid V)\).
Usate la regola di fattorizzazione per determinare \(\mathbb P(S \cap V)\).
Verificate il risultato del punto precedente con un conteggio diretto.
Solution to Esercizio 128 (••)
I personaggi che possono volare sono Iron Man, Thor, Superman e Storm, quindi
Tra questi, quelli con super-forza sono Thor e Superman, dunque
La regola di fattorizzazione fornisce allora
Il conteggio diretto conferma il risultato, perché i personaggi che stanno in \(S \cap V\) sono esattamente due su otto.
Esercizio 129 (••)
Nel lancio di due dadi distinguibili di colore blu e rosso, considerate gli eventi che seguono:
Sia inoltre \(E\) l'evento «la somma dei due risultati è almeno \(9\)».
Mostrate che \(\mathcal P = \{ F_1, F_2, F_3 \}\) è una partizione dello spazio degliesiti.
Calcolate \(\mathbb P(E \mid F_1)\), \(\mathbb P(E \mid F_2)\) e \(\mathbb P(E \mid F_3)\).
Usate il teorema delle probabilità totali per ricavare \(\mathbb P(E)\).
Verificate il risultato ottenuto al punto precedente con un conteggio diretto degli esiti favorevoli.
Solution to Esercizio 129 (••)
Ogni evento \(F_i\) contiene \(12\) esiti, quindi ha probabilità \(1/3\).
\(F_1 = \{ (i, j) \mid i \in [1 .. 2], j \in [1 .. 6] \}\), \(F_2 = \{ (i, j) \mid i \in [3 .. 4], j \in [1 .. 6] \}\) e \(F_3 = \{ (i, j) \mid i \in [5 .. 6], j \in [1 .. 6] \}\), dunque l'unione di questi tre eventi è \(\Omega\). Valutando i primi elementi delle coppie ordinate, si vede facilmente che \(F_i \cap F_j\) ogni volta che \(i \neq j\), quindi \(\mathcal P\) è effettivamente una partizione di \(\Omega\).
Se il risultato del dado blu è al massimo \(2\), la somma dei due risultati non può eccedere \(8\), pertanto \(\mathbb P(E \mid F_1) = 0\). Quando invece il valore del dado blu è \(3\) oppure \(4\), gli esiti \((6, 3)\), \((5, 4)\) e \((6, 4)\), portano a una somma maggiore o uguale a \(9\), e dunque \(\mathbb P(E \mid F_2) = \frac{1}{4}\). Se infine otteniamo \(5\) oppure \(6\) per il dado blu, gli esiti \((5, j)\) per \(j \in [4 .. 6]\) e \((6, j)\) per \(j \in [3 .. 6]\) sono contenuti in \(E\), così che \(\mathbb P(E \mid F_3) = \frac{7}{12}\).
Applicando il teorema delle probabilità totali si ottiene
Gli esiti in \(E\) sono quelli per cui la somma dei risultati dei due dadi è \(9\), \(10\), \(11\) o \(12\). Come si può vedere dallo schema sottostante, il numero di esiti possibile per questi valori della somma è, rispettivamente, quattro, tre, due e uno. In totale, si tratta di dieci esiti, il che porta a \(\mathbb P(E) \frac{5}{18}\).
Somma
Esiti
\(9\)
\((3, 6), (4, 5), (5, 4), (6, 3)\)
\(10\)
\((4, 6), (5, 5), (6, 5)\)
\(11\)
\((5, 6), (6, 5)\)
\(12\)
\((6, 6)\)
Esercizio 130 (•••)
Torniamo alla schede dell’Esempio 38, e indichiamo con \(M\) l'evento «la scheda estratta è Marvel» e con \(V\) l'evento «il personaggio sa volare».
Calcolate \(\mathbb P(M)\) e \(\mathbb P(\overline{M})\).
Calcolate \(\mathbb P(V \mid M)\) e \(\mathbb P(V \mid \overline{M})\).
Usate il teorema di Bayes per determinare \(\mathbb P(M \mid V)\).
Interpretate il risultato ottenuto.
Solution to Esercizio 130 (•••)
Tra le otto schede, quelle di Iron Man, Thor, Hulk, Black Widow e Storm fanno riferimento a eroi Marvel, quindi \(\mathbb P(M) = \frac{5}{8}\) e \(\mathbb P(\overline{M}) = \frac{3}{8}\).
Tra i cinque personaggi Marvel, quelli che volano sono Iron Man, Thor e Storm, perciò \(\mathbb P(V \mid M) = \frac{3}{5}\). D'altro canto, le schede degli altri supereroi fanno riferimento a Superman, Wonder Woman e Batman, e solo il primo vola, quindi \(\mathbb P(V \mid \overline{M}) = \frac{1}{3}\).
Applicando il teorema di Bayes si ottiene
Sapere che il personaggio vola rende quindi l'ipotesi Marvel la più plausibile, ma non abbastanza da renderla certa: resta infatti una probabilità del \(25 \%\) che la scheda appartenga a un personaggio non Marvel.
Esercizio 131 (•••)
Riconsiderate l’129, e calcolate
\(\mathbb P(F_1 \mid E)\),
\(\mathbb P(F_2 \mid E)\),
\(\mathbb P(F_3 \mid E)\),
verificando che queste tre probabilità sommino a \(1\).
Solution to Esercizio 131 (•••)
Dall’esercizio precedente sappiamo che \(\mathbb P(F_i) = \frac{1}{3}\) per ogni \(i \in [1 .. 3]\), e che \(\mathbb P(E \mid F_1) = 0\), \(\mathbb P(E \mid F_2) = \frac{1}{4}\), \(\mathbb P(E \mid F_3) = \frac{7}{12}\) e \(\mathbb P(E) = \frac{5}{18}\). Pertanto
analogamente
e infine
Sommando le tre probabilità si ottiene
18.4.6. Concetti fondamentali#
Pensate ai concetti fondamentali illustrati in questo paragrafo ed elencateli. Nella lista qui sotto sono già presenti gli stessi concetti, ma nascosti. Cliccate sul pulsante per mostrarli sotto forma di parole chiave, quindi confrontateli con la vostra lista. Provate infine a descrivere ciascun concetto con parole vostre.