
 Italiano
 English
 Français
 Español
19.5. Momenti *#
Nel Paragrafo 19.3 abbiamo visto come descrivere una distribuzione tramite un valore numerico che ne individua la posizione lungo l'asse reale, mentre il Paragrafo 19.4 ha introdotto un approccio analogo, basato sulla dispersione dei valori della distribuzione. Si tratta, anche considerando i due indici congiuntamente, di una descrizione utile, ma parziale: due variabili aleatorie possono condividere per esempio valore atteso e varianza e avere comunque distribuzioni molto diverse. Una può essere simmetrica e l'altra sbilanciata verso destra; una può concentrare quasi tutta la massa vicino al centro e affidare a due code sottili i valori lontani da esso, mentre l'altra la può distribuire in modo più uniforme. Per cogliere queste (e altre) differenze, si può proseguire nella stessa direzione che ci ha portato a ottenere la varianza di una variabile aleatoria \(X\). Quest'ultima nasce infatti dal valore atteso dello scarto quadratico \((X - \mu)^2\), ma nulla vieta di considerare potenze superiori, ottenendo così un'intera famiglia di indici che permettono di descrivere la distribuzione di una variabile aleatoria con un livello di dettaglio via via crescente.
Questo paragrafo è dedicato a introdurre questa famiglia di indici, che prendono il nome di momenti, focalizzandosi in particolare su due di essi: l'asimmetria e la curtosi, unitamente alle proprietà che catturano; viene inoltre introdotta la funzione generatrice dei momenti, uno strumento che permette di calcolare tutti i momenti di una distribuzione in modo sistematico.
19.5.1. Momenti di una variabile aleatoria#
L'idea alla base del calcolo di un momento è semplice: si estende il concetto di valore atteso di una variabile, eventualmente centrata, considerando però le sue possibili potenze a esponente intero.
Definizione 40 (Momenti)
Siano \(X\) una variabile aleatoria discreta e \(n \in \mathbb N\). Si dice momento di ordine \(n\) (o momento \(n\)-esimo) di \(X\) il valore atteso
quando la corrispondente somma converge assolutamente. Se inoltre \(X\) ammette valore atteso \(\mu = \mathbb E(X)\), si dice momento centrale di ordine \(n\) (o momento centrale \(n\)-esimo) la quantità
qualora tale valore atteso esista.
_
Come già accennato nel Paragrafo 19.3, le notazioni \(\mu_n\), \(\mu'_n\) e il nome stesso di momento risalgono a Karl Pearson (vedi Figura 44), che li introdusse alla fine del \(1800\) prendendo a prestito la terminologia della meccanica, in cui il momento primo di una distribuzione di masse corrisponde al loro baricentro, mentre il momento secondo rispetto al baricentro individua il momento d'inerzia. Va inoltre notato come, a differenza di altri indici, non risulta specificata la variabile aleatoria coinvolta: ciò è dovuto al fatto che vengono già utilizzati un apice e un pedice, quindi sarebbe necessario ricorrere a una notazione piuttosto pesante, per esempio indicando la variabile tra parentesi.
Per una fissata variabile aletoria discreta \(X\), entrambi i tipi di momenti si calcolano applicando il Teorema 25 alla funzione \(x \mapsto x^n\), oppure a \(x \mapsto (x - \mu)^n\).
Esempio 109
Se una qualsiasi variabile aleatoria \(X\) ammette valore atteso \(\mu\), allora \(\mu'_1 = \mathbb E(X^1) = \mathbb E(X) = \mu\): il momento primo esiste e coincide con il valore atteso della variabile aleatoria. Inoltre, il momento centrale di ordine \(1\) è sempre nullo, poiché \(\mu_1 = \mathbb E(X - \mu) = \mathbb E(X) - \mu = 0\), come visto nel Paragrafo 19.3.
Esempio 110
Il momento centrale di ordine \(2\) di una variabile aleatoria \(X\), qualora esista, è uguale a \(\operatorname{Var}(X)\). Per definizione, infatti, \(\mu_2 = \mathbb E((X - \mu)^2) = \operatorname{Var}(X)\), dove \(\mu = \mathbb E(X)\). Inoltre, il valore di questo momento è legato a quelli dei momenti primo e secondo: dal Teorema 27 si ottiene infatti
L'ultimo punto nell'esempio precedente si può generalizzare a momenti di ordine qualsiasi: sviluppando la potenza \((X - \mu)^n\) con (A.10) e applicando la linearità del valore atteso si ottiene, per ogni \(n \in \mathbb N\),
cioè il momento centrale di un dato ordine si può sempre ricavare a partire dai momenti di ordine minore o uguale. Vale anche il viceversa, con un'espressione del tutto analoga:
Come per il valore atteso e per la varianza, l'esistenza non è garantita: quando il supporto è infinito la somma che definisce un momento può non convergere assolutamente. Si può però dimostrare che se esiste il momento di ordine \(k\) allora esistono anche tutti quelli di ordine inferiore, cosicché i momenti «si perdono» sempre a partire da un certo ordine in poi[1].
Esempio 111
Nei suoi spostamenti, Speedball converte l'energia cinetica in rimbalzi: più precisamente, se \(X\) indica il numero di rimbalzi necessari per attraversare una stanza, si ha \(S_X = \{0, 1, 2\}\) e \(p_X(0) = 0.2\), \(p_X(1) = 0.5\) e \(p_X(2) = 0.3\). I momenti di ordine \(1\) e \(2\) della corrispondente distribuzione sono
dai quali si ricava \(\mu_2 = 1.7 - 1.1^2 = 0.49\). Il momento centrale di ordine \(3\) richiede invece di elevare al cubo gli scarti:
Il segno negativo non è casuale: lo scarto negativo in corrispondenza di \(x = 0\) è meno probabile di quello positivo che si ha in \(x = 3\), ma è anche più grande in valore assoluto, e l'elevamento al cubo fa prevalere il primo.
19.5.2. Asimmetria e curtosi#
L'Esempio 111 mostra che il momento centrale di ordine \(3\) porta con sé un'informazione che valore atteso e varianza non contengono: l'eventuale sbilanciamento della distribuzione, e in particolare il verso di questo sbilanciamento: se il momento terzo è positivo, diventa più probabile osservare dei valori della variabile aleatoria a destra del suo valore atteso; se è negativo, lo sbilanciamento tende a manifestarsi nella direzione opposta. Utilizzare però direttamente il valore di questo momento centrale introdurrebbe un problema di scala. I momenti (centrali o semplici) di ordine \(k\) sono espressi nell'unità di misura di \(X\) elevata alla \(k\). Pertanto, \(\operatorname{Var}(X)\) quadruplica quando si raddoppiano i valori di \(X\) (vedi il Teorema 28), e in generale \(\mu_k\) viene moltiplicato per \(2^k\). Confrontare i momenti di due distribuzioni diverse (per esempio per comparare il loro sbilanciamento) è quindi possibile solo dopo averli resi adimensionali, e il modo naturale per farlo consiste nel dividerli per la corrispondente potenza della deviazione standard.
Definizione 41 (Momenti standardizzati)
Sia \(X\) una variabile aleatoria che ammette momento centrale di ordine \(k\) e deviazione standard \(\sigma\). Si dice momento standardizzato di ordine \(k\) il rapporto \(\mu_k / \sigma^k\).
Per rendere adimensionale i momenti si potrebbe usare anche il valore atteso della distribuzione. La deviazione standard però è decisamente più adeguata, perché misura la scala tipica degli scostamenti dal centro. Inoltre, è insensibile alle traslazioni e non si annulla necessariamente per distribuzioni non degeneri. Dividere il momento centrale di ordine \(k\) per \(\sigma^k\) equivale così a calcolarlo sulla standardizzazione di \(X\), rendendolo indipendente dall'origine e dall'unità di misura.
È facile verificare che i momenti standardizzati del primo e del secondo ordine sono sempre uguali a zero e a uno, indipendentemente dalla variabile aleatoria considerata. I due ordini successivi, invece, caratterizzano due aspetti rilevanti di una distribuzione. Come già accennato, partendo da \(\mu_3\) è possibile valutarne l'asimmetria, e il corrispondente momento standardizzato prende appunto il nome di asimmetria.
Definizione 42 (Asimmetria)
L'asimmetria (o skewness) di una variabile aleatoria \(X\) che ammette il momento centrale terzo è la quantità
dove \(\sigma\) indica la deviazione standard di \(X\).
Essendo basato sull'operazione di standardizzaizone, \(\gamma_1\) è adimensionale, e soprattutto non cambia se si modifica la variabile aleatoria di partenza applicando una trasformazione affine. In altre parole, questo indice descrive la forma della distribuzione, ed è indipendente dalla sua centralità o dalla dispersione dei valori. Il suo valore si legge nel modo seguente:
l'asimmetria è nulla per ogni distribuzione simmetrica rispetto al proprio valore atteso;
un valore positivo di \(\gamma_1\) indica che la coda a destra della distribuzione (le parti laterali che si assottigliano via via che ci si allontana dalla zona in cui si concentra la maggior parte della massa di probabilità) è più lunga o più pesante di quella sinistra, e si dice allora che la distribuzione è asimmetrica verso destra;
un valore negativo, infine, delinea la situazione opposta rispetto al punto precedente.
Esempio 112
Intuitivamente, la distribuzione dell'esito del lancio di un dado bilianciato a sei facce non dovrebbe presentare alcuna asimmetria. Nell'Esempio 77 abbiamo ricavato che il valore atteso di questa distribuzione vale \(\tfrac{7}{2}\). Per ricavare il momento centrale di ordine terzo, sarebbe necessario calcolare quindi
che, seppure si possa ottenere sviluppando manualmente il cubo e applicando le formule elencate nell'Appendice A, è più pratico ottenere tramite codice:
in forma numerica, usando i tipi di dati nativi di Python:
sum([(i - 7/2)**3 / 6 for i in range(1, 7)])
0.0
oppure in modo esatto, tramite
sympy:
import sympy as sp

sum([(sp.Integer(i) - sp.Rational(7, 2))**3 / 6 for i in range(1, 7)])
ottenendo in entrambi i casi un momento nullo. Pertanto, l'asimmetria della distribuzione sarà \(\gamma_1 = 0\), come era ragionevole aspettarsi.
Esempio 113
Sia \(𝟙_E\) la variabile aleatoria indicatrice di un evento \(E\), con \(\mathbb P(E) = p\). Come ricavato nel Teorema 24 e nell'Esempio 97, \(\mathbb E(𝟙_E) = p\) e \(\operatorname{Var}(𝟙_E) = p(1 - p)\). Pertanto
e conseguentemente l'asimmetria della variabile aleatoria è uguale a
Esempio 114
Songbird solidifica le proprie onde sonore in costrutti che reggono un numero aleatorio \(Y\) di secondi, con \(S_Y = \{1, 2, 4\}\) e \(p_Y(1) = \frac{1}{6}\), \(p_Y(2) = \frac{3}{4}\), \(p_Y(4) = \frac{1}{12}\). Il valore atteso è quindi
mentre i momenti centrali di ordine due e tre valgono
Pertanto la deviazione standard è \(\sigma = \sqrt 2 / 2\) e \(\gamma_1 = \frac{1}{2} \frac{4}{\sqrt{2}} = \sqrt 2\), a indicare un'assimetria verso destra: ciò è dovuto al fatto che il valore \(4\), pur essendo raro, risulta essere abbastanza lontano dal valore atteso per sbilanciare la distribuzione.
La Figura 54 mostra il grafico della funzione di massa di probabilità della distribuzione dell'esempio precedente, permettendo di modificare la posizione del valore più a destra del supporto, indicato con \(x\), ma lasciando invariate le masse di probabilità. Ogni volta che il valore viene spostato, l'asimmetria viene ricalcolata.
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


probabilities_skw = np.array([1 / 6, 3 / 4, 1 / 12])
initial_rightmost_skw = 4.0

fig_skw, ax_skw = plt.subplots()

values_skw = np.array([1.0, 2.0, initial_rightmost_skw])
stem_lines_skw = ax_skw.vlines(values_skw, 0, probabilities_skw, color='C0')
point_markers_skw, = ax_skw.plot(values_skw, probabilities_skw, 'o',
                                 color='C0')
mean_marker_skw, = ax_skw.plot([probabilities_skw @ values_skw], [0.02],
                               marker='^', color='#cc6600', clip_on=False,
                               zorder=3)

x_label_skw = ax_skw.annotate(r'$x$',
                              xy=(values_skw[2], probabilities_skw[2]),
                              xytext=(0, 7), textcoords='offset points',
                              ha='center', va='bottom', fontsize=9)

ax_skw.set_ylabel(r'$p_Y$')
ax_skw.set_xlim(0, 5.5)
ax_skw.set_ylim(0, 0.85)
ax_skw.set_xticks(range(6))

ax_skw.set_axisbelow(True)
ax_skw.grid(color='lightgray', linestyle='-', linewidth=0.5, alpha=0.7)


def render_skw_plot():
  rightmost = float(page['#skw-rightmost'][0].value)
  values = np.array([1.0, 2.0, rightmost])

  mean = probabilities_skw @ values
  variance = probabilities_skw @ (values - mean) ** 2
  third = probabilities_skw @ (values - mean) ** 3
  skewness = third / variance ** 1.5

  stem_lines_skw.set_segments(
      [np.array([[x, 0], [x, p]])
       for x, p in zip(values, probabilities_skw)])
  point_markers_skw.set_data(values, probabilities_skw)
  mean_marker_skw.set_data([mean], [0.02])
  x_label_skw.xy = (values[2], probabilities_skw[2])

  page['#skw-rightmost-value'][0].innerHTML = f'{rightmost:.2f}'
  page['#skw-skewness'][0].innerHTML = f'{skewness:+.2f}'

  display(fig_skw, target='graph-1', append=False)


@when('input', '#skw-rightmost')
def update_skw_plot(event):
  render_skw_plot()


render_skw_plot()
Figura 54 Grafico della funzione di massa di probabilità dell'Esempio 114, in cui la posizione del valore \(x\) più a destra è controllato dal selettore, che permette di rigenerare il grafico e aggiornare il valore dell'asimmetria. Il triangolo indica il valore atteso della distribuzione.#
La Figura 55 mostra come la simmetria di una distribuzione sia un aspetto completamente diverso rispetto a quelli che abbiamo visto finora. A destra viene visualizzata la funzione di massa di probabilità dell'Esempio 114, mentre a sinistra è presente un analogo grafico, ottenuto a partire da una distribuzione che ha lo stesso valore atteso e la stessa varianza dell'esempio, ma asimmetria opposta.
import matplotlib.pyplot as plt

distributions = [
  (r'$\gamma_1 = -\sqrt{2}$', [0, 2, 3], [1 / 12, 3 / 4, 1 / 6]),
  (r'$\gamma_1 = +\sqrt{2}$', [1, 2, 4], [1 / 6, 3 / 4, 1 / 12]),
]

fig, axes = plt.subplots(1, 2, figsize=(5, 1.5), sharey=True)

for ax, (title, values, probabilities) in zip(axes, distributions):
  ax.vlines(values, 0, probabilities, color='C0')
  ax.plot(values, probabilities, 'o', color='C0')
  ax.plot([2], [0.02], marker='^', color='#cc6600', clip_on=False, zorder=3)
  ax.set_title(title)
  ax.set_xlabel('$x$')
  ax.set_xlim(-0.5, 4.5)
  ax.set_ylim(0, 0.85)

axes[0].set_ylabel('$p_X$')

plt.show()
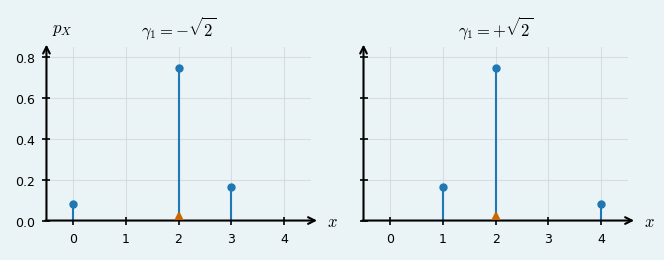
Figura 55 Due distribuzioni con lo stesso valore atteso (indicato dal triangolo) e la stessa varianza, ma con asimmetria negativa e positiva, rispettivamente a sinistra e a destra.#
Anche il quarto momento di una distribuzione fornisce informazioni utili sulla sua forma complessiva, ma in modo diverso rispetto al terzo momento: mentre l'asimmetria descrive uno sbilanciamento tra i due lati della distribuzione, il quarto momento è sensibile alla presenza di valori molto distanti dal centro e, più in generale, al comportamento delle code. Per questo motivo esso è spesso usato per caratterizzare quanto una distribuzione sia concentrata attorno ai valori centrali oppure, al contrario, quanto tenda a presentare code più pesanti o più leggere. Questa idea introduce in modo naturale il concetto di curtosi, come indicato di seguito.
Definizione 43 (Curtosi)
Si chiama curtosi di una variabile aleatoria \(X\) che ammette il quarto momento centrale la quantità
dove \(\sigma\) indica la deviazione standard di \(X\).
_
Il termine kurtosis, da cui deriva l'italiano curtosi, fu anch'esso coniato da Karl Pearson (vedi Figura 44), che lo introdusse nel 1905 rifacendosi al greco antico κύρτωσις (kýrtōsis secondo la traslitterazione ISO 843), traducibile come «curvatura», «convessità» o «rigonfiamento». Secondo l'interpretazione originale, infatti, questo indice dovrebbe valutare quanto l'andamento dei valori di probabilità in una distribuzione sia «appuntito» piuttosto che «piatto». Sebbene questa intuizione si sia poi rivelata parziale e potenzialmente fuorviante, la terminologia è rimasta in uso.
La curtosi fu inizialmente proposta nello studio delle frequenze empiriche. Semplificando un po' il discorso, se le frequenze degli esiti di un esperimento hanno un andamento unimodale, cioè crescono fino a un massimo per poi diminuire, ha senso chiedersi se questo picco venga raggiunto e superato più o meno repentinamente. E un discorso analogo vale per le distribuzioni di probabilità. Come accennato nel riquadro precedente, il significato attribuito al momento quarto era legato a questa interpretazione, che si è però rivelata incompleta. La curtosi, infatti, non descrive la forma del picco, ma è particolarmente sensibile a ciò che succede nella periferia della distribuzione. Poiché gli scarti dal valore atteso vengono elevati alla quarta potenza, i valori molto lontani da esso esercitano un'influenza particolarmente forte sul valore di \(\gamma_2\). Come termine di confronto viene presa una famiglia di distribuzioni di particolare rilevanza nel calcolo delle probabilità e nella statistica: quella delle distribuzioni normali, che studieremo nel Paragrafo 21.4. Il loro momento quarto standardizzato è sempre uguale a \(3\), indipendentemente dalla particolare distribuzione scelta all'interno della famiglia. La Definizione 43 sottrae precisamente questo valore a \(\mu_4 / \sigma^4\), così che la curtosi di una variabile aleatoria \(X\) confronta il suo momento quarto standardizzato con quello di una distribuzione normale avente lo stesso valore atteso e la stessa deviazione standard. In questo senso, fornisce un'indicazione di quanto i valori lontani dal valore atteso siano influenti rispetto a ciò che accadrebbe nella distribuzione normale:
quando \(\gamma_2 > 0\), i valori estremi assumono un peso maggiore rispetto al caso normale, e la distribuzione di \(X\) si dice leptocurtica;
se \(\gamma_2 = 0\), le code hanno la stezza rilevanza che avrebbero nel caso normale, e la distribuzione si dice mesocurtica;
infine, \(\gamma_2 < 0\) individua una distribuzione platicurtica: gli estremi hanno una rilevanza minore rispetto a quanto succede per la normale.
Curtosi ed eccesso di curtosi
Alcuni testi utilizzano una nomenclatura più raffinata, definendo la curtosi come il momento quarto standardizzato e l'eccesso di curtosi come la differenza tra questa e il valore \(3\), in modo da enfatizzare la variazione rispetto al caso di una distribuzione normale. È importante tenere a mente questa possibilità, soprattutto quando si calcola la curtosi utilizzando delle librerie software.
Esempio 115
Sia \(𝟙_E\) la variabile aleatoria dell'Esempio 113. Siccome
la curtosi sarà è uguale a
Esempio 116
Per la distribuzione della variabile aleatoria \(Y\) descritta nell'Esempio 114 si ha
tenendo conto del fatto che la deviazione standard è \(\sigma = \sqrt 2 / 2\), si ricava
Il valore positivo della curtosi evidenzia l'importanza del punto di massa \(x = 4\) che, nonostante minimizzi la funzione di massa di probabilità, è relativamente lontano dal valore atteso (dista esattamente il doppio rispetto all'estremo inferiore della distribuzione).
Le distribuzioni in Figura 55 rappresentano in realtà due membri di una stessa famiglia, il cui generico elemento si ottiene partendo dalla variabile \(Y\) dell'Esempio 114, spostando il valore più a destra del supporto e ridistribuendo la massa di probabilità in modo da tenere fissi valore atteso e varianza. La Figura 56 permette di visualizzare le distribuzioni in questa famiglia: spostando il selettore, viene traslato in modo corrispondente il valore indicato come \(x\), rigenerando il grafico della funzione di massa di probabilità e ricalcolando i valori di asimmetria e curtosi.
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


fig_shape, ax_shape = plt.subplots()
initial_v_shape = 2.0


def distribution_shape(v):
  """Supporto {1, 2, 2+v} con valore atteso 2 e varianza 1/2."""
  left_mass = 1 / (2 * (1 + v))
  right_mass = 1 / (2 * v * (1 + v))
  values = np.array([1.0, 2.0, 2.0 + v])
  probabilities = np.array([left_mass, 1 - left_mass - right_mass, right_mass])
  return values, probabilities


values_shape, probabilities_shape = distribution_shape(initial_v_shape)
stem_lines_shape = ax_shape.vlines(values_shape, 0, probabilities_shape,
                                   color='C0')
point_markers_shape, = ax_shape.plot(values_shape, probabilities_shape, 'o',
                                     color='C0')
mean_marker_shape, = ax_shape.plot([2], [0.02], marker='^', color='#cc6600',
                                   clip_on=False)

x_label_shape = ax_shape.annotate(r'$x$',
                                  xy=(values_shape[2], probabilities_shape[2]),
                                  xytext=(0, 7), textcoords='offset points',
                                  ha='center', va='bottom', fontsize=9)

ax_shape.set_ylabel(r'$p_X$')
ax_shape.set_xlim(0, 5.5)
ax_shape.set_ylim(0, 1.0)
ax_shape.set_xticks(range(6))

ax_shape.set_axisbelow(True)
ax_shape.grid(color='lightgray', linestyle='-', linewidth=0.5, alpha=0.7)


def render_shape_plot():
  rightmost = float(page['#shape-v'][0].value)
  values, probabilities = distribution_shape(rightmost - 2)

  mean = probabilities @ values
  variance = probabilities @ (values - mean) ** 2
  third = probabilities @ (values - mean) ** 3
  fourth = probabilities @ (values - mean) ** 4
  skewness = third / variance ** 1.5
  kurtosis = fourth / variance ** 2 - 3

  stem_lines_shape.set_segments(
      [np.array([[x, 0], [x, p]]) for x, p in zip(values, probabilities)])
  point_markers_shape.set_data(values, probabilities)
  x_label_shape.xy = (values[2], probabilities[2])

  page['#shape-v-value'][0].innerHTML = f'{rightmost:.2f}'
  page['#shape-skewness'][0].innerHTML = f'{skewness:+.2f}'
  page['#shape-kurtosis'][0].innerHTML = f'{kurtosis:+.2f}'

  display(fig_shape, target='graph-2', append=False)


@when('input', '#shape-v')
def update_shape_plot(event):
  render_shape_plot()


render_shape_plot()
Figura 56 Grafici della funzione di massa di probabilità di una famiglia di distribuzioni con valore atteso \(2\) e varianza \(\frac{1}{2}\), qualunque sia la posizione del valore indicato con \(x\). Spostando il selettore, viene rigenerato il grafico, aggiornando i valori di asimmetria e curtosi. Per \(x = 4\) si ritrova la distribuzione dell'Esempio 114, mentre all'estremo sinistro la massa di probabilità del valore intermedio si annulla e il supporto della distribuzione si riduce a due soli valori.#
Asimmetria e curtosi sintetizzano la forma di una distribuzione con due soli numeri, e questo suggerisce di rappresentare ognuna di esse come un punto del piano di coordinate \((\gamma_1, \gamma_2)\), che viene detto piano asimmetria-curtosi. Le famiglie di distribuzioni che studieremo nei Capitoli 20 e 21 dipendono da uno o più parametri: al variare di questi ultimi, pertanto, il punto che indica una particolare distribuzione della famiglia descrive un un luogo geometrico, che può essere un insieme di uno o più punti sconnessi, oppure una curva, o ancora una regione. Ciò è evidenziato nella Figura 57, in cui ogni famiglia è caratterizzata da un colore diverso, che viene mostrando portando il puntatore sulla regione corrispondente o sul nome della famiglia, nella legenda in basso. Non tutti i punti del piano asimmetria-curtosi descrivono però una distribuzione: si può infatti dimostrare (vedi Esercizio 186) che per ogni variabile aleatoria che ammette momento di ordine \(4\) vale la disuguaglianza
e che l'uguaglianza corrispondente vale se e solo se \(X\) assume due soli valori. Nella figura, l'area al di sotto della parabola descritta da (19.14) è evidenziata in grigio, a significare che non può essere occupata da alcun punto.
import altair as alt
import numpy as np
import pandas as pd

a1 = np.linspace(-4, 4, 200)
a1_poisson = np.linspace(0, 4, 120)
a1_geom = np.linspace(2, 4, 60)
ordini_alt = np.arange(2, 11)


def forma_ipergeometrica_alt(popolazione, successi, estrazioni):
  """Asimmetria e curtosi di una distribuzione ipergeometrica."""
  comune = (estrazioni * successi * (popolazione - successi)
            * (popolazione - estrazioni))
  asimmetria = ((popolazione - 2 * successi) * np.sqrt(popolazione - 1)
                * (popolazione - 2 * estrazioni)) / (np.sqrt(comune)
                                                     * (popolazione - 2))
  curtosi = ((popolazione - 1) * popolazione**2
             * (popolazione * (popolazione + 1) - 6 * successi
                * (popolazione - successi) - 6 * estrazioni
                * (popolazione - estrazioni))
             + 6 * comune * (5 * popolazione - 6)) / (
             comune * (popolazione - 2) * (popolazione - 3))
  return asimmetria, curtosi


iperg_alt = np.array([forma_ipergeometrica_alt(p, s, e)
                      for p in (12, 24, 36)
                      for s in range(1, p, 2) for e in range(1, p, 2)])

curve = pd.concat(
  [pd.DataFrame({'g1': a1, 'g2': a1**2 - 2,
                 'famiglia': 'Bernoulli', 'curva': 'bernoulli'})]
  + [pd.DataFrame({'g1': a1, 'g2': a1**2 - 2 / n,
                   'famiglia': 'Binomiale', 'curva': f'binomiale-{n}'})
     for n in range(2, 16)]
  + [pd.DataFrame({'g1': a1_poisson, 'g2': a1_poisson**2,
                   'famiglia': 'Poisson', 'curva': 'poisson'}),
     pd.DataFrame({'g1': a1_geom, 'g2': a1_geom**2 + 2,
                   'famiglia': 'Geometrica', 'curva': 'geometrica'})],
  ignore_index=True)

punti = pd.concat(
  [pd.DataFrame({'g1': iperg_alt[:, 0], 'g2': iperg_alt[:, 1],
                 'famiglia': 'Ipergeometrica'}),
   pd.DataFrame({'g1': [0.0], 'g2': [-6 / 5], 'famiglia': 'Uniforme continua'}),
   pd.DataFrame({'g1': np.zeros_like(ordini_alt, dtype=float),
                 'g2': -6 / 5 * (ordini_alt**2 + 1) / (ordini_alt**2 - 1),
                 'famiglia': 'Uniforme discreta'}),
   pd.DataFrame({'g1': [2.0], 'g2': [6.0], 'famiglia': 'Esponenziale'}),
   pd.DataFrame({'g1': [0.0], 'g2': [0.0], 'famiglia': 'Normale'})],
  ignore_index=True)

vietata = pd.DataFrame({'g1': a1, 'g2': a1**2 - 2})

famiglie_alt = ['Bernoulli', 'Binomiale', 'Poisson', 'Geometrica',
                'Ipergeometrica', 'Uniforme continua', 'Uniforme discreta',
                'Esponenziale', 'Normale']
colori_alt = ['#1f77b4', '#8ec8e8', '#ff7f0e', '#2ca02c', '#d62728',
              '#8c564b', '#9467bd', '#e377c2', '#7f7f7f']

puntatore = alt.selection_point(fields=['famiglia'], on='mouseover',
                                clear='mouseout', empty=False)
colore_pieno = alt.Color('famiglia:N', legend=None,
                         scale=alt.Scale(domain=famiglie_alt,
                                         range=colori_alt))
larghezza = 460
font_matematico = dict(titleFont='Lora, Georgia, serif', titleFontStyle='italic',
                       titleFontSize=13, titleFontWeight='normal')


def banda(dominio, altezza, con_ascisse, con_ordinate):
  """Una delle due bande in cui è spezzato l'asse delle ordinate."""
  y = alt.Y('g2:Q', title='γ₂' if con_ordinate else None,
            scale=alt.Scale(domain=dominio, nice=False),
            axis=alt.Axis(titleAngle=0, titleAnchor='end', titleAlign='left',
                          titleBaseline='bottom', titleX=-6, titleY=-8,
                          **font_matematico))
  x = alt.X('g1:Q', title='γ₁' if con_ascisse else None,
            scale=alt.Scale(domain=[-4, 4], nice=False),
            axis=alt.Axis(labels=con_ascisse, ticks=con_ascisse,
                          domain=con_ascisse, titleAnchor='end',
                          titleAlign='left', titleBaseline='middle',
                          **font_matematico))
  descrizione = ['famiglia:N', alt.Tooltip('g1:Q', title='γ₁', format='.2f'),
                 alt.Tooltip('g2:Q', title='γ₂', format='.2f')]
  area = alt.Chart(vietata).mark_area(color='#cccccc', opacity=.4,
                                      clip=True).encode(
      x=x, y=alt.Y('g2:Q', scale=alt.Scale(domain=dominio, nice=False)),
      y2=alt.datum(-3))
  curve_grigie = alt.Chart(curve).mark_line(
      clip=True, strokeWidth=1.5, color='lightgray').encode(
      x=x, y=y, detail='curva:N')
  punti_grigi = alt.Chart(punti).mark_point(
      clip=True, filled=True, size=28, color='lightgray').encode(x=x, y=y)
  # La famiglia scelta viene ridisegnata sopra a tutte le altre.
  curve_in_evidenza = alt.Chart(curve).mark_line(
      clip=True, strokeWidth=1.5).encode(
      x=x, y=y, detail='curva:N',
      color=colore_pieno).transform_filter(puntatore)
  punti_in_evidenza = alt.Chart(punti).mark_point(
      clip=True, filled=True, size=28).encode(
      x=x, y=y, color=colore_pieno).transform_filter(puntatore)
  # Sopra a tutto, tratti e simboli trasparenti ma spessi: una curva di un paio
  # di pixel sarebbe altrimenti quasi impossibile da centrare col puntatore.
  esca_curve = alt.Chart(curve).mark_line(
      clip=True, strokeWidth=12, opacity=0).encode(
      x=x, y=y, detail='curva:N', tooltip=descrizione)
  esca_punti = alt.Chart(punti).mark_point(
      clip=True, filled=True, size=180, opacity=0).encode(
      x=x, y=y, tooltip=descrizione)
  return (area + curve_grigie + punti_grigi + curve_in_evidenza
          + punti_in_evidenza + esca_curve + esca_punti).properties(
      width=larghezza, height=altezza)

legenda_dati = pd.DataFrame({'famiglia': famiglie_alt,
                             'colonna': [i % 3 for i in range(9)],
                             'riga': [i // 3 for i in range(9)]})
legenda_x = alt.X('colonna:O', axis=None, scale=alt.Scale(padding=0))
legenda_y = alt.Y('riga:O', axis=None, scale=alt.Scale(padding=0))
sfondo = alt.Chart(legenda_dati).mark_rect(fill='#eaf3f5').encode(
    x=legenda_x, y=legenda_y)
quadretti = alt.Chart(legenda_dati).mark_point(
    filled=True, size=80, shape='square', xOffset=-62).encode(
    x=legenda_x, y=legenda_y,
    color=alt.condition(puntatore, colore_pieno, alt.value('lightgray')))
etichette = alt.Chart(legenda_dati).mark_text(
    align='left', xOffset=-52, fontSize=11).encode(
    x=legenda_x, y=legenda_y, text='famiglia:N',
    color=alt.condition(puntatore, colore_pieno, alt.value('#2b2b2b')))
legenda = (sfondo + quadretti + etichette).properties(width=larghezza,
                                                      height=60)

chart = alt.vconcat(banda([5.5, 7.5], 70, False, True),
                    banda([-2.5, 2.5], 175, True, False),
                    legenda, spacing=6).add_params(puntatore).configure(
    background='#eaf3f5').configure_view(strokeWidth=0).configure_axis(
    grid=True, gridColor='lightgray', gridOpacity=.7, domainColor='black',
    tickColor='black', labelFontSize=10, titleFontSize=12)
chart
Figura 57 Posizionamento delle principali famiglie di distribuzioni sul piano asimmetria-curtosi. L'area grigia indica la regione nella quale non è possibile trovare alcun punto, e il suo bordo corrisponde alle distribuzioni che assumono due soli valori. Ogni colore è associato a una delle famiglie descritte nei Capitoli 20 e 21. Portando il puntatore sul nome di una famiglia o sulla regione corrispondente, quest'ultima viene colorata e portata in primo piano.#
Il grafico visualizzato mette in evidenza alcuni fatti che ritroveremo studiando le singole famiglie.
Le distribuzioni di Bernoulli (vedi Paragrafo 20.1), e più in generale le distribuzioni a due valori, occupano il bordo che delimita la regione vietata.
La famiglia binomiale (vedi Paragrafo 20.2) è descritta da un fascio di parabole che comprendono quella della famiglia di Bernoulli (di cui rappresenta un'estensione), i cui elementi si addensano man mano che si avvicinano al bordo superiore del fascio stesso.
Le distribuzioni di Poisson (illustrate nel Paragrafo 20.5) individuano un arco di parabola che si trova sul bordo menzionato al punto precedente, in linea con il fatto che possono essere ottenute come limiti di successioni di distribuzioni binomiali con asimmetria positiva.
Le distribuzioni uniformi discrete (vedi Paragrafo 20.3) si dispongono sull'asse \(\gamma_1 = 0\), essendo sempre simmetriche: partono dal punto che denota la distribuzione uniforme a due valori (che si trova quindi sul bordo della regione ammissibile) e salgono verso un punto limite che individua le distribuzioni uniformi continue (descritte nel Paragrafo 21.3), anche in questo caso riflettendo un processo di convergenza che lega le due famiglie.
Le distribuzioni geometriche (introdotte nel Paragrafo 20.4) si collocano su un particolare arco di parabola, posizionato in una zona caratterizzata da asimmetria e curtosi entrambe elevate, e che ha come limite sinistro il punto che corrisponde alle distribuzioni esponenziali (vedi Paragrafo 21.5). Anche in questo caso, non si tratta di una fortuita coincidenza, ma riflette una particolare relazione tra le due famiglie di distribuzioni.
Le distribuzioni ipergeometriche (approfondite nel Paragrafo 20.6) descrivono un insieme di punti, alcuni sul bordo della regione ammissibile (quando il supporto si riduce a due valori).
L'origine, infine, rappresenta le distribuzioni normali (vedi Paragrafo 21.4).
Esempio 117
La Figura 58 colloca nel piano asimmetria-curtosi la famiglia di distribuzioni visualizzata neella Figura 56: la curva tratteggiata indica la traiettoria che corrisponde all'intera famiglia, mentre il punto arancione individua una specifica distribuzione all'interno della famiglia. Agendo sul selettore, viene selezionata una delle distribuzioni, spostando il punto ed aggiornando i valori di asimmetria e curtosi. Vale la pena di osservare che, quando il selettore è portato al suo estremo sinistro, il supporto della distribuzione contiene due elementi, e coerentemente il punto che la rappresenta va a trovarsi sul bordo della regione ammissibile.
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


fig_plane, ax_plane = plt.subplots()

skewness_plane = np.linspace(-4, 4, 500)
ax_plane.fill_between(skewness_plane, skewness_plane ** 2 - 2, -3,
                      color='#cccccc', alpha=.4)
ax_plane.plot(skewness_plane, skewness_plane ** 2 - 2, color='C0')

family_v_plane = np.linspace(0.5, 3, 300)
family_skewness_plane = 2 ** 0.5 * (family_v_plane - 1)
family_kurtosis_plane = 2 * family_v_plane ** 2 - 2 * family_v_plane - 1
ax_plane.plot(family_skewness_plane, family_kurtosis_plane, color='C2',
              linestyle=':')

current_point_plane, = ax_plane.plot([], [], 'o', color='#cc6600')

ax_plane.set_xlabel(r'$\gamma_1$', loc='right')
ax_plane.set_ylabel(r'$\gamma_2$', loc='top')
ax_plane.set_xlim(-4, 4)
ax_plane.set_ylim(-3, 16)


def render_plane_plot():
  v = float(page['#plane-v'][0].value) - 2

  left_mass = 1 / (2 * (1 + v))
  right_mass = 1 / (2 * v * (1 + v))
  values = np.array([1.0, 2.0, 2.0 + v])
  probabilities = np.array([left_mass, 1 - left_mass - right_mass, right_mass])

  mean = probabilities @ values
  variance = probabilities @ (values - mean) ** 2
  skewness = probabilities @ (values - mean) ** 3 / variance ** 1.5
  kurtosis = probabilities @ (values - mean) ** 4 / variance ** 2 - 3

  current_point_plane.set_data([skewness], [kurtosis])

  page['#plane-v-value'][0].innerHTML = f'{2 + v:.2f}'
  page['#plane-skewness'][0].innerHTML = f'{skewness:+.2f}'
  page['#plane-kurtosis'][0].innerHTML = f'{kurtosis:+.2f}'

  display(fig_plane, target='graph-3', append=False)


@when('input', '#plane-v')
def update_plane_plot(event):
  render_plane_plot()


render_plane_plot()
Figura 58 La famiglia della Figura 56 vista nel piano asimmetria-curtosi. Il punto arancione si sposta lungo la curva punteggiata al variare del valore originariamente più a destra del supporto e, coerentemente con (19.14), non entra mai nella regione vietata: la tocca soltanto all'estremo sinistro del selettore, dove la distribuzione degenera in una distribuzione a due valori.#
19.5.3. Funzione generatrice dei momenti#
Negli esempi precedenti i momenti di una distribuzione sono stati calcolati separatamente, uno per uno. Ciò può risultare scomodo, perché per ogni momento bisogna considerare una somma o una serie diversa. Molto spesso, è più pratico considerare una particolare funzione che permette di ricavare tutti i momenti, tramite applicazione successiva dell'operatore di derivata.
Definizione 44 (Funzione generatrice dei momenti)
Si dice funzione generatrice dei momenti di una variabile aleatoria discreta \(X\) la funzione
definita per tutti i valori di \(t \in \mathbb R\) per i quali la somma converge.
È facile verificare che la funzione generatrice dei momenti è sempre definita in \(t = 0\), perché \(m_X(0) = \mathbb E(1) = 1\) indipendentemente dalla distribuzione studiata. Nei casi che incontreremo, \(m_X\) risulterà sempre definita in un intorno dell'origine, ed è esattamente questa la condizione che permette di collegare la funzione al calcolo dei momenti: nella derivata prima di \(\mathrm e^{tX}\) rispetto a \(t\) compare un fattore \(X\), e ogni derivata successiva aggiunge un fattore analogo.
Teorema 29
Sia \(X\) una variabile aleatoria la cui funzione generatrice dei momenti \(m_X\) è definita in un intorno aperto di \(t = 0\). Allora \(X\) ammette momenti di ogni ordine e, per ogni \(n \in \mathbb N\),
dove \(m_X^{(n)}\) indica la derivata \(n\)-esima di \(m_X\).
Dimostrazione.
Il fatto che la funzione generatrice dei momenti sia definita in un intorno aperto dell'origine implica che deve esistere \(a > 0\) per cui \(m_X(a) \in \mathbb R\) e \(m_X(-a) \in \mathbb R\). Partendo dall'identità (A.12), si ottiene
Inoltre, per ogni \(i \in \mathbb N \cup \{ 0 \}\),
Considerando ora lo sviluppo in serie di Maclaurin di \(x \mapsto \mathrm e^{\lvert x \rvert}\), si avrà quindi
che implica \(\mathrm e^{a \lvert x \rvert} \geq a^n \tfrac{\lvert x \rvert^n}{n!}\) per ogni \(i\) intero non negativo, o, equivalentemente,
Mettendo insieme questi risultati, si ottiene
il che implica la convergenza assoluta della serie alla base di tutti i momenti di \(X\), e ciò dimostra la prima pare della tesi. Per quanto riguarda invece la seconda parte, si avrà
perché derivazione e somma si possono scambiare in virtù del fatto che quest'ultima converge uniformemente in un intorno dell'origine[2].
Per \(t = 0\), la variabile aleatoria \(\mathrm e^{tX}\) degenera nella costante \(1\), e dunque
Il nome della funzione è dunque pienamente giustificato: i momenti di \(X\) sono i coefficienti che si leggono derivando \(m_X\) nell'origine. In modo del tutto equivalente, i momenti sono, a meno del fattoriale, i coefficienti dello sviluppo in serie di Maclaurin della funzione generatrice dei momenti. Infatti,
La Figura 59 rende visibile questa affermazione: aggiungendo un momento alla volta, i polinomi che si ottengono troncando la serie si avvicinano progressivamente al grafico di \(m_X\), che viene quindi ricostruito dalla successione dei momenti.
import matplotlib.pyplot as plt
import numpy as np
from math import factorial
from pyscript import display
from pyscript.web import page, when


values_mgf = np.array([0.0, 1.0, 2.0])
probabilities_mgf = np.array([0.25, 0.5, 0.25])
moments_mgf = [probabilities_mgf @ values_mgf ** k for k in range(11)]

t_mgf = np.linspace(-1.5, 1.5, 300)
generating_mgf = probabilities_mgf @ np.exp(np.outer(values_mgf, t_mgf))

fig_mgf, ax_mgf = plt.subplots()
ax_mgf.plot(t_mgf, generating_mgf, color='C0', label=r'$m_X$')
approximation_mgf, = ax_mgf.plot(t_mgf, np.ones_like(t_mgf), color='C1',
                                 linestyle='--', label='sviluppo troncato')

ax_mgf.set_xlabel(r'$t$')
ax_mgf.set_ylabel(r'$m_X$')
ax_mgf.set_xlim(-1.5, 1.5)
ax_mgf.set_ylim(0, 8)
ax_mgf.legend(loc='upper left')


def render_mgf_plot():
  degree = int(float(page['#mgf-degree'][0].value))
  approximation = sum(moments_mgf[k] * t_mgf ** k / factorial(k)
                      for k in range(degree + 1))
  approximation_mgf.set_ydata(approximation)

  page['#mgf-degree-value'][0].innerHTML = f'{degree}'

  display(fig_mgf, target='graph-4', append=False)


@when('input', '#mgf-degree')
def update_mgf_plot(event):
  render_mgf_plot()


render_mgf_plot()
Figura 59 La funzione generatrice dei momenti della variabile aleatoria dell'Esempio 119 (curva blu) e la sua approssimazione polinomiale ottenuta troncando il suo sviluppo di Maclaurin (curva tratteggiata). In particolare, \(N\) sostituisce \(+\infty\) in (19.16), così che il selettore permette di controllare il numero di momenti utilizzati per costruire l'approssimazione.#
Esempio 118
La variabile aleatoria \(X\) dell'Esempio 111, caratterizzata da \(S_X = \{ 0, 1, 2 \}\), \(p_X(0) = 0.2\), \(p_X(1) = 0.5\) e \(p_X(2) = 0.3\), ha la seguente funzione generatrice dei momenti:
dunque
e \(m_X^{(n)}(0) = 0.5 + 0.3 2^n\). Da quest'ultima relazione si ricava
in linea con quanto già ricavato.
Esempio 119
Quando Multiple Man prova a generare un duplicato, il tentativo riesce con probabilità \(\frac{1}{2}\). Pertanto, se a fronte di due tentativi indichiamo con \(X_1\) e \(X_2\) il numero di duplicati generati rispettivamente nel primo e nel secondo tentativo, avremo \(S_{X_1}= S_{X_2} = \{ 0, 1 \}\) e \(p_{X_1}(0) = p_{X_1}(1) = p_{X_2}(0) = p_{X_2}(1) = \tfrac{1}{2}\). In virtù del fatto che il supporto contiene due soli elementi, la funzione generatrice dei momenti di \(X_1\) si calcola facilmente:
e \(m_{X_2}\) ha la medesima forma analitica, essendo le due funzioni di massa di probabilità identiche. Se indichiamo ora con \(X\) il numero totale di duplicati effettivamente ottenuti, si avrà \(X = X_1 + X_2\), \(S_X = \{0, 1, 2\}\) e, se ogni tentativo ha successo indipendentemente dall'altro, \(p_X(0) = p_X(2) = \frac{1}{4}\) e \(p_X(1) = \frac{1}{2}\), per cui
Derivando due volte si ottiene
da cui \(\mathbb E(X) = \mu'_1 = m_X^\prime(0) = 1\) e \(\mathbb E(X^2) = \mu'_2 = m_X^{\prime\prime}(0) = \frac{3}{2}\), e dunque \(\operatorname{Var}(X) = \frac{3}{2} - 1 = \frac{1}{2}\).
Nell'esercizio precedente, la funzione generatrice dei momenti di \(X\) assume una forma particolare: è il quadrato della funzione generatrice comune a \(X_1\) e \(X_2\). Ciò non è casuale, ed è legato alla particolare relazione che lega le tre variabili aleatorie, come chiarirà il Teorema 32.
La funzione generatrice dei momenti si può facilmente collegare anche ai momenti centrali, come evidenziato dal prossimo teorema e, soprattutto dal corollario che ne segue.
Teorema 30 (Funzione generatrice di una trasformazione affine)
Sia \(X\) una variabile aleatoria con funzione generatrice dei momenti \(m_X\) e siano \(a, b \in \mathbb R\). Posto \(Y \triangleq aX + b\), si ha
per tutti i \(t\) tali che \(at\) appartenga al dominio di \(m_X\).
Dimostrazione.
Applicando la Definizione 44 definizione si ottiene direttamente
dove il terzo passaggio segue dal Teorema 26, perché \(\mathrm e^{bt}\) non dipende da \(X\).
Corollario 8
Sia \(X\) una variabile aleatoria con valore atteso \(\mu\) e funzione generatrice dei momenti \(m_X\). Per ogni \(n \in \mathbb N \cup \{ 0 \}\), il momento centrale di \(X\) di ordine \(n\) soddisfa
dove \(m_Y(t) = \mathrm e^{-\mu t} m_X(t)\).
Dimostrazione.
Sia \(Y = X - \mu\) la variabile aleatoria ottenuta centrando \(X\). Per la Definizione 40, i momenti di \(Y\) coincidono con i momenti centrali di \(X\); applicando inoltre il Teorema 30 al caso \(a = 1\), \(b = \mu\) si ottiene
da cui segue la tesi.
Esempio 120
Siano \(X\) e \(Y\) due variabili aleatorie definite nel modo seguente.
\(x\) |
\(\mathbb P(X=x)\) |
\(y\) |
\(\mathbb P(Y=y)\) |
|---|---|---|---|
\(-3\) |
\(\tfrac{1}{32}\) |
\(-2\) |
\(\tfrac{3}{16}\) |
\(-1\) |
\(\tfrac{15}{32}\) |
\( 0\) |
\(\tfrac{5}{8}\) |
\( 1\) |
\(\tfrac{15}{32}\) |
\( 2\) |
\(\tfrac{3}{16}\) |
\( 3\) |
\(\tfrac{1}{32}\) |
Le distribuzioni di \(X\) e \(Y\) sono entrambe simmetriche rispetto a zero, quindi i momenti di ordine dispari sono nulli. Calcolando anche quelli di ordine pari si ottiene
Le due distribuzioni hanno dunque gli stessi primi quattro momenti, e quindi anche la stessa media, varianza, asimmetria e curtosi. Sono però chiaramente diverse, avendo supporti differenti.
Estendendo l'esempio precedente, la conoscenza di un numero finito di momenti non è, in generale, sufficiente a determinare univocamente una distribuzione. Ci si può chiedere se le cose cambino una volta che si conoscono tutti i momenti: in questo caso, la distribuzione sarebbe completamente determinata? La risposta a questa domanda, nota come problema dei momenti, è affermativa nelle situazioni che incontreremo in questo libro, ma non lo è in generale. Per esempio, se il supporto di di una variabile aleatoria è limitato, allora la successione dei momenti individua univocamente la distribuzione, e vale un risultato più generale, formalizzato nel seguente teorema, di cui riporto solo l'enunciato, perché una sua dimostrazione rigorosa richiederebbe di padroneggiare strumenti matematici avanzati.
Teorema 31 (Unicità della funzione generatrice dei momenti)
Siano \(X\) e \(Y\) due variabili aleatorie. Se esiste un intorno aperto \(I\) dell'origine nel quale \(m_X\) e \(m_Y\) sono finite e \(m_X(t) = m_Y(t)\) per ogni \(t \in I\), allora \(X\) e \(Y\) hanno la stessa distribuzione.
Quando la funzione generatrice dei momenti non è definita in alcun intorno dell'origine, però, il teorema precedente non è applicabile, e in effetti esistono distribuzioni diverse che condividono tutti i momenti. Fornire degli esempi di siffatte distribuzioni per variabili aleatorie discrete richiede di addentrarsi in dettagli matematici che vanno oltre lo scopo di questo libro; in alternativa, è necessario considerare specifiche distribuzioni continue, che non abbiamo ancora affrontato.
19.5.4. Vero o falso?#
Analizzate ciascuna delle seguenti affermazioni, che riguardano una variabile aleatoria discreta \(X\) che ammette momenti di ogni ordine, e dite se è vera o falsa, motivando il vostro ragionamento. Cliccate su di essa per visualizzare la risposta corretta.
Il momento centrale di ordine \(1\) coincide con il valore atteso di \(X\).
Falsa. Il momento centrale di ordine \(1\) è sempre nullo, qualunque sia la distribuzione: \(\mu_1 = \mathbb E(X - \mu) = \mathbb E(X) - \mu = 0\). È invece il momento centrale di ordine \(1\) a coincidere con il valore atteso.
Se \(X\) ammette il momento di ordine \(4\), allora ammette anche quelli di ordine \(1\), \(2\) e \(3\).
Vera. Come osservato dopo la Definizione 40, l'esistenza di un momento implica quella di tutti i momenti di ordine inferiore: i momenti si perdono a partire da un certo ordine in poi, e mai a intermittenza.
Se la distribuzione di \(X\) è simmetrica rispetto al valore atteso, allora \(\gamma_1 = 0\) e \(\gamma_2 = 0\).
Falsa. La simmetria annulla necessariamente \(\gamma_1\), perché gli scarti positivi e negativi si compensano anche dopo essere stati elevati al cubo, ma non dice nulla sul peso delle code. Impostando \(x = 3\) nella Figura 56, per esempio, si ottiene una distribuzione simmetrica platicurtica, per cui \(\gamma_1 = 0\) e \(\gamma_2 = -1\).
Asimmetria e curtosi di \(3X + 7\) coincidono con quelle di \(X\).
Vera. Per il Teorema 28 la deviazione standard viene moltiplicata per \(3\), e ogni momento centrale di ordine \(k\) per \(3^k\): nel rapporto \(\mu_k / \sigma^k\) i due fattori si elidono. La costante additiva, poi, non influisce sui momenti centrali, che sono calcolati rispetto al valore atteso.
L'asimmetria di \(-X\) coincide con quella di \(X\).
Falsa. Moltiplicando una variabile aleatoria per \(-1\), il momento centrale di ordine \(3\) viene moltiplicato per \((-1)^3 = -1\), mentre \(\sigma^3\) non cambia: l'asimmetria cambia quindi il suo segno. Ed è quanto ci si deve aspettare, perché riflettere una distribuzione scambia la coda destra con quella sinistra. La curtosi, invece, dipende da una potenza pari e resta la stessa.
Per ogni variabile aleatoria \(X\) si ha \(m_X(0) = 1\).
Vera. Dalla Definizione 44 segue \(m_X(0) = \mathbb E \left( \mathrm e^{0} \right) = \mathbb E(1) = 1\): l'origine appartiene sempre al dominio della funzione generatrice, e in essa la funzione vale \(1\).
La funzione generatrice dei momenti di una variabile aleatoria discreta è definita per ogni \(t \in \mathbb R\).
Falsa. La somma \(\sum_x \mathrm e^{tx} p_X(x)\) può divergere: quando il supporto è illimitato e le code sono abbastanza pesanti, il dominio di \(m_X\) si riduce a un intervallo, oppure al solo punto \(t = 0\).
Se due variabili aleatorie hanno la stessa funzione generatrice dei momenti in un intorno di \(t = 0\), allora hanno la stessa distribuzione.
Vera. È l'enunciato del Teorema 31, che viene spesso utilizzato per ricavare la distribuzione di una somma di variabili aleatorie dalla sola forma analitica della sua funzione generatrice.
Due distribuzioni diverse non possono avere tutti i momenti uguali.
Falsa. Esistono coppie di distribuzioni diverse con gli stessi momenti di ogni ordine. Ciò può però accadere soltanto quando la funzione generatrice non è definita in alcun intorno dell'origine: se lo è, l'affermazione diventa vera per il punto precedente.
Esiste una variabile aleatoria con asimmetria \(\gamma_1 = 3\) e curtosi \(\gamma_2 = 2\).
Una variabile aleatoria che assume due soli valori individua un punto sul bordo della regione ammissibile del piano asimmetria-curtosi.
19.5.5. Esercizi#
Esercizio 179 (•)
Il numero \(X\) di dispositivi che Moon Girl riesce a costruire in un pomeriggio ha supporto \(S_X = \{0, 1, 3\}\) e funzione di massa di probabilità \(p_X(0) = \frac{1}{2}\), \(p_X(1) = \frac{1}{4}\) e \(p_X(3) = \frac{1}{4}\).
Calcolate i momenti di ordine \(1\) e \(2\) e utilizzateli per ottenere la varianza della distribuzione.
Calcolate il momento centrale di ordine \(3\).
Determinate l'asimmetria di \(X\), commentando il risultato ottenuto.
Solution to Esercizio 179 (•)
Si ha
\[\begin{aligned} \mu'_1 &= \mathbb E(X) = 0 \cdot \frac{1}{2} + 1 \cdot \frac{1}{4} + 3 \cdot \frac{1}{4} = 1 \enspace, \\ \mu'_2 &= \mathbb E(X^2) = 0 \cdot \frac{1}{2} + 1 \cdot \frac{1}{4} + 9 \cdot \frac{1}{4} = \frac{5}{2} \enspace, \end{aligned}\]da cui \(\operatorname{Var}(X) = \mu'_2 - (\mu'_1)^2 = \frac{5}{2} - 1 = \frac{3}{2}\).
Applicando la definizione di momento centrale si ottiene
\[\mu_3 = (-1)^3 \frac{1}{2} + 0 \cdot \frac{1}{4} + 2^3 \frac{1}{4} = \frac{3}{2} \enspace.\]Dal punto 1 si ottiene che la deviazione standard di \(X\) è \(\sigma = \sqrt{3/2}\), per cui
\[\gamma_1 = \frac{3/2}{(3/2)^{3/2}} = \frac{1}{\sqrt{3/2}} = \sqrt{\frac{2}{3}} \approx 0.82 \enspace.\]Il valore ricavato è positivo, e ciò è indice del fatto che la distribuzione è asimmetrica verso destra: il valore \(3\), pur essendo meno probabile di \(0\), dista il doppio di esso dal valore atteso.
Esercizio 180 (••)
Usando la relazione descritta da (19.13):
verificate che per \(k = 2\) si ritrova la formula per il calcolo della varianza dimostrata nel Teorema 27;
ricavate l'espressione del momento centrale di ordine \(3\) in funzione dei momenti rispetto all'origine;
applicate la formula ottenuta nel punto precedente alla variabile aleatoria dell'Esercizio 179, per la quale \(\mathbb E(X^3) = \frac{28}{4} = 7\).
Solution to Esercizio 180 (••)
Per \(k = 2\) la somma ha tre termini:
\[\begin{aligned} \mu_2 &= \mu^2 \mathbb E(X^0) - 2\mu\, \mathbb E(X) + \mathbb E(X^2) \\ &= \mathbb E(X)^2 - 2\mathbb E(X)^2 + \mathbb E(X^2) = \mathbb E(X^2) - \mathbb E(X)^2 \enspace. \end{aligned}\]Per \(k = 3\), con lo stesso procedimento,
\[\mu_3 = \mathbb E(X^3) - 3\mu\, \mathbb E(X^2) + 3\mu^2 \mathbb E(X) - \mu^3 = \mathbb E(X^3) - 3\mu\, \mathbb E(X^2) + 2\mu^3 \enspace.\]Nella soluzione dell'Esercizio 179 è già stato ricavato che che \(\mathbb E(X) = 1\) e \(\mathbb E(X^2) = \frac{5}{2}\). Inoltre \(\mathbb E(X^3) = 1 \cdot \tfrac{1}{4} + 27 \cdot \tfrac{1}{4} = 7\), per cui si ottiene \(\mu_3 = 7 - \frac{15}{2} + 2 = \frac{3}{2}\), in accordo con il calcolo diretto svolto nell'esercizio.
Esercizio 181 (•)
Il numero \(X\) di ipotesi che Brainiac 5 scarta prima di trovare quella giusta è uniforme su \(S_X = \{0, 1, 2\}\), cioè assume i tre valori con la stessa probabilità.
Scrivete la funzione generatrice dei momenti di \(X\).
Ricavate \(\mu'_1\) e \(\mu'_2\) partendo dalla funzione generatrice dei momenti, e utilizzateli per calcolate \(\operatorname{Var}(X)\).
Verificate la correttezza del risultato ottenuto al punto precedente, utilizzando la Definizione 40.
Solution to Esercizio 181 (•)
Applicando la Definizione 44,
\[m_X(t) = \frac{1}{3} \left( 1 + \mathrm e^{t} + \mathrm e^{2t} \right) \enspace.\]Derivando due volte, si ottiene
\[\begin{aligned} m_X^\prime(t) &= \frac{\mathrm e^t + 2 \mathrm e^{2t}}{3} \enspace, \\ m_X^{\prime\prime}(t) &= \frac{\mathrm e^t + 4 \mathrm e^{2t}}{3} \enspace, \end{aligned}\]da cui \(\mu'_1 = m_X^\prime(0) = 1\) e \(\mu'_2 = m_X^{\prime\prime}(0) = \frac{5}{3}\). Pertanto \(\operatorname{Var}(X) = \frac{5}{3} - 1 = \frac{2}{3}\).
Applicando la definizione di momenti si verifica che \(\mathbb E(X) = \frac{0 + 1 + 2}{3} = 1\) e \(\mathbb E(X^2) = \frac{0 + 1 + 4}{3} = \frac{5}{3}\). Gli esiti dei due procedimenti coincidono, come garantito dal Teorema 29.
Esercizio 182 (••)
Sia \(X\) una variabile aleatoria, e siano \(a, b \in \mathbb R\), con \(a \neq 0\). Posto \(Y = aX + b\):
mostrate che il momento centrale di ordine \(k\) di \(Y\) è uguale a \(a^k \mu_k\), dove \(\mu_k\) è il corrispondente momento centrale di \(X\);
deducetene che \(\gamma_2\) è la stessa per \(X\) e per \(Y\), mentre \(\gamma_1\) cambia segno quando \(a < 0\);
dite quali valori assumono i momenti centrali quando \(Y\) è ottenuta standardizzando \(X\).
Solution to Esercizio 182 (••)
Per il Teorema 26 si ha \(\mathbb E(Y) = a \mathbb E(X) + b\), per cui \(Y - \mathbb E(Y) = a(X - \mathbb E(X))\). Il momento centrale di ordine \(k\) di \(Y\) è quindi \(\mathbb E \left( (Y - \mathbb E(Y))^k \right) = a^k \mathbb E \left( (X - \mathbb E(X))^k \right) = a^k \mu_k\).
Se \(\sigma\) denota la deviazione standard di \(X\), per il Corollario 6 la deviazione standard di \(Y\) è \(\lvert a \rvert \sigma\) , dunque il momento standardizzato di ordine \(k\) di \(Y\) vale
\[\frac{a^k \mu_k}{\lvert a \rvert^k \sigma^k} = \operatorname{sign}(a)^k \frac{\mu_k}{\sigma^k} \enspace.\]Per \(k = 4\) l'esponente è pari e il segno scompare, quindi \(\gamma_2\) non cambia; per \(k = 3\) resta il fattore \(\operatorname{sign}(a)\), che inverte l'asimmetria quando \(a < 0\).
Indicando con \(\mu\) e \(\sigma\) il valore atteso e la deviazione standard di \(X\), si deve avere \(Y = (X - \mu)/\sigma\), e in particolare \(a = 1/\sigma\). Per quanto ottenuto al punto 1, i momenti centrali di \(Y\) coincidono con i momenti standardizzati di \(X\): in particolare \(\mathbb E(Y^3) = \gamma_1\) e \(\mathbb E(Y^4) = \gamma_2 + 3\). Ciò è vero in generale, proprio perché i momenti standardizzati sono insensibili a traslazioni e riscalature.
Esercizio 183 (•••)
Utilizzando il selettore della Figura 54, determinate
approssimativamente per quale valore di \(x\) si annulla l'asimmetria della
distribuzione. Usate sympy per determinare il valore esatto, e confrontate
il lavoro richiesto con quello che sarebbe stato necessario procedendo
analiticamente.
Solution to Esercizio 183 (•••)
Si verifica facilmente che l'asimmetria si deve annullare in corrispondenza di un valore di poco superiore a \(3\) (infatti, risulta positiva per \(x=3.1\) e negativa per \(x=3.05\)). L'asimmetria della distribuzione in funzione di \(x\) si ottiene tramite il codice che segue.
import sympy as sp
from sympy.stats import E, FiniteRV

x = sp.Symbol('x')
X = FiniteRV('X', {sp.Integer(1): sp.Rational(1, 6),
                   sp.Integer(2): sp.Rational(3, 4),
                   x:             sp.Rational(1, 12)})
mu3 = E((X - E(X))**3)
var = E((X - E(X))**2)
sigma = sp.sqrt(var)
gamma_1 = sp.simplify(mu3 / sigma**3)
gamma_1
In particolare, il valore cercato di \(x\) si determina facilmente risolvendo l'equazione che annulla l'asimmetria, considerando la sola radice reale.
soluzione = [s for s in sp.solve(sp.Eq(gamma_1, 0), x) if s.is_real][0]
soluzione
La soluzione ottenuta, come evidenziato nella cella che segue, è approssimativamente uguale a \(3.09\), confermando l'analisi qualitativa fatta precedentemente.
sp.N(soluzione)
Procedere in modo computazionale ha richiesto la scrittura di una decina di righe di codice. Volendo risolvere il problema in modo analitico, sarebbe necessario calcolare a mano i momenti \(\mu'_1\), \(\mu_2\), \(\mu_3\), così come la deviazione standard, esprimendoli in funzione di \(x\), ottenendo infine un'equazione di terzo grado la cui soluzione, come evidenziato sopra, è tutt'altro che facile da trovare.
Esercizio 184 (••)
Sia \(X\) una variabile aleatoria che assume due soli valori, il maggiore dei quali con probabilità \(p\).
Ricavate l'asimmetria di \(X\) (suggerimento: questa variabile aleatoria si ottiene applicando una trasformazione affine a una variabile indicatrice).
Determinate il valore di \(p\) per il quale \(\gamma_1 = 1\).
Calcolate la curtosi corrispondente al valore di \(p\) ottenuto al punto precedente e verificate che la rappresentazione della distribuzione corrispondente si trova sul bordo della regione ammissibile del piano asimmetria-curtosi.
Solution to Esercizio 184 (••)
Indichiamo con \(a\) e \(b\) i due valori che può assumere \(X\), con \(a < b\). Allora \(X = a + (b-a) 𝟙_{X=b}\), cioè \(X\) si ottiene applicando una trasformazione affine con coefficiente moltiplicativo positivo a una variabile aleatoria indicatrice. Per l'Esercizio 182, l'asimmetria di \(X\) e quella di \(𝟙_{X=b}\) coincidono, e quest'ultima, per l'Esempio 113, è uguale a
\[\frac{1 - 2p}{\sqrt{p(1-p)}} \enspace.\]Imponendo \((1-2p) = \sqrt{p(1-p)}\) ed elevando al quadrato si ottiene \(5p^2 - 5p + 1 = 0\), le cui soluzioni sono \(p = \frac{1}{2} \left( 1 \pm \frac{\sqrt 5}{5} \right)\), entrambe comprese tra \(0\) e \(1\). Però, richiedere che l'asimmetria sia positiva equivale ad avere una distribuzione asimmetrica verso destra, quindi com più massa di probabilità associata al valore minore. A sua volta, ciò implica \(p < \frac{1}{2}\), dunque l'unica soluzione possibile è \(p = \frac{1}{2} \left(1 - \frac{\sqrt 5}{5} \right) \approx 0.28\).
Per una variabile indicatrice la curtosi è \(\frac{1}{p(1-p)} - 6\) (vedi Esempio 115), e il valore di \(p\) determinato al punto precedente garantisce che valga \(p(1-p) = \frac{1}{5}\), da cui \(\gamma_2 = 5 - 6 = -1\). La distribuzione è quindi identificata dal punto \((1, -1)\) nel piano asimmetria-curtosi. Le coordinate di questo punto soddisfano \(\gamma_2 = \gamma_1^2 - 2\), e il punto stesso giace sul bordo previsto da (19.14), come deve essere per una distribuzione a due valori.
Esercizio 185 (•••)
Doorman attraversa un muro al primo tentativo con probabilità \(\frac{1}{4}\); sia \(X\) la variabile indicatrice del successo di questo tentativo.
Scrivete \(m_X(t)\) e calcolate le sue prime tre derivate.
Usando (19.13), calcolate il momento centrale di ordine \(3\) di \(X\).
Calcolate l'asimmetria di \(X\).
Calcolate la curtosi di \(X\).
Solution to Esercizio 185 (•••)
Si ha \(m_X(t) = \frac{3}{4} + \frac{1}{4}\mathrm e^{t}\), e tutte le derivate coincidono: \(m_X^\prime(t) = m_X^{\prime\prime}(t) = m_X^{\prime\prime\prime}(t) = \frac{1}{4}\mathrm e^{t}\).
Siccome \(\mu \triangleq\mathbb E(X) = \mu'_1 = m^\prime_X(0) = \frac{1}{4}\), fissando \(n =3\) in (19.13) si ottiene
\[\begin{align*} \mu_3 = m_Y^{\prime\prime\prime}(0) &= m_X^{\prime\prime\prime}(0) - 3\mu\, m_X^{\prime\prime}(0) + 3\mu^2 m_X^\prime(0) - \mu^3 m_X(0) \\ &= \frac{1}{4} - \frac{3}{16} + \frac{3}{64} - \frac{1}{64} = \frac{3}{32} \enspace. \end{align*}\]\(X\) è una variabile indicatrice, e \(p = \triangleq\mathbb P(X=1)=\tfrac{1}{4}\), dunque \(\operatorname{Var}(X) = p(1-p) = \frac{3}{16}\) e
\[\gamma_1 = \frac{3/32}{(3/16)^{3/2}} = \frac{2}{3}\sqrt 3 \approx 1.15 \enspace.\]Tenuto conto del fatto che \(X\) assume due soli valori, (19.14) deve valere come uguaglianza, e ciò permette di ottenere la sua curtosi direttamente, senza calcolare valori attesi e senza derivare la funzione generatrice dei momenti. Si ha infatti \(\gamma_2 = \gamma_1^2 - 2 = \frac{4}{3} - 2 = -\frac{2}{3}\).
Esercizio 186 (••••)
Dimostrate la disuguaglianza (19.14), procedendo nel modo seguente. Fissando una generica variabile aleatoria \(X\) che ammette valore atteso \(\mu\) e varianza \(\sigma^2\), considerate la variabile aleatoria standardizzata \(Z = (X - \mu)/\sigma\), per la quale \(\mathbb E(Z) = 0\), \(\mathbb E(Z^2) = 1\), \(\mathbb E(Z^3) = \gamma_1\) e \(\mathbb E(Z^4) = \gamma_2 + 3\).
Calcolate \(\operatorname{Var}(Z^2 - \gamma_1 Z)\), esprimendila in funzione di \(\gamma_1\) e \(\gamma_2\).
Sfruttando il risultato del punto precedente, derivate la validità della disuguaglianza \(\gamma_2 \geq \gamma_1^2 - 2\).
Stabilite per quali distribuzioni vale l'uguaglianza \(\gamma_2 = \gamma_1^2 - 2\).
Solution to Esercizio 186 (••••)
Posto \(W = Z^2 - \gamma_1 Z\), si ha \(\mathbb E(W) = \mathbb E(Z^2) - \gamma_1 \mathbb E(Z) = 1\) e
\[\begin{align*} \mathbb E \left( W^2 \right) &= \mathbb E \left( Z^4 \right) - 2\gamma_1 \mathbb E \left( Z^3 \right) + \gamma_1^2 \mathbb E \left( Z^2 \right) \\ &= (\gamma_2 + 3) - 2\gamma_1^2 + \gamma_1^2 = \gamma_2 + 3 - \gamma_1^2 \enspace, \end{align*}\]per cui, usando il Teorema 27,
\[\operatorname{Var}(W) = \gamma_2 + 3 - \gamma_1^2 - 1 = \gamma_2 + 2 - \gamma_1^2 \enspace.\]La varianza non può mai essere negativa, dunque \(\operatorname{Var}(W) \geq 0\), o equivalentemente \(\gamma_2 + 2 - \gamma_1^2 \geq 0\), che coincide con (19.14).
L'uguaglianza richiede \(\operatorname{Var}(W) = 0\), cioè che \(W\) sia uguale a un valore costante \(c\) con probabilità \(1\). Imponendo \(W = c\), che equivale a \(Z^2 - \gamma_1 Z = c\), si ottiene un'equazione di secondo grado in \(Z\), che ammette al più due soluzioni: dunque \(Z\) assume al più due valori, e lo stesso deve valere per \(X\). Questo include, in linea di principio, le variabili aleatorie degeneri, che però hanno deviazione standard nulla e quindi non ammettono asimmetria né curtosi, e dunque vanno scartate. Viceversa, per una distribuzione a due valori, gli Esercizi 184 e 185 mostrano che l'uguaglianza è effettivamente soddisfatta.
19.5.6. Concetti fondamentali#
Pensate ai concetti fondamentali illustrati in questo paragrafo ed elencateli. Nella lista qui sotto sono già presenti gli stessi concetti, ma nascosti. Cliccate sul pulsante per mostrarli sotto forma di parole chiave, quindi confrontateli con la vostra lista. Provate infine a descrivere ciascun concetto con parole vostre.