
 Italiano
 English
 Français
 Español
5.1. Serie#
Una delle classi principali implementate in pandas è Series. Le sue istanze
rappresentano serie di osservazioni di un certo carattere fatto su un insieme
di individui. La cella seguente recupera dalla lista heroes precedentemente
creata i nomi dei supereroi e il loro anno di prima apparizione e li utilizza
per creare una serie:
import csv
import numpy as np
import matplotlib.pyplot as plt
import pandas as pd

with open('data/heroes.csv', 'r') as heroes_file:
  heroes_reader = csv.reader(heroes_file, quotechar='"')
  heroes = list(heroes_reader)[1:]

years = [int(h[13]) if h[13] else None for h in heroes]
names = [h[0] for h in heroes]
first_appearance = pd.Series(years, index = names)
Nella creazione della lista year è stata utilizzata una list comprehension in
cui l'espressione int(h[13]) if h[13] else None utilizza un operatore ternario
tramite cui la stringa vuota viene trasformata nel valore speciale None,
mentre tutte le altre vengono convertite nel corrispondente intero.
La differenza tra una serie e una lista o una tupla è legata alla possibilità di invocare su di essa delle funzioni specifiche. Inoltre a ogni serie è associato un indice che permette di identificare ogni elemento osservato. Nell'esempio sopra riportato, il primo argomento specificato nel costruttore è una lista (ma sarebbe andata bene anche una tupla) di anni che indicano la prima apparizione di un supereroe e il secondo rappresenta appunto l'indice, che in questo caso è la lista dei corrispondenti nomi. Quando si visualizza una serie, ogni osservazione viene associata al corrispondente elemento usando appunto l'indice:
first_appearance
Laufey              2018.0
Laugh-a-Lot Bear       NaN
Laughing Jack          NaN
Laura Moon             NaN
Laura Palmer           NaN
                     ...
Aphoom-Zhah            NaN
Aphrodite-1            NaN
Aphrodite-2            NaN
Aphrodite-3         2012.0
Aphrodite-4            NaN
Length: 17355, dtype: float64
La visualizzazione della serie (che in questo caso riporta solo i primi e gli
ultimi elementi perché la serie è troppo lunga) termina indicando il tipo di
dato usato per rappresentare le varie osservazioni. Nell'esempio precedente
viene utilizzato il tipo float64 (pandas utilizza internamente gli array di
numpy, in cui è presente un'implementazione dei tipi in virgola mobile diversa
da quella standard di python), nonostante i dati originari fossero numeri
interi. Ciò è dovuto alla presenza di valori mancanti. Di norma vengono
indicati con la sigla NA (dall'inglese "not available"), ma in pandas essi
vengono rappresentati utilizzando il concetto di "not a number" dello standard
IEEE per la virgola mobile: si noti come tutte le occorrenze di None nella
lista originale siano state automaticamente convertite in np.nan.
L'accesso ai dati contenuti in una serie può avvenire in due modi:
specificando un valore per l'indice tra parentesi quadre dopo la serie o dopo la sua proprietà
loc:
(first_appearance['Wonder Woman'], first_appearance.loc['Wonder Woman'])
(np.float64(nan), np.float64(nan))
indicando un valore per la posizione tra parentesi quadre dopo la serie o dopo la sua proprietà
iloc:
(first_appearance[128], first_appearance.iloc[128])
/tmp/ipykernel_3260/1782672992.py:1: FutureWarning: Series.__getitem__ treating keys as positions is deprecated. In a future version, integer keys will always be treated as labels (consistent with DataFrame behavior). To access a value by position, use `ser.iloc[pos]`
  (first_appearance[128], first_appearance.iloc[128])
(np.float64(nan), np.float64(nan))
Nomenclatura
Se l'indice di una serie è basato su valori interi, i valori tra parentesi quadre immediatamente dopo la serie faranno riferimento all'indice e non alla posizione: ciò potrebbe essere fuorviante se gli elementi dell'indice non partono da zero e non sono consecutivi.
È inoltre possibile utilizzare una notazione simile al list slicing specificando valori dell'indice oppure posizioni. Va però notato che gli slicing basati su indice comprenderanno il primo e l'ultimo valore specificato:
first_appearance['Wonder Girl':'Wonder Woman']
Wonder Girl      1996.0
Wonder Girl-1       NaN
Wonder Girl-2    2011.0
Wonder Girl-3       NaN
Wonder Girl-4    2021.0
Wonder Girl-5       NaN
Wonder Girl-6    2021.0
Wonder Man          NaN
Wonder Man-1     2005.0
Wonder Wife         NaN
Wonder Woman        NaN
dtype: float64
mentre gli slice basati su posizione escluderanno l'ultimo elemento:
first_appearance[60:63]
Leo Bonhart   NaN
Leo Dooley    NaN
Leo Fitz      NaN
dtype: float64
L'accesso posizionale può anche fare riferimento a numeri negativi, contando in analogia a liste e tuple a partire dall'ultimo elemento:
first_appearance[-5:]
Aphoom-Zhah       NaN
Aphrodite-1       NaN
Aphrodite-2       NaN
Aphrodite-3    2012.0
Aphrodite-4       NaN
dtype: float64
È possibile accedere ai primi e ultimi elementi di una serie anche utilizzando
le funzioni head e tail, che mostrano rispettivamente solo le prime e le
ultime righe:
first_appearance.head(7)
Laufey               2018.0
Laugh-a-Lot Bear        NaN
Laughing Jack           NaN
Laura Moon              NaN
Laura Palmer            NaN
Laura Weathermill       NaN
Lauren Reed             NaN
dtype: float64
L'accesso alle liste può anche essere fatto specificando una lista (ma non una tupla) di posizioni al posto di una sola posizione, con l'effetto di ottenere i corrispondenti elementi.
first_appearance[[1, 42, 709]]
/tmp/ipykernel_3260/2760408145.py:1: FutureWarning: Series.__getitem__ treating keys as positions is deprecated. In a future version, integer keys will always be treated as labels (consistent with DataFrame behavior). To access a value by position, use `ser.iloc[pos]`
  first_appearance[[1, 42, 709]]
Laugh-a-Lot Bear   NaN
Legion-1           NaN
Malia Tate         NaN
dtype: float64
Questo tipo di accesso può essere fatto anche specificando una lista di valori
per l'indice. Infine, si può utilizzare una lista di valori booleani in cui
True indica gli elementi da estrarre e False quelli da filtrare:
first_appearance[[1970 <= y <1975 for y in first_appearance]]
Leatherface            1974.0
Lilith Drake           1974.0
Luke Cage              1972.0
Mad Harriet            1972.0
Man-Bat                1970.0
                        ...
Jennifer Kale          1972.0
Jiger                  1970.0
King Caesar (Showa)    1974.0
Klarion                1973.0
Kronos-1               1973.0
Length: 81, dtype: float64
Nomenclatura
L'uso di questa modalità di accesso richiede che la lista di valori booleani abbia la stessa lunghezza della serie. L'uso di liste di dimensioni minori l'accesso, che comporta un filtraggio effettuato solo nei primi elementi della serie, è deprecato e va quindi evitato.
Infine, è possibile effettuare delle query su una serie specificando tra parentesi quadre un'espressione logica che indica quali elementi visualizzare, utilizzando la serie come simbolo che ne indica un suo generico elemento:
first_appearance[first_appearance > 2010]
Laufey                           2018.0
Lazav                            2013.0
Leapfrog                         2022.0
Legacy                           2012.0
Legacy (WW2)                     2013.0
                                  ...
Anti-Venom (Klyntar Symbiote)    2017.0
Anton (Cosmoball)                2020.0
Anubis                           2012.0
Ao Oni                           2012.0
Aphrodite-3                      2012.0
Length: 1138, dtype: float64
Nomenclatura
Tecnicamente, l'espressione first_appearance > 2010 genera una nuova serie
che ha lo stesso indice di first_appearance e in cui i valori sono True in
corrispondenza degli anni successivi al 2010 e False altrimenti. Questa nuova
serie viene utilizzata per filtrare first_appearance.
Vediamo ora come utilizzando le serie sia molto più semplice calcolare e
visualizzare le frequenze assolute: il metodo value_counts restituisce
un'altra serie in cui gli indici sono i valori osservati e i valori le
corrispondenti frequenze assolute, ordinate in senso non crescente.
first_appearance.value_counts()
2021.0    140
2018.0    115
2019.0    108
2012.0    107
2013.0     93
         ...
2099.0      1
1935.0      1
1950.0      1
1932.0      1
1933.0      1
Name: count, Length: 93, dtype: int64
Va notato come il tipo delle frequenze sia, correttamente, intero e come i
valori mancanti siano automaticamente esclusi dal calcolo delle frequenze,
mentre sono sempre presenti gli outlier. Per ottenere una serie i cui
elementi siano ordinati per valore non decrescente della voce nell'indice è
sufficiente invocare il metodo sort_index; già che ci siamo, è un buon
momento per eliminare i valori fuori scala dal conteggio effettuando una
query sulla serie:
first_app_freq = first_appearance[first_appearance < 2090].value_counts().sort_index()
first_app_freq.head(10)
1928.0     3
1931.0     1
1932.0     1
1933.0     1
1935.0     1
1936.0     1
1938.0     2
1939.0     7
1940.0    17
1941.0    10
Name: count, dtype: int64
5.1.1. Visualizzazione grafica di una serie#
Pandas mette a disposizione l'oggetto plot per visualizzare graficamente i
contenuti di una serie, utilizzando matplotlib dietro le quinte; in
particolare, il metodo bar visualizza un grafico a barre:
# Don't try this at home (men che meno all'esame!)

first_appearance.plot.bar()
plt.show()
Il grafico ottenuto, diciamolo, fa schifo. Questo perché bar considera un
punto per ogni elemento della serie, in cui le ascisse corrispondono alla
posizione (zero per la prima osservazione, uno per la seconda e così via,
sebbene nel grafico sull'asse delle ascisse vengano poi visualizzati i valori
dell'indice) e le ordinate al valore osservato. Per ognuno dei punti così
ottenuti viene poi tracciato un segmento che lo congiunge perpendicolarmente
all'asse delle ascisse. Il risultato è decisamente poco informativo, sia da un
punto di vista grafico (le etichette sull'asse delle ascisse si sovrappongono,
così che non si riesce a leggere nulla), sia da un punto di vista analitico: le
barre hanno altezze simili e quindi le loro differenze sono poco apprezzabili a
colpo d'occhio; inoltre il grafico dipende per esempio dall'ordine in cui sono
elencate le osservazioni e non ci permette di solito di trarre alcuna
informazione sulla relazione che lega tra loro le osservazioni.
Si ottengono dei risultati decisamente più interessanti se si visualizza un grafico analogo per le frequenze assolute:
first_app_freq.plot.bar()
plt.show()
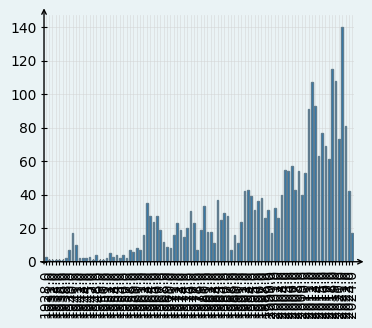
Il grafico ottenuto è sicuramente migliore di quello precedente, ma rimane il problema di leggibilità dell'asse delle ascisse. Ciò è dovuto al fatto che pandas non inserisce le barre sul grafico nelle ascisse corrispondenti agli anni, ma le posiziona una accanto all'altra, come possiamo renderci conto visualizzando un po' meglio solo alcune delle etichette (in prima istanza non è importante capire come venga generato questo grafico, ma se siete curiosi potete leggere l'approfondimento che trovate dopo il commento al grafico stesso):
years = np.arange(1945, 2010, 10)
index_pos = [first_app_freq.index.get_loc(y) for y in years]
first_app_freq.plot.bar()
plt.xticks(index_pos, years)
plt.ylim((0, 18.5))
plt.show()
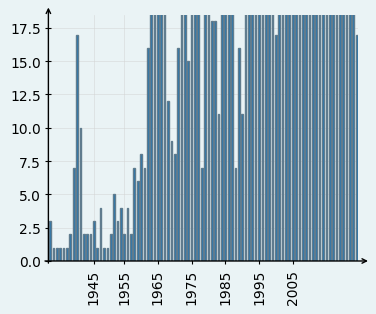
Si può osservare che tra due valori successivi evidenziati nell'asse delle ascisse intercorre una distanza di dieci anni, ma le etichette non risultano equispaziate: ciò è dovuto al fatto che in realtà la prima barra ha ascissa 1, la seconda ha ascissa 2 e così via, mentre le etichette mostrate sull'asse delle ascisse corrispondono ai valori degli indici.
Nomenclatura
Per generare il grafico precedente è necessario utilizzare alcune funzionalità
avanzate delle librerie considerate: np.arange permette di costruire un array
i cui valori vanno di dieci in dieci partendo da 1945 e arrivando a 2005; la
proprietà index di una serie permette di estrarne l'indice e il metodo
get_loc di quest'ultimo restituisce la posizione corrispondente a un dato
valore dell'indice. Infine, il metodo xticks di matplotlib permette di
specificare quali valori evidenziare sull'asse delle ascisse e quali etichette
utilizzare.
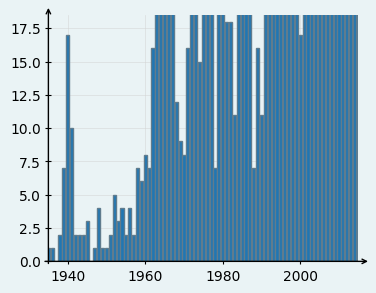
Per ottenere un grafico simile in cui le ascisse siano effettivamente gli anni
di prima apparizione è necessario tornare a utilizzare esplicitamente
matplotlib, passando al metodo bar rispettivamente l'indice e i valori della
serie, che si ottengono rispettivamente utilizzando la proprietà index e
invocando il metodo get_values.
plt.bar(first_app_freq.index, first_app_freq.values)
plt.xlim((1935, 2015))
plt.ylim(0, 18.5)
plt.show()
5.1.2. Operazioni con le serie#
Consideriamo le seguenti domande:
Quanti supereroi sono apparsi dopo il 1960?
Quanti tra il 1940 e il 1965?
Quanti dopo il 1970?
Per rispondere alla prima domanda dobbiamo isolare le frequenze che corrispondono agli anni di apparizione che vanno dal 1960 in avanti. Notiamo che l'indice della serie contiene i valori degli anni; è quindi possibile utilizzare l'accesso tramite list slicing per recuperare le frequenze degli anni di apparizione che vanno dal 1960 in avanti:
first_app_freq[1960:]
/tmp/ipykernel_3260/1885720840.py:1: FutureWarning: The behavior of obj[i:j] with a float-dtype index is deprecated. In a future version, this will be treated as positional instead of label-based. For label-based slicing, use obj.loc[i:j] instead
  first_app_freq[1960:]
1960.0      8
1961.0      7
1962.0     16
1963.0     35
1964.0     27
         ...
2020.0     73
2021.0    140
2022.0     81
2023.0     42
2024.0     17
Name: count, Length: 65, dtype: int64
A questo punto è sufficiente invocare la funzione sum sulla sotto-serie
individuata per ottenere la somma delle frequenze:
sum(first_app_freq[1960:])
/tmp/ipykernel_3260/3547051780.py:1: FutureWarning: The behavior of obj[i:j] with a float-dtype index is deprecated. In a future version, this will be treated as positional instead of label-based. For label-based slicing, use obj.loc[i:j] instead
  sum(first_app_freq[1960:])
2514
La seconda domanda trova risposta in modo analogo, filtrando le frequenze degli anni di apparizione tra il 1940 e il 1966:
sum(first_app_freq[1940:1966])
/tmp/ipykernel_3260/3478196715.py:1: FutureWarning: The behavior of obj[i:j] with a float-dtype index is deprecated. In a future version, this will be treated as positional instead of label-based. For label-based slicing, use obj.loc[i:j] instead
  sum(first_app_freq[1940:1966])
222
Analogamente, all'ultima domanda si risponde selezionando gli anni dal 1970 in avanti:
sum(first_app_freq[:1971])
/tmp/ipykernel_3260/266580610.py:1: FutureWarning: The behavior of obj[i:j] with a float-dtype index is deprecated. In a future version, this will be treated as positional instead of label-based. For label-based slicing, use obj.loc[i:j] instead
  sum(first_app_freq[:1971])
303
Nomenclatura
La funzione sum accetta come argomento liste, tuple e serie: in tutti i casi
restituisce la somma dei valori in esse contenute.
Un modo alternativo per calcolare la somma dei valori in una serie è quella di
invocare su di essa l'omonimo metodo sum. Le serie sono inoltre in tutto e
per tutto dei vettori, sui quali è possibile effettuare operazioni algebriche.
Consideriamo per esempio le due serie contenenti altezza e peso dei supereroi:
height = pd.Series([float(h[4]) if h[4] else None for h in heroes], index=names)
weight = pd.Series([float(h[5]) if h[5] else None for h in heroes], index=names)
Una prima categoria di operazioni è quella che si ottiene indicando il nome di una serie all'interno di un'espressione aritmetica: il risultato è una nuova serie ottenuta calcolando l'espressione su tutti gli elementi della serie di partenza. Per esempio, la cella seguente crea la serie contenente l'altezza degli eroi misurata in metri e ne visualizza i primi dieci elementi:
(height/100)[:10]
Laufey               1.00
Laugh-a-Lot Bear     0.45
Laughing Jack        0.01
Laura Moon           0.30
Laura Palmer         1.00
Laura Weathermill    0.01
Lauren Reed          0.01
Lavagirl             0.25
Lavender             1.00
Lavos                1.00
dtype: float64
Quando si considerano operazioni più complicate, è possibile utilizzare il
metodo apply indicando come suo argomento la funzione da applicare agli
elementi della serie. Per esempio, nella cella seguente viene creata una nuova
serie ottenuta esprimendo le altezze dei supereroi in metri e successivamente
elevando il risultato al quadrato.
height.apply(lambda h: (h/100)**2)[:10]
Laufey               1.0000
Laugh-a-Lot Bear     0.2025
Laughing Jack        0.0001
Laura Moon           0.0900
Laura Palmer         1.0000
Laura Weathermill    0.0001
Lauren Reed          0.0001
Lavagirl             0.0625
Lavender             1.0000
Lavos                1.0000
dtype: float64
Un'altra importante categoria di operazioni è quella che vede due serie
indicate come argomenti di un operatore aritmetico binario. In questo caso
verrà ancora creata una nuova serie, in cui l'operazione viene calcolata
elemento per elemento nelle serie indicate. Per esempio, la cella seguente
crea una nuova serie bmi contenente l'indice di massa corporea (BMI) dei
supereroi (ottenuto dividendo il peso specificato in chilogrammi per il
quadrato dell'altezza misurata in metri), e mostra i quindici supereroi con
il BMI più elevato.
bmi = weight / height.apply(lambda h: (h/100)**2)
bmi.sort_values(ascending=False)[:15]
The Top             inf
Captain Napalm      inf
Angel Of Destiny    inf
SCP-606             inf
Typhoon             inf
Ika-ika             inf
Lani-loli           inf
Johnny Storm        inf
Queen Metalia       inf
Kurogiri            inf
Aku-Aku             inf
Akane               inf
Kupuna-wa           inf
Darryl Morris       inf
Maude Pearson       inf
dtype: float64
A parte notare Hulk è solo il quindicesimo della classifica, va sottolineato che le operazioni fatte elemento per elemento allineano i vettori corrispondenti alle serie in base all'indice (e non alla posizione). Consideriamo per esempio la seguente cella, in cui vengono selezionati altezze e pesi più o meno plausibili per un essere umano, calcolando poi i corrispondenti BMI.
standard_weight = weight[(weight < 100) & (weight > 40)]
standard_height = height[(height < 210) & (height > 120)]/100
(standard_weight / (standard_height**2))[:15]
.GIFfany                           NaN
10,000 Volt Ghost                  NaN
5pb.                               NaN
666:Satan                          NaN
A (Fourth Raikage)                 NaN
A-120                              NaN
A-60                               NaN
A-90                               NaN
A-Qing (Sword of the Yue Maiden)   NaN
A.G.O.T.I                          NaN
Aang (Avatar State)                NaN
Abhorash                           NaN
Abnermal                           NaN
Abomination                        NaN
Abomination-2                      NaN
dtype: float64
Si nota un numero relativamente elevato di NaN, e ciò è appunto dovuto al
fatto che il rapporto alla base del calcolo del BMI viene fatto usando peso e
altezza di valori che hanno lo stesso indice. Ora, non è detto che un supereroe
che ha un peso plausibile abbia anche un'altezza plausibile, e viceversa.
Quello che succede quando si esegue un'operazione tra due serie e solo una di
essa è definita in corrispondenza di uno specifico valore dell'indice, il
risultato conterrà NaN per quel valore.