
 Italiano
 English
 Français
 Español
18.5. Indipendenza#
Nel capitolo precedente abbiamo visto come la probabilità condizionata \(\mathbb P(E \mid F)\) quantifichi quanto sapere che si sia verificato un evento \(F\) modifica la probabilità di un altro evento \(E\). In molte situazioni concrete, però, questa influenza è assente: sapere che \(F\) si è verificato non cambia la probabilità di \(E\), come nell'esempio che segue.
Esempio 51
Nel lancio di due dadi bilanciati distinguibili — uno rosso e uno blu, per facilitare il discorso — indichiamo con \(E\) l'evento «il dado blu mostra un risultato minore di \(4\)» e con \(F\) l'evento «il dado rosso mostra un risultato minore di \(4\)». Quando si verifica \(E\), il dado blu può assumere i valori \(1\), \(2\) e \(3\), e come si vede nella Figura 28 l'evento (evidenziato in giallo) contiene \(3 \times 6 = 18\) esiti dei \(36\) equiprobabili, dunque \(\mathbb P(E) = \frac{18}{36} = \frac{1}{2}\). Ipotizzare che si sia verificato \(F\) (colorato in azzurro nella figura) equivale a restringere l'attenzione ai \(18\) esiti nei quali il dado rosso vale \(1\), \(2\) oppure \(3\). In metà di questi, evidenziati in blu scuro, anche il risultato del dado blu è minore di \(4\), quindi \(\mathbb P(E \mid F) = \frac{9}{18} = \frac{1}{2} = \mathbb P(E)\). In altre parole, in metà dei casi considerabili il risultato del dado blu è minore o uguale a \(3\), sia nel caso di incertezza completa (la probabilità non condizionata), sia quando si è verificato \(F\).
import matplotlib as mpl
import matplotlib.pyplot as plt
import numpy as np

rosso, blu = np.meshgrid(range(1, 7), range(1, 7))
rosso, blu = rosso.ravel(), blu.ravel()

IN_E = blu < 4
IN_F = rosso < 4
IN_INTERSEZIONE = IN_E & IN_F
SOLO_E = IN_E & ~IN_F
SOLO_F = IN_F & ~IN_E
FUORI = ~(IN_E | IN_F)

with mpl.rc_context({'figure.figsize': (3, 3),
                'figure.dpi': 150,
                'figure.titlesize': 8,
                'xtick.labelsize': 7,
                'ytick.labelsize': 7,
                'axes.labelsize': 7,}):

   fig, ax = plt.subplots()

   BG_COLOR = '#eaf3f5'
   E_COLOR = '#006699'
   F_COLOR = '#c17f24'
   DOT_COLOR = '#010177'
   EDGE_COLOR = '#010177'

   ax.set_facecolor(BG_COLOR)

   ax.axhspan(0.5, 3.5, facecolor=E_COLOR, alpha=0.28, zorder=0)
   ax.axvspan(0.5, 3.5, facecolor=F_COLOR, alpha=0.30, zorder=0)

   ax.axhline(3.5, color=EDGE_COLOR, linestyle='--', linewidth=1.0, zorder=1)
   ax.axvline(3.5, color=EDGE_COLOR, linestyle='--', linewidth=1.0, zorder=1)

   ax.scatter(rosso[FUORI], blu[FUORI], s=20, c='white',
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=3)
   ax.scatter(rosso[SOLO_E], blu[SOLO_E], s=20, c=E_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.scatter(rosso[SOLO_F], blu[SOLO_F], s=20, c=F_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.scatter(rosso[IN_INTERSEZIONE], blu[IN_INTERSEZIONE],
      s=20, c=DOT_COLOR, edgecolors=EDGE_COLOR, linewidths=0.5, zorder=5)

   ax.text(1.5, 5.5, r"$F \setminus E$", ha='center', va='center', fontsize=7)
   ax.text(5.5, 1.5, r"$E \setminus F$", ha='center', va='center', fontsize=7)
   ax.text(1.5, 1.5, r"$E \cap F$", ha='center', va='center', fontsize=7)

   ax.set_xlabel('Risultato del dado rosso')
   ax.set_ylabel('Risultato del dado blu')
   ax.set_xticks(range(1, 7))
   ax.set_yticks(range(1, 7))
   ax.set_xlim(0.5, 6.5)
   ax.set_ylim(0.5, 6.5)
   ax.grid(True, color=EDGE_COLOR, alpha=0.12)
   ax.set_aspect('equal')
   plt.show()
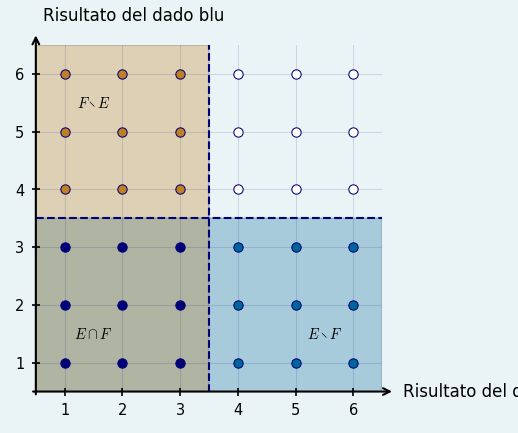
Figura 28 Diagramma di Venn degli eventi \(E =\) «il dado blu mostra un risultato minore di \(4\)» e \(F =\) «il dado rosso mostra un risultato minore di \(4\)» nel lancio di due dadi distinguibili. I \(36\) punti della griglia rappresentano gli elementi dello spazio degli esiti \([1 .. 6]^2\).#
La definizione seguente introduce la nozione di indipendenza tra eventi, che formalizza le situazioni, come quella appena vista, in cui il condizionamento rispetto a un evento non cambia la probabilità risultante.
Definizione 23 (Indipendenza tra due eventi)
Due eventi \(E, F \in \mathsf A\) in uno spazio di probabilità \((\Omega, \mathsf A, \mathbb P)\) si dicono indipendenti se
Ci si potrebbe chiedere come mai la definizione precedente consideri la probabilità dell'intersezione, piuttosto che ragionare direttamente in termini di probabilità condizionate. Sebbene questa scelta possa sembrare poco intuitiva, il lemma seguente mostra che la Definizione 23 equivale alla formulazione più intuitiva dalla quale sono partito.
Lemma 2
Siano \(E, F \in \mathsf A\). Le seguenti condizioni sono equivalenti:
\(\mathbb P(E \cap F) = \mathbb P(E)\mathbb P(F)\),
\(\mathbb P(E \mid F) = \mathbb P(E)\) quando \(\mathbb P(F) > 0\),
\(\mathbb P(F \mid E) = \mathbb P(F)\) quando \(\mathbb P(E) > 0\).
Dimostrazione.
Supponiamo vera la prima condizione e mostriamo che questa implica la seconda. Se \(\mathbb P(F) > 0\), è possibile ragionare in termini della probabilità condizionata \(\mathbb P(E \mid F)\), e
D'altra parte, se \(\mathbb P(F) > 0\) e \(\mathbb P(E \mid F) = \mathbb P(E)\), allora
che equivale a \(\mathbb P(E \cap F) = \mathbb P(E)\mathbb P(F)\). Pertanto, la prima e la seconda condizione si coimplicano.
Analogamente, quando \(\mathbb P(E) > 0\), \(\mathbb P(F \mid E)\) è ben definita e
dunque la prima condizione implica la terza, e l'implicazione inversa si dimostra in modo analogo a quanto visto sopra.
Riassumendo, \(\text{3.} \leftrightarrow \text{1.} \leftrightarrow \text{2.}\), il che significa che le tre condizioni sono logicamente equivalenti.
Il motivo per cui, di solito, si preferisce definire l'indipendenza introducendo la fattorizzazione \(\mathbb P(E \cap F) = \mathbb P(E) \mathbb P(F)\) è legata a diverse ragioni:
intuitivamente ci aspettiamo che ogni evento \(E\) sia indipendente da \(\varnothing\), ma \(\mathbb P(E \mid \varnothing)\) è indefinita, mentre l'intersezione \(E \cap \varnothing\) ha probabilità nulla, così come \(\varnothing\), dunque \(\mathbb P(E \cap \varnothing) = \mathbb P(E) \mathbb P(\varnothing)\) vale anche in questo caso;
la relazione che coinvolge la probabilità condizionata sembra attribuire maggiore importanza all'evento rispetto al quale si condiziona, mentre — al contrario — nessuno dei due eventi svolge un ruolo privilegiato in (18.16), e ciò mette in evidenza un ovvio carattere simmetrico nell'indipendenza (\(E\) è indipendente da \(F\) se e solo se \(F\) è indipendente da \(E\));
infine, la Definizione 23 si estende in modo naturale al caso di più eventi ed è coerente con l'applicazione del concetto di indipendenza al contesto delle variabili aleatorie, come vedremo nel Paragrafo 19.7.
Esempio 52 (Pari e dispari con due dadi)
Nell'esempio precedente, abbiamo \(\mathbb P(E \cap F) = \frac{9}{36} = \frac{1}{4}\) e \(\mathbb P(E) = \mathbb P(F) = \frac{1}{2}\), quindi (18.16) è soddisfatta e, come ci aspettavamo, \(E\) ed \(F\) sono indipendenti.
Esempio 53 (Album di figurine dei supereroi)
Un mazzo contiene \(48\) figurine di supereroi, equamente suddivisi in quattro squadre: Avengers, X-Men, Guardiani della Galassia e Thunderbolts. Dodici di queste figurine rappresentano eroi dotati di visione a raggi X, e sono distribuite uniformemente tra le squadre (dunque, tre per ogni squadra). Consideriamo l'esperimento che consiste nello scegliere a caso una delle figurine dopo aver mescolato il mazzo, e definiamo \(A =\) «la figurina reppresenta un Avenger» e \(V =\) «l'eroe raffigurato ha la visione a raggi X». Il fatto di aver mescolato il mazzo ci permette di ragionare nei termini di uno spazio equiprobabile: \(\mathbb P(A) = \frac{1}{4}\) e \(\mathbb P(V) = \frac{1}{4}\). Inoltre, l'evento \(A \cap V\) contiene le tre figurine degli Avengers con visione a raggi X, quindi \(\mathbb P(A \cap V) = \frac{3}{48} = \frac{1}{16}\) e
Ciò mostra che \(A\) e \(V\) sono indipendenti: conoscere la squadra di appartenenza non fornisce alcuna informazione sul possesso della visione a raggi X, perché tale capacità è distribuita in parti uguali tra le quattro squadre.
Esempio 54
Nell’Esempio 50 abbiamo calcolato
dove \(H =\) «il segnale proviene da Hala» ed \(E =\) «la scansione su Hala è negativa». Perché questi due eventi siano indipendenti occorre che \(\mathbb P(E \mid H) = \mathbb P(E)\), cioè \(\alpha = (\alpha + 1)/2\), cioè \(\alpha = 1\). Pertanto, per ogni \(\alpha \in [0, 1)\) gli eventi \(H\) e \(E\) sono dipendenti, e l'esito della ricerca aggiorna — in misura proporzionale a \(1 - \alpha\) — le probabilità sui tre pianeti.
È importante notare che indipendenza e incompatibilità sono due concetti tipicamente opposti. Infatti, se due eventi \(E\) ed \(F\) sono mutuamente esclusivi, allora per definizione \(E \cap F = \varnothing\) e \(\mathbb P(E \cap F) = 0\). Dunque, a meno che almeno uno dei due eventi sia impossibile, si avrà necessariamente \(\mathbb P(E \cap F) = 0 \neq \mathbb P(E)\mathbb P(F)\). In altre parole, due eventi incompatibili non banali sono sempre dipendenti. D'altronde, sapere che uno si è verificato esclude con certezza l'altro, e infatti \(\mathbb P(E \mid F) = \mathbb P(F \mid E) = 0\): il verificarsi di un evento modifica drasticamente la probabilità dell'altro, portandola a zero.
L'indipendenza, al contrario, è una relazione stabile rispetto al complemento, che è la più naturale operazione insiemistica che si possa applicare a un singolo evento. Se sapere che \(F\) si è verificato non modifica la probabilità di \(E\), allora ci si aspetta che neppure sapere che \(F\) non si è verificato introduca una dipendenza artificiale. In altre parole, passare da un evento al suo complemento non dovrebbe alterare la relazione di indipendenza: il teorema seguente formalizza precisamente questa idea.
Teorema 17
Se \(E\) e \(F\) sono indipendenti, allora \(E\) e \(\overline F\) sono indipendenti.
Dimostrazione.
Poiché \(E = (E \cap F) \cup (E \cap \overline F)\) è un'unione disgiunta (vedi Figura 25), il terzo assioma di Kolmogorov assicura che \(\mathbb P(E) = \mathbb P(E \cap F) + \mathbb P(E \cap \overline F)\), per cui
In modo analogo, dall'indipendenza di \(E\) ed \(F\) si deriva quella di \(\overline E\) e \(F\), così come quella di \(\overline E\) e \(\overline F\).
L'indipendenza si generalizza a terne di eventi in modo non immediato. In particolare, lL'esempio seguente mostra che l'indipendenza tra tutte le possibili coppie degli eventi non implica l'indipendenza dei tre eventi, intesa in senso congiunto: in altre parole, è possibile che quando vengono considerati a due a due, gli eventi siano indipendenti, sebbene i tre eventi siano tra loro «legati» in modo sottile.
Esempio 55
Nel lancio di due dadi bilanciati distinguibili — diciamo, uno rosso e uno blu — consideriamo i seguenti eventi:
\(E =\) «la somma dei risultati dei due dadi è \(7\)»,
\(F =\) «il risultato del dado rosso è \(4\)»,
\(G =\) «il risultato del secondo dado è \(3\)».
La Figura 29 mostra il diagramma di Venn di questi tre eventi nello spazio degli esiti: \(E\), \(F\) e \(G\) sono rispettivamente rappresentati dal rettangolo posizionato diagonalmente, da quello che si vede sulla colonna centrata sull'ascissa \(4\) e da quello che corrisponde alla riga associata all'ordinata \(3\). Si verifica facilmente che ognuno dei tre eventi contiene esattamente sei esiti, dunque ognuno di essi ha probabilità uguale a \(\frac{1}{6}\). La figura mostra anche che l'intersezione di due qualsiasi tra \(E\), \(F\) e \(G\) coincide con l'insieme \(\{ (4, 3) \}\). Pertanto, per esempio,
e analogamente \(\mathbb P(E \cap G) = \mathbb P(E)\mathbb P(G)\) e \(\mathbb P(F \cap G) = \mathbb P(F)\mathbb P(G)\): due eventi in ognuna delle possibili coppie sono dunque indipendenti. Tuttavia, l'intersezione \(F \cap G\) si verifica se e solo se il risultato del dado rosso è \(4\) e quello del dado blu è \(3\), il che implica che la somma dei risultati è esattamente uguale a \(7\). Sapere quindi che si sono verificati \(F\) e \(G\) permette di asserire che \(E\) si è sicuramente verificato, e
In altre parole, la conoscenza del verificarsi di \(F\) e \(G\) in modo congiunto fornisce un'informazione su \(E\) che né \(F\) né \(G\) da soli riuscivano a trasmettere. Quindi i tre eventi non si possono considerare congiuntamente indipendenti.
import matplotlib as mpl
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import Polygon

rosso, blu = np.meshgrid(range(1, 7), range(1, 7))
rosso, blu = rosso.ravel(), blu.ravel()

IN_E = rosso + blu == 7
IN_F = rosso == 4
IN_G = blu == 3
IN_ALL = IN_E & IN_F & IN_G
SOLO_E = IN_E & ~IN_F & ~IN_G
SOLO_F = IN_F & ~IN_E & ~IN_G
SOLO_G = IN_G & ~IN_E & ~IN_F
FUORI = ~(IN_E | IN_F | IN_G)

with mpl.rc_context({'figure.figsize': (3.4, 3.4),
                'figure.dpi': 150,
                'figure.titlesize': 8,
                'xtick.labelsize': 7,
                'ytick.labelsize': 7,
                'axes.labelsize': 7,}):

   fig, ax = plt.subplots()

   BG_COLOR = '#eaf3f5'
   E_COLOR = '#006699'
   F_COLOR = '#c17f24'
   G_COLOR = '#888888'
   DOT_COLOR = '#010177'
   EDGE_COLOR = '#010177'

   ax.set_facecolor(BG_COLOR)

   ax.add_patch(
      Polygon(
         [(0.5, 6.0), (1.0, 6.5), (6.5, 1.0), (6.0, 0.5)],
         closed=True,
         facecolor=E_COLOR,
         edgecolor='none',
         alpha=0.22,
         zorder=0,
      )
   )
   ax.axvspan(3.5, 4.5, facecolor=F_COLOR, alpha=0.24, zorder=0)
   ax.axhspan(2.5, 3.5, facecolor=G_COLOR, alpha=0.24, zorder=0)

   ax.plot([0.5, 6.5], [6.5, 0.5], color=EDGE_COLOR,
      linestyle='--', linewidth=1.0, zorder=1)
   ax.axvline(4, color=EDGE_COLOR, linestyle='--', linewidth=1.0, zorder=1)
   ax.axhline(3, color=EDGE_COLOR, linestyle='--', linewidth=1.0, zorder=1)

   ax.scatter(rosso[FUORI], blu[FUORI], s=20, c='white',
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=3)
   ax.scatter(rosso[SOLO_E], blu[SOLO_E], s=22, c=E_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.scatter(rosso[SOLO_F], blu[SOLO_F], s=22, c=F_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.scatter(rosso[SOLO_G], blu[SOLO_G], s=22, c=G_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.scatter(rosso[IN_ALL], blu[IN_ALL], s=28, c=DOT_COLOR,
      edgecolors=EDGE_COLOR, linewidths=0.6, zorder=5)

   ax.text(1.1, 6.15, r'$E$', color=E_COLOR, fontsize=7,
      ha='left', va='bottom')
   ax.text(4.08, 6.15, r'$F$', color=F_COLOR, fontsize=7,
      ha='left', va='bottom')
   ax.text(6.18, 3.08, r'$G$', color=G_COLOR, fontsize=7,
      ha='left', va='bottom')
   ax.annotate(r'$(4,3)$', xy=(4, 3), xytext=(4.6, 4.0), fontsize=7,
      color=EDGE_COLOR,
      arrowprops={'arrowstyle': '->', 'color': EDGE_COLOR, 'lw': 0.8},
      ha='left', va='bottom')

   ax.set_xlabel('Risultato del dado rosso')
   ax.set_ylabel('Risultato del dado blu')
   ax.set_xticks(range(1, 7))
   ax.set_yticks(range(1, 7))
   ax.set_xlim(0.5, 6.5)
   ax.set_ylim(0.5, 6.5)
   ax.grid(True, color=EDGE_COLOR, alpha=0.12)
   ax.set_aspect('equal')
   plt.show()
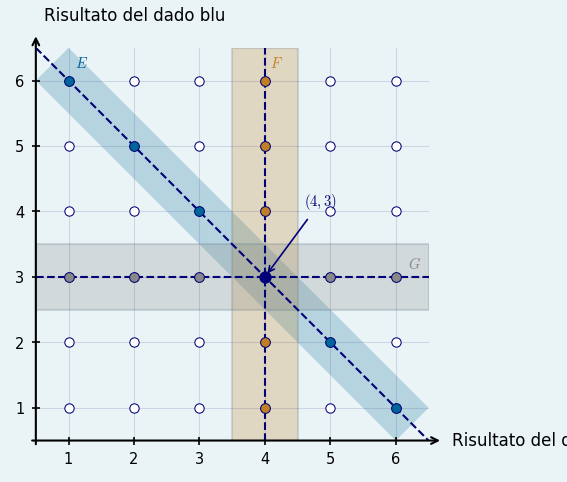
Figura 29 Diagramma di Venn degli eventi \(E =\) «la somma dei due risultati è \(7\)», \(F =\) «il primo dado mostra \(4\)» e \(G =\) «il secondo dado mostra \(3\)» nel lancio di due dadi distinguibili. Il punto in blu scuro corrisponde all'unico esito che appartiene contemporaneamente a tutti e tre gli eventi.#
L'esempio precedente mostra come l'estensione del concetto di indipendenza a più di due eventi non possa essere ingenuamente fatta solo considerando le coppie di questi eventi. La definizione corretta, formalizzata qui sotto, richiede che (18.16) si estenda a ogni sottoinsieme di eventi, piuttosto che valere per le sole coppie.
Definizione 24 (Indipendenza mutua)
Fissato uno spazio di probabilità \((\Omega, \mathsf A, \mathbb P)\) e \(m \in \mathbb N\), gli eventi \(E_1, \ldots, E_m \in \mathsf A\) si dicono indipendenti se per ogni sottoinsieme di indici \(1 \leq \alpha_1 < \alpha_2 < \cdots < \alpha_r \leq m\), con \(r > 1\), vale
In pratica, l'indipendenza mutua è spesso assunta come ipotesi modellistica — tipicamente quando si descrivono esperimenti fisicamente separati o azioni di agenti distinti — piuttosto che verificata a partire dalla definizione.
Esempio 56
Nel caso considerato nell’Esempio 55, \(m = 3\) e la condizione sugli indici nella Definizione 24 individua quattro possibili sequenze strettamente crescenti con \(r > 1\), elencate nel prospetto che segue.
Sequenza di indici |
Sottoinsieme di eventi |
Condizione da verificare |
|---|---|---|
\((\alpha_1=1, \alpha_2=2)\) |
\((E_1=E, E_2=F)\) |
\(\mathbb P(E \cap F) = \mathbb P(E)\mathbb P(F)\) |
\((\alpha_1=1, \alpha_2=3)\) |
\((E_1=E, E_3=G)\) |
\(\mathbb P(E \cap G) = \mathbb P(E)\mathbb P(G)\) |
\((\alpha_1=2, \alpha_2=3)\) |
\((E_2=F, E_3=G)\) |
\(\mathbb P(F \cap G) = \mathbb P(F)\mathbb P(G)\) |
\((\alpha_1=1, \alpha_2=2, \alpha_3=3)\) |
\((E_1=E, E_2=F, E_3=G)\) |
\(\mathbb P(E \cap F \cap G) = \mathbb P(E)\mathbb P(F)\mathbb P(G)\) |
Le prime tre condizioni, relative alle coppie \((E, F)\), \((E, G)\) e \((F, G)\), sono soddisfatte, mentre quella associata alla tripla \(E \cap F \cap G\) non vale, in quanto
Una conseguenza importante della Definizione 24 è che ognuno degli eventi considerati resta indipendente anche da qualunque evento costruito a partire dagli altri: per esempio, se \(E\), \(F\) e \(G\) sono indipendenti, allora \(E\) è indipendente da \(F \cup G\), da \(F \cap G\), da \(\overline F \cup G\) e così via.
Esempio 57
Supponiamo che \(E\), \(F\) e \(G\) siano indipendenti nel senso della Definizione 24. Allora, in particolare,
e le coppie \((E,F)\), \((E,G)\) e \((F,G)\) sono indipendenti. Si può facilmente mostrare che \(E\) è indipendente da \(F \cap G\): basta osservare che
dove nell'ultimo passaggio si è usata l'indipendenza di \(F\) e \(G\). Si può anche dimostrare che \(E\) è indipendente da \(F \cup \overline G\), ma la derivazione richiede un po' più di perizia. Applicando la distributività dell'intersezione sull'unione e il Teorema 7 si ottiene innanzitutto che
Per il Teorema 17, dall'indipendenza di \(E\) e \(G\) segue che
Inoltre, come mostra la Figura 30, poiché \(E \cap F = (E \cap F \cap G) \cup (E \cap F \cap \overline G)\) e l'unione considerata è disgiunta, si ha
Sostituendo queste espressioni e sfruttando l'indipendenza tra \(F\) e \(\overline G\) si ricava
Quindi \(E\) è indipendente da \(F \cup \overline G\).
import matplotlib.pyplot as plt
import matplotlib.patches as patches
from matplotlib_venn import venn3, venn3_circles

BG_COLOR = '#eaf3f5'
EDGE_COLOR = '#010177'
TOP_FILL = '#e8d0a0'
BOTTOM_FILL = '#d6e4f7'
OTHER_FILL = '#ffffff'
FONT_SIZE = 7

fig, ax = plt.subplots(figsize=(5.2, 3.8), facecolor=BG_COLOR)
ax.set_facecolor(BG_COLOR)

box = patches.Rectangle((-0.88, -0.82), 1.76, 1.64,
                        edgecolor=EDGE_COLOR,
                        facecolor=BG_COLOR,
                        linewidth=0.8,
                        zorder=0)
#ax.add_patch(box)

v = venn3(subsets=(1, 1, 1, 1, 1, 1, 1),
          set_labels=(r'$E$', r'$F$', r'$G$'),
          ax=ax)
c = venn3_circles(subsets=(1, 1, 1, 1, 1, 1, 1), ax=ax)

for label in v.set_labels:
    if label is not None:
        label.set_fontsize(FONT_SIZE)
        label.set_color(EDGE_COLOR)

for contour in c:
    contour.set_lw(0.8)
    contour.set_edgecolor(EDGE_COLOR)

for region_id in ['100', '010', '001', '101', '011']:
    patch = v.get_patch_by_id(region_id)
    label = v.get_label_by_id(region_id)
    if patch is not None:
        patch.set_color(OTHER_FILL)
        patch.set_alpha(0.35)
    if label is not None:
        label.set_text('')

patch_110 = v.get_patch_by_id('110')
patch_111 = v.get_patch_by_id('111')
if patch_110 is not None:
    patch_110.set_color(BOTTOM_FILL)
    patch_110.set_alpha(0.95)
if patch_111 is not None:
    patch_111.set_color(TOP_FILL)
    patch_111.set_alpha(0.95)

label_110 = v.get_label_by_id('110')
label_111 = v.get_label_by_id('111')
if label_110 is not None:
    label_110.set_text(r'$E \cap F \cap \overline{G}$')
    label_110.set_fontsize(6)
    label_110.set_color(EDGE_COLOR)
if label_111 is not None:
    label_111.set_text(r'$E \cap F \cap G$')
    label_111.set_fontsize(6)
    label_111.set_color(EDGE_COLOR)


plt.show()
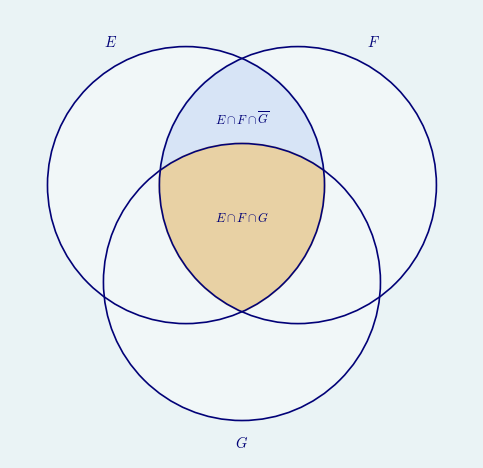
Figura 30 Diagramma di Venn di tre insiemi \(E\), \(F\) e \(G\). Le due regioni evidenziate corrispondono a \(E \cap F \cap \overline G\) e a \(E \cap F \cap G\): sono disgiunte e, prese insieme, ricostruiscono esattamente l'intersezione \(E \cap F\).#
Un'applicazione classica dell'indipendenza tra più eventi riguarda l’affidabilità di sistemi composti da più componenti. In particolare, supponiamo che un sistema contenga \(m\) componenti che funzionano ognuno in modo indipendente dagli altri, e per \(i = 1, \dots, m\) indichiamo con \(p_i\) la probabilità dell'evento \(C_i\) che si verifica quando l’\(i\)-esimo componente funziona. La Figura 31 mostra schematicamente le due architetture più semplici per questi sistemi:
nei sistemi in serie i componenti sono collegati sequenzialmente, per cui basta che anche solo uno di essi sia guasto affinché l'intero sistema non riesca a produrre un output, e l'evento \(F =\) «il sistema funziona» si verifica se e solo se tutti i componenti stanno funzionando, dunque ha probabilità
nei sistemi in parallelo, al contrario, tutti i componenti sono ognuno una replica degli altri, per cui il sistema produce un output se e solo se almeno uno dei componenti funziona, dunque
In entrambi i casi, la condizione di indipendenza è fondamentale per ricavare in modo semplice la probabilità di funzionamento del sistema.
import matplotlib as mpl
import matplotlib.pyplot as plt
from matplotlib.patches import Circle, FancyBboxPatch

with mpl.rc_context({'figure.figsize': (7.2, 2.8),
                'figure.dpi': 150,
                'figure.titlesize': 9,
                'font.size': 8,}):

   BG_COLOR = '#eaf3f5'
   EDGE_COLOR = '#010177'
   COMPONENT_FILL = '#d6e4f7'
   NODE_FILL = '#ffffff'
   WIRE_ZORDER = 1
   COMPONENT_ZORDER = 3
   NODE_ZORDER = 4
   LABEL_ZORDER = 5

   fig, (ax1, ax2) = plt.subplots(1, 2)
   fig.patch.set_facecolor(BG_COLOR)

   def setup_axis(ax, title):
      ax.set_facecolor(BG_COLOR)
      ax.set_xlim(0, 10)
      ax.set_ylim(0, 6)
      ax.set_aspect('equal')
      ax.axis('off')
      ax.set_title(title, color=EDGE_COLOR, pad=8)

   def draw_node(ax, xy, label):
      ax.add_patch(Circle(xy, 0.18, facecolor=NODE_FILL,
         edgecolor=EDGE_COLOR, linewidth=1.1, zorder=NODE_ZORDER))
      ax.text(xy[0], xy[1] - 0.45, label, ha='center', va='top', color=EDGE_COLOR,
         zorder=LABEL_ZORDER)

   def draw_component(ax, x, y, label, fill):
      ax.add_patch(FancyBboxPatch((x, y), 1.5, 0.9,
         boxstyle='round,pad=0.05,rounding_size=0.12',
         facecolor=fill, edgecolor=EDGE_COLOR, linewidth=1.1,
         zorder=COMPONENT_ZORDER))
      ax.text(x + 0.75, y + 0.45, label, ha='center', va='center', color=EDGE_COLOR,
         zorder=LABEL_ZORDER)

   setup_axis(ax1, 'Sistema in serie')
   draw_node(ax1, (0.9, 3.0), 'ingresso')
   draw_node(ax1, (9.1, 3.0), 'uscita')
   ax1.plot([1.08, 2.0], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   draw_component(ax1, 2.0, 2.55, r'$C_1$', COMPONENT_FILL)
   ax1.plot([3.5, 4.2], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   draw_component(ax1, 4.2, 2.55, r'$C_2$', COMPONENT_FILL)
   ax1.plot([5.7, 6.4], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   draw_component(ax1, 6.4, 2.55, r'$C_3$', COMPONENT_FILL)
   ax1.plot([7.9, 8.92], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)

   setup_axis(ax2, 'Sistema in parallelo')
   draw_node(ax2, (0.9, 3.0), 'ingresso')
   draw_node(ax2, (9.1, 3.0), 'uscita')
   ax2.plot([1.08, 2.0], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   ax2.plot([2.0, 2.0], [1.4, 4.6], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   ax2.plot([8.0, 8.0], [1.4, 4.6], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)
   COMPONENT_X = 4.25
   for y, label in [(4.15, r'$C_1$'), (2.55, r'$C_2$'), (0.95, r'$C_3$')]:
      ax2.plot([2.0, COMPONENT_X], [y + 0.45, y + 0.45], color=EDGE_COLOR,
         linewidth=1.6, zorder=WIRE_ZORDER)
      draw_component(ax2, COMPONENT_X, y, label, COMPONENT_FILL)
      ax2.plot([COMPONENT_X + 1.5, 8.0], [y + 0.45, y + 0.45], color=EDGE_COLOR,
         linewidth=1.6, zorder=WIRE_ZORDER)
   ax2.plot([8.0, 8.92], [3.0, 3.0], color=EDGE_COLOR, linewidth=1.6, zorder=WIRE_ZORDER)

   plt.tight_layout(w_pad=1.2)
   plt.show()
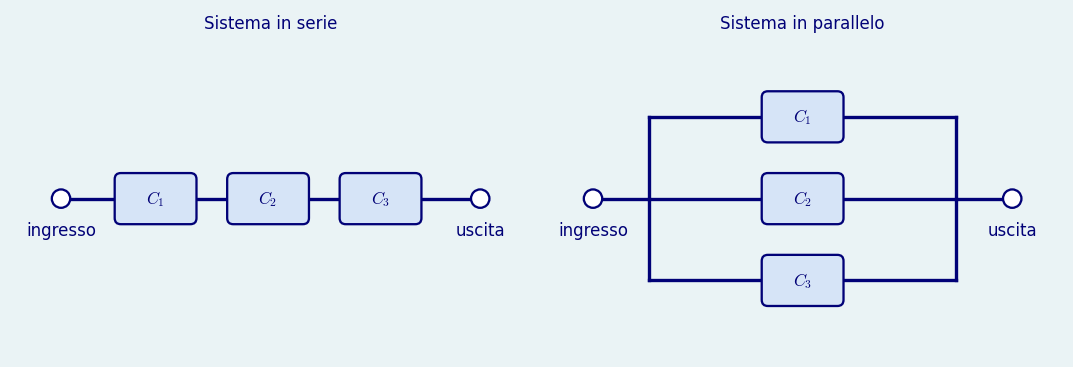
Figura 31 Schematizzazione delle architetture in serie (a sinistra) e in parallelo (a destra) di un sistema contenente tre componenti, per i quali gli eventi \(C_1\), \(C_2\), e \(C_3\) si verificano quando essi funzionano.#
Esempio 58 (La squadra dei Thunderbolts)
I Thunderbolts, guidati da Songbird, devono infiltrarsi in una base nemica. La missione ha successo solo se tutte e tre le fasi seguenti, che sono tra loro indipendenti, vanno a buon fine:
Componente |
Responsabile |
Probabilità di successo |
|---|---|---|
Ricognizione |
Songbird |
\(0.9\) |
Hacking |
Moonstone |
\(0.85\) |
Estrazione |
Mach-X |
\(0.95\) |
Lo sviluppo della missione è quindi assimilabile al comportamento di un sistema in serie (assumendo per esempio l'ordine Ricognizione \(\rightarrow\) Hacking \(\rightarrow\) Estrazione). La probabilità di portarla a termine con successo è quindi
Se invece bastasse che almeno uno dei tre eroi riuscisse nella propria fase, la missione sarebbe descritta da un sistema in parallelo, e la probabilità di successo diventerebbe
In altre parole, la ridondanza insita nel sistema in parallelo trasforma un sistema con probabilità di successo del \(72.7\%\) in uno quasi infallibile. La differenza tra i due casi è legata al fatto che nel primo sistema basta il fallimento di una sola fase per compromettere l'intera missione.
18.5.1. Classificatori naive Bayes#
Una semplice applicazione del teorema di Bayes, combinata con un'ipotesi di indipendenza condizionata tra proprietà osservate, permette di costruire i cosiddetti classificatori naive Bayes. Per fissare le idee, iniziamo considerando il caso più semplice, in cui per ogni individuo si osserva una sola proprietà binaria e si vuole predire una classe, anch'essa binaria. Indichiamo con \(E\) l'evento «l'individuo appartiene alla classe di interesse» e con \(F\) l'evento «l'individuo possiede la proprietà osservata». Il teorema di Bayes ci dice allora che
Se conoscessimo le tre probabilità che compaiono al secondo membro, potremmo calcolare la probabilità a posteriori e usarla per classificare gli individui per i quali osserviamo \(F\): un valore elevato di \(\mathbb P(E \mid F)\) favorirebbe l'associazione alla classe \(E\), mentre un valore basso suggerirebbe di associare l'individuo alla classe complementare \(\overline E\). Normalmente, non conosciamo queste probabilità, ma abbiamo a disposizione un dataset che contiene informazioni relative al verificarsi di \(E\) ed \(F\) per un numero relativamente elevato di individui. Possiamo quindi fare riferimento all'accezione frequentista, e approssimare le tre probabilità utilizzando le frequenze relative con cui si osservano i corrispondenti eventi. In particolare,
\(\mathbb P(F \mid E)\) si può approssimare calcolando la frequenza relativa con cui la proprietà \(F\) compare tra gli individui della classe \(E\);
\(\mathbb P(E)\) e \(\mathbb P(F)\) si possono approssimare mediante le frequenze marginali con cui si osservano, rispettivamente, la classe \(E\) e la proprietà \(F\).
Questo modo di procedere potrebbe sembrare un po' artificiale, dato che nel dataset l'attributo descritto dall'evento \(E\) è già presente. Tuttavia, in alcuni casi il valore di questo attributo potrebbe essere mancante, oppure in futuro potremmo voler aggiungere nuovi personaggi per i quali questa informazione non è disponibile. Disporre di un classificatore capace di produrre una previsione della classe ci può aiutare a risolvere i problemi che emergono in situazioni di questo tipo.
Esempio 59
Nel dataset dei supereroi, consideriamo l'esperimento che consiste nello scegliere uniformemente a caso un personaggio e introduciamo gli eventi:
\(M =\) «il supereroe appartiene a un universo Marvel»;
\(N =\) «il supereroe ha gli occhi neri».
In questo contesto, stimare \(\mathbb P(M \mid N)\) significa valutare quanto sia plausibile attribuire alla Marvel un supereroe di cui si sa soltanto che ha gli occhi neri. Caricando il dataset e calcolando le stime sopra descritte, si ottengono i risultati indicati di seguito.
import pandas as pd
import numpy as np

heroes = pd.read_csv('data/heroes.csv', index_col=0)

marvel_heroes = heroes[heroes['creator']=='Marvel Comics']
p_M = len(marvel_heroes) / len(heroes)

black_eyes_heroes = heroes[heroes['eye_color']=='Black']
p_N = len(black_eyes_heroes) / len(heroes)

blackeyes_and_marvel_heroes = heroes[
    (heroes['creator'] == 'Marvel Comics') &
    (heroes['eye_color'] == 'Black')
]

p_N_given_M = len(blackeyes_and_marvel_heroes) / len(marvel_heroes)

print(f'ℙ(M) = {p_M:.2f}')
print(f'ℙ(N) = {p_N:.2f}')
print(f'ℙ(N|M) = {p_N_given_M:.2f}')
ℙ(M) = 0.18
ℙ(N) = 0.07
ℙ(N|M) = 0.04
Applicando il teorema di Bayes si ottiene quindi che la probabilità di trovarsi di fronte a un supereroe Marvel, dato che questo ha gli occhi neri, può essere approssimata come segue.
p_M_given_N = p_N_given_M * p_M / p_N
print(f'ℙ(M|N) = {p_M_given_N:.2f}')
ℙ(M|N) = 0.11
Dunque, nel dataset corrente, gli occhi neri non sono affatto una proprietà neutra rispetto all'editore: sapere che un supereroe ha gli occhi neri porta la probabilità a posteriori di appartenenza alla Marvel a circa \(0.11\), quindi ben al di sotto sia di \(\frac{1}{2}\) sia della probabilità a priori \(\mathbb P(M)\). In altre parole, l'osservazione di occhi neri orienta piuttosto verso l'ipotesi complementare. In modo analogo si può infatti stimare anche \(\mathbb P(\overline M \mid N)\).
nonmarvel_heroes = heroes[heroes['creator'] != 'Marvel Comics']
blackeyes_and_nonmarvel_heroes = heroes[
    (heroes['creator'] != 'Marvel Comics') &
    (heroes['eye_color'] == 'Black')
]

p_noM = len(nonmarvel_heroes) / len(heroes)
p_N_given_noM = len(blackeyes_and_nonmarvel_heroes) / len(nonmarvel_heroes)

p_noM_given_N = p_N_given_noM * p_noM / p_N
print(f'ℙ(not M|N) = {p_noM_given_N:.2f}')
ℙ(not M|N) = 0.89
Il risultato complementare conferma ciò che ci aspettavamo: nel dataset considerato, un supereroe con occhi neri ha probabilità circa \(0.89\) di non appartenere a un universo Marvel.
Supponiamo ora di voler mantenere la stessa classificazione binaria tra \(E\) e \(\overline E\), ma di osservare non più una sola proprietà binaria, bensì due proprietà categoriche non binarie \(F\) e \(G\). Indicando con \(F = f\) e \(G = g\) gli eventi che si verificano quando un individuo presenta la combinazione di valori \((f, g)\) per le due proprietà, il teorema di Bayes assume la forma
Per costruire un classificatore naive Bayes si ipotizza che, una volta fissata la classe, le due proprietà osservate siano indipendenti. Si tratta di un'assunzione oggettivamente poco verosimile, che infatti viene indicata come ingenua (da cui l'aggettivo naive nel nome del classificatore). Ciò nonostante, in alcune applicazioni questi classificatori si rivelano efficaci. Anche quando non offrono le prestazioni migliori, restano comunque utili come metodo di riferimento semplice con cui confrontare metodi più sofisticati. In particolare, applichiamo l'approssimazione
In questo modo, nel numeratore, è richiesto di stimare le probabilità condizionate relative a ciascuna delle due proprietà presa separatamente. Più precisamente, se indichiamo con \(|F|\) e \(|G|\) il numero di differenti valori per queste proprietà, per calcolare tutti i possibili valori di (18.18) bisogna stimare \(|F| + |G|\) diverse probabilità. Ciò è quasi sempre meno oneroso rispetto all'applicazione diretta del teorema di Bayes, che richiede invece di stimare \(|F| |G|\) probabilità condizionate: una per ogni coppia \((f, g)\) di valori degli attributi coinvolti.
Esempio 60
Estendiamo la costruzione del classificatore naive Bayes applicato al dataset dei supereroi iniziata nell'Esempio 59, scegliendo ora come proprietà osservate il colore degli occhi \(O\) e il colore dei capelli \(C\). Per un supereroe con occhi e capelli neri si ottiene quindi
Nell'Esempio 59 abbiamo già stimato \(\mathbb P(M)\); le probabilità rimanenti vengono stimate nella cella seguente, derivando quelle mancanti in modo analogo.
black_eyes_and_hair = heroes[
    (heroes['eye_color'] == 'Black') &
    (heroes['hair_color'] == 'Black')
]
p_OC = len(black_eyes_and_hair) / len(heroes)

blackhair_and_marvel_heroes = heroes[
    (heroes['creator'] == 'Marvel Comics') &
    (heroes['hair_color'] == 'Black')
]
p_C_given_M = len(blackhair_and_marvel_heroes) / len(marvel_heroes)

p_M_given_OC = p_N_given_M * p_C_given_M * p_M / p_OC

print(f'ℙ(M|O=neri ∩ C=neri) = {p_M_given_OC:.2f}')
ℙ(M|O=neri ∩ C=neri) = 0.05
Il risultato ci dice che vi è una bassa probabilità di avere a che fare con un supereroe Marvel se i suoi occhi e i suoi capelli sono neri. Ripetendo lo stesso procedimento per alcune configurazioni frequenti di colori di occhi e capelli presenti nel dataset, si ottiene la tabella riportata di seguito.
import numpy as np
import pandas as pd
from IPython.display import HTML, display

heroes = pd.read_csv('data/heroes.csv', index_col=0)
marvel_heroes = heroes[heroes['creator'] == 'Marvel Comics']
p_M = len(marvel_heroes) / len(heroes)

eye_counts_given_marvel = marvel_heroes['eye_color'].value_counts()
hair_counts_given_marvel = marvel_heroes['hair_color'].value_counts()

configurations = (
   heroes.dropna(subset=['eye_color', 'hair_color'])
        .groupby(['eye_color', 'hair_color'])
        .size()
        .sort_values(ascending=False)
        .head(10)
        .reset_index(name='count')
)

posterior_values = []
for eye_color, hair_color, frequency in configurations.itertuples(index=False):
   p_eye_and_hair = frequency / len(heroes)
   p_eye_given_marvel = (eye_counts_given_marvel.get(eye_color, 0)
                         / len(marvel_heroes))
   p_hair_given_marvel = (hair_counts_given_marvel.get(hair_color, 0)
                          / len(marvel_heroes))
   posterior_values.append(
      p_eye_given_marvel * p_hair_given_marvel * p_M / p_eye_and_hair
   )

configurations['P(M|O,C)'] = [f'{value:.3f}' for value in posterior_values]
configurations = configurations[['eye_color', 'hair_color', 'P(M|O,C)']]
configurations = configurations.rename(columns={
   'eye_color': 'O',
   'hair_color': 'C'
})

table_html = configurations.to_html(
   index=False,
   border=0,
   classes=['table', 'left-align']
)
table_html = table_html.replace(
   'class="dataframe table left-align"',
   'class="table left-align"'
)
table_html = table_html.replace(' style="text-align: right;"', '')
table_html = (
   '<div class="pst-scrollable-table-container">'
   + table_html
   + '</div>'
)
display(HTML(table_html))
| O | C | P(M|O,C) |
|---|---|---|
| Blue | Blond | 0.095 |
| Brown | Black | 0.113 |
| Brown | Brown | 0.083 |
| Blue | Black | 0.234 |
| Black | Black | 0.051 |
| Red | No Hair | 0.071 |
| Blue | Brown | 0.209 |
| Black | No Hair | 0.086 |
| Green | Black | 0.220 |
| Blue | White | 0.137 |
I risultati mostrano che l’aggiunta di una seconda proprietà rende la stima più selettiva: in molte delle configurazioni più frequenti, la probabilità a posteriori di appartenere all’universo Marvel è maggiore o uguale a quella ottenuta nell’esempio precedente. Tuttavia, i valori ottenuti restano sensibilmente inferiori a \(\frac{1}{2}\) e non consentono quindi di associare con ragionevole affidabilità un supereroe alla Marvel. Al contrario, in alcuni casi tali valori sono sufficientemente bassi da permettere di escludere con una certa confidenza che un supereroe sia pubblicato dalla Marvel.
Riformulando il ragionamento seguito finora in termini generali, supponiamo di osservare per un individuo i valori \(x_1, \dots, x_n\) delle proprietà \(X_1, \dots, X_n\), e di volerlo associare a una tra le classi \(y_1, \dots, y_m\). Se, per \(k = 1, \dots, m\), indichiamo con \(Y =y_k\) l'evento che si verifica quando l'individuo appartiene alla \(k\)-esima classe, l'ipotesi alla base dei classificatori naive Bayes si scrive allora come
e applicandola al teorema di Bayes si ottiene
Dopo aver calcolato questa formula per tutte le \(k\) classi, la predizione fatta dal classificatore naive Bayes è quella che coinvolge la classe per cui la probabilità a posteriori è massima. Poiché il denominatore in (18.19) non dipende da \(k\), è sufficiente massimizzare il numeratore nella formula. Come anticipato nella nota precedente, questo permette di effettuare la classificazione stimando solo le \(\sum_{i=1}^n |X_i|\) probabilità condizionate relative alle singole proprietà, piuttosto che considerare le \(\prod_{i=1}^n |X_i|\) configurazioni congiunte di tutte le proprietà. Concludendo, il classificatore naive Bayes predice che l'individuo appartiene alla classe \(y_{k^*}\), dove
Esempio 61
Come già visto per gli alberi di decisione (vedi il
Paragrafo 10.3), il package sklearn mette a disposizione
classi che permettono di costruire direttamente un classificatore naive Bayes.
Per illustrarne l'uso, estraiamo dal dataset le colonne di interesse ed
eliminiamo le righe con valori mancanti nelle colonne selezionate. Limitiamo
inoltre l'analisi ai personaggi classificati esplicitamente come buoni
(Good) o cattivi (Bad), escludendo quelli con allineamento neutro o non
specificato, e rimuoviamo i personaggi con peso o altezza anomali rispetto alla
norma umanoide, che altererebbero le distribuzioni stimate dal modello.
Convertiamo infine gli attributi non scalari, usando anche in questo caso
LabelEncoder.
from sklearn.preprocessing import LabelEncoder

features = ['height', 'weight', 'first_appearance',
            'hair_color', 'eye_color', 'strength', 'intelligence']
heroes_cleaned = heroes.dropna(subset=features)
heroes_cleaned = heroes_cleaned[
    heroes_cleaned['alignment'].isin(['Good', 'Bad']) &
    (heroes_cleaned['weight'] < 500) &
    (heroes_cleaned['height'] < 300)
]
X = heroes_cleaned[features].copy()

for col in ['hair_color', 'eye_color', 'intelligence']:
    X[col] = LabelEncoder().fit_transform(X[col])
Introduciamo ora la variabile di classe, codificando come True i
personaggi con allineamento buono (Good) e come False quelli con
allineamento cattivo (Bad).
Y = (heroes_cleaned['alignment'] == 'Good')
In sklearn sono implementate diverse varianti del classificatore naive Bayes,
ognuna delle quali modella in modo diverso le probabilità
\(\mathbb P(X_i = x_i \mid Y = y_k)\). Di seguito considero la classe
GaussianNB, che assume un modello gaussiano per tali probabilità (e che
approfondiremo nel Paragrafo 21.4). Come negli esempi precedenti,
il classificatore si costruisce invocando il metodo fit sulle osservazioni e
sulle corrispondenti etichette, e le predizioni si ottengono successivamente,
utilizzando il metodo predict. Per semplicità, mi limito qui a osservare il
comportamento del classificatore sui dati usati per costruirlo, rinviando ad
altre sezioni una discussione più accurata sulla validazione di questo tipo di
modelli.
from sklearn.naive_bayes import GaussianNB

model = GaussianNB()
model.fit(X, Y)

predictions = model.predict(X)
print(f'Numero di predizioni positive: {predictions.sum()}')
print(f'Numero di individui: {len(predictions)}')
Numero di predizioni positive: 702
Numero di individui: 889
Il risultato mostra che la maggior parte delle osservazioni viene classificata come personaggi buoni, ma che il classificatore assegna comunque un numero significativo di individui alla classe dei cattivi. Per descrivere meglio questo comportamento, consideriamo separatamente le predizioni sulle osservazioni delle due classi, visualizzando la matrice di confusione.
from sklearn import metrics

fig, ax = plt.subplots(figsize=(2.6, 2.3))

metrics.ConfusionMatrixDisplay.from_predictions(
   Y,
   predictions,
   labels=[True, False],
   display_labels=['Buoni', 'Cattivi'],
   cmap='Blues',
   colorbar=False,
   values_format='d',
   ax=ax,
)

ax.set_xlabel('Classe predetta')
ax.set_ylabel('Classe reale')
ax.set_title('Matrice di confusione')
ax.tick_params(axis='y', labelrotation=90)
ax.grid(False)
plt.tight_layout()
plt.show()
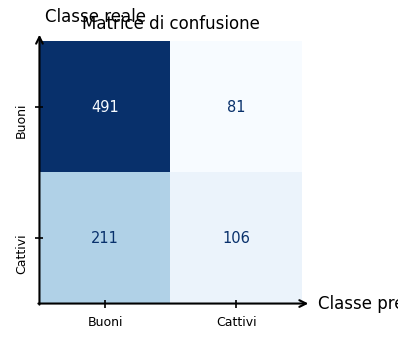
La matrice mostra che il classificatore riconosce con buona approssimazione i personaggi buoni, mentre fatica maggiormente con quelli cattivi: circa un terzo dei cattivi viene identificato correttamente, mentre i rimanenti vengono classificati come buoni. Il modello ha quindi una tendenza a sovrastimare la classe degli eroi buoni, riflettendo peraltro lo sbilanciamento del dataset (circa il \(64 \%\) degli eroi sono buoni). Per riassumere il risultato in un unico indice, possiamo calcolare l'accuratezza del classificatore.
metrics.accuracy_score(Y, predictions)
0.671541057367829
Questo valore va però interpretato con cautela: la valutazione è svolta sugli stessi dati usati per costruire il classificatore. Il risultato è quindi utile soprattutto per illustrare il funzionamento della libreria e del modello, più che per formulare un giudizio conclusivo sulla sua qualità predittiva.
18.5.2. Vero o falso?#
Analizzate ciascuna delle seguenti affermazioni sul concetto di indipendenza, e dite se è vera o falsa, motivando il vostro ragionamento. Cliccate su di essa per visualizzare la risposta corretta.
Se \(\mathbb P(F) > 0\), allora \(E\) e \(F\) sono indipendenti se e solo se \(\mathbb P(E \mid F) = \mathbb P(E)\).
Vera. Questa è una delle condizioni equivalenti alla definizione \(\mathbb P(E \cap F) = \mathbb P(E) \mathbb P(F)\), come mostrato nel Lemma 2. Quando \(\mathbb P(F) > 0\), dividere entrambi i membri per \(\mathbb P(F)\) trasforma la definizione nell'uguaglianza \(\mathbb P(E \mid F) = \mathbb P(E)\): conoscere \(F\) non modifica la probabilità di \(E\).
Due eventi non banali mutuamente esclusivi sono sempre indipendenti.
Falsa. È vero il contrario: se \(E\) e \(F\) sono disgiunti e \(\mathbb P(E) > 0\), \(\mathbb P(F) > 0\), allora \(\mathbb P(E \cap F) = 0\) mentre \(\mathbb P(E) \mathbb P(F) > 0\), quindi la definizione di indipendenza non è soddisfatta. In altri termini, sapere che \(F\) si è verificato esclude completamente \(E\), rendendo i due eventi fortemente dipendenti.
Se \(E\) e \(F\) sono indipendenti, allora \(E\) e \(\bar F\) sono indipendenti.
Vera. Il Teorema 17 garantisce che l'indipendenza è stabile rispetto alla complementazione: se \(\mathbb P(E \cap F) = \mathbb P(E) \mathbb P(F)\), allora anche \(\mathbb P(E \cap \bar F) = \mathbb P(E) \mathbb P(\bar F)\). La dimostrazione sfrutta la decomposizione \(E = (E \cap F) \cup (E \cap \bar F)\) e la \(\sigma\)-additività.
L'indipendenza a coppie implica l'indipendenza mutua.
Falsa. L'Esempio 55 mostra un controesempio esplicito: gli eventi \(E\) (somma 7), \(F\) (dado rosso mostra 4) e \(G\) (dado blu mostra 3) sono a due a due indipendenti, ma non sono mutuamente indipendenti perché \(\mathbb P(E \mid F \cap G) = 1 \neq \frac{1}{6} = \mathbb P(E)\). Per l'indipendenza mutua occorre che la proprietà di fattorizzazione valga per tutti i sottoinsiemi di eventi, non solo per le coppie.
In un sistema parallelo di \(m\) componenti indipendenti, la probabilità di funzionamento aumenta al crescere di \(m\).
Vera. La probabilità di funzionamento di un sistema parallelo è \(1 - \prod_{i=1}^m (1-p_i)\). Aggiungere un nuovo componente con probabilità \(p_{m+1} \in (0, 1)\) moltiplica il prodotto per \((1-p_{m+1}) < 1\), riducendo \(\prod_{i=1}^{m+1}(1-p_i)\) e quindi aumentando \(1 - \prod_{i=1}^{m+1}(1-p_i)\). Il sistema funziona finché almeno una componente funziona, quindi più componenti ci sono, maggiore è la ridondanza.
Se \(\mathbb P(E \cap F) = 0\), \(\mathbb P(E) > 0\) e \(\mathbb P(F) > 0\), allora \(E\) e \(F\) sono indipendenti.
Falsa. L'indipendenza richiede \(\mathbb P(E \cap F) = \mathbb P(E) \mathbb P(F)\). Se \(\mathbb P(E) > 0\) e \(\mathbb P(F) > 0\), allora \(\mathbb P(E) \mathbb P(F) > 0\), ma per ipotesi \(\mathbb P(E \cap F) = 0\). I due valori sono diversi, quindi \(E\) e \(F\) sono dipendenti. In realtà \(\mathbb P(E \cap F) = 0\) con entrambe le probabilità positive è il caso di eventi disgiunti non banali, che — come visto sopra — sono sempre dipendenti.
18.5.3. Esercizi#
Esercizio 132 (••)
Nell'Esempio 53, si consideri l'evento \(\overline A =\) «la figurina non appartiene agli Avengers».
Calcolate \(\mathbb P(\overline A \cap V)\) direttamente.
Verificate dalla definizione che \(\overline A\) e \(V\) sono indipendenti.
Ottenete lo stesso risultato applicando il Teorema 17.
Solution to Esercizio 132 (••)
Le figurine in \(\overline A \cap V\) sono le \(9\) con visione a raggi X appartenenti alle tre squadre diverse dagli Avengers (\(3\) per ciascuna), quindi \(\mathbb P(\overline A \cap V) = \frac{9}{48} = \frac{3}{16}\).
La condizione (18.16) risulta verificata, perché:
Poiché \(A\) e \(V\) sono indipendenti (come dimostrato nell'Esempio 53), il Teorema 17 garantisce direttamente che lo siano anche \(\overline A\) e \(V\).
Esercizio 133 (••)
Supponete che \(E\) e \(F\) siano indipendenti.
Dimostrate dalla definizione che \(\overline E\) ed \(F\) sono indipendenti.
Dimostrate che anche \(\overline E\) e \(\overline F\) sono indipendenti.
Solution to Esercizio 133 (••)
Per quanto riguarda il primo punto, poiché \(F = (E \cap F) \cup (\overline E \cap F)\) e l'unione considerata riguarda eventi disgiunti, si ha \(\mathbb P(F) = \mathbb P(E \cap F) + \mathbb P(\overline E \cap F)\), e quindi
Dunque \(\overline E\) e \(F\) sono indipendenti. Ciò permette di dimostrare rapidamente anche il secondo punto: applicando il Teorema 17 alla coppia \(\overline E\), \(F\), si conclude immediatamente che anche \(\overline E\) e \(\overline F\) sono indipendenti. Equivalentemente, partendo dalle leggi di De Morgan si può verificare direttamente che
e anche in questo caso la condizione (18.16) è soddisfatta.
Esercizio 134 (••)
Songbird e Moon Knight pattugliano indipendentemente due quartieri distinti di New York. La probabilità che Songbird incontri un criminale durante il turno è \(\frac{1}{3}\); quella di Moon Knight è \(\frac{1}{4}\).
Qual è la probabilità che entrambi incontrino un criminale?
Qual è la probabilità che almeno uno dei due ne incontri uno?
Qual è la probabilità che solo Moon Knight incontri un criminale?
Solution to Esercizio 134 (••)
Siano \(S =\) «Songbird incontra un criminale» e \(M =\) «Moon Knight incontra un criminale», con \(\mathbb P(S) = \frac{1}{3}\), \(\mathbb P(M) = \frac{1}{4}\), e indipendenti per ipotesi.
Per la condizione (18.16):
Per il Teorema 7:
L'evento «solo Moon Knight incontra un criminale» si può indicare come \(M \cap \overline S\). Per il Teorema 17, \(M\) e \(\overline S\) sono indipendenti, quindi
Esercizio 135 (•••)
Darkhawk utilizza una tuta controllata da tre amuleti indipendenti, ciascuno con probabilità \(p\) di funzionare correttamente in combattimento. La tuta è operativa se almeno due dei tre amuleti funzionano.
Esprimete \(\mathbb P(\text{la tuta è operativa})\) in funzione di \(p\).
Per quale valore di \(p\) la probabilità di operatività supera \(\frac{1}{2}\)?
Confrontate con la probabilità di operatività con quella di un'altra tuta, in cui i tre amuleti funzionano in serie, ognuno con probabilità \(p\). Per quali valori di \(p\) è più affidabile il primo tipo di tuta?
Solution to Esercizio 135 (•••)
Sia \(A_i\) l'evento «l'amuleto \(i\) funziona», per \(i = 1, 2, 3\). Avremo \(\mathbb P(A_i) = p\), e questi eventi sono indipendenti per ipotesi.
L'evento si verifica quando tutti i tre amuleti funzionano (cosa che succede con probabilità \(\mathbb P(A_1 \cap A_2 \cap A_3) = p^3\)), oppure quando ne funzionano esattamente due (e questo evento ha probabilità \(\mathbb P((A_1 \cap A_2) \cup (A_1 \cap A_3) \cup (A_2 \cap A_3)) = 3 p^2(1-p\))$). Mettendo insieme questi risultati si ottiene
Se poniamo \(f(p) = 3p^2 - 2p^3\), basta valutare quando \(f(p) > \frac{1}{2}\). Siccome \(f(\frac{1}{2}) = \frac{1}{2}\), e \(f'(p) = 6p(1-p) > 0\) per \(p \in [0, 1]\), \(f\) è crescente e quindi la probabilità di operatività supera \(\frac{1}{2}\) se e solo se \(p > \frac{1}{2}\).
Per una tuta i cui componenti funzionano in serie, si avrà \(\mathbb P(\text{la tuta è operativa}) = p^3\). Affinché quest'ultima tuta sia la meno performante, dorà valere \(f(p) \geq p^3\), che equivale a \(p^2(1-p) \geq 0\). Ma quest'ultima relazione è sempre verificata quando \(p \in [0, 1]\), dunque la tuta con gli amuleti organizzati in serie non avrà mai prestazioni migliori.
Esercizio 136 (•••)
Nel contesto del classificatore naive Bayes introdotto in questo capitolo, cercate di motivare perché l'ipotesi di indipendenza tra le proprietà osservate, una volta fissata la classe, sia oggettivamente poco verosimile. Per esempio, nel dataset dei supereroi potete ragionare sul perché più attributi osservati simultaneamente, come colore degli occhi, colore dei capelli, altezza o forza, difficilmente si comportino come grandezze indipendenti anche dopo aver fissato l'allineamento del personaggio.
Solution to Esercizio 136 (•••)
Il punto chiave è che l'appartenenza a una classe dipende spesso da pattern che coinvolgono congiuntamente più attributi, e non soltanto dai singoli attributi considerati separatamente. In altri termini, l'informazione discriminante può essere contenuta nella configurazione complessiva \((x_1, \dots, x_n)\) delle proprietà osservate, e non nei singoli valori \(x_1, \dots, x_n\) presi uno alla volta.
In termini probabilistici, ciò significa che, anche fissando la classe \(Y = y_k\), non ci si aspetta in generale che valga esattamente
perché la probabilità della configurazione congiunta \((x_1, \dots, x_n)\) può contenere informazione discriminante che non è recuperabile dal solo prodotto delle probabilità marginali condizionate dei singoli attributi. L'ipotesi naive trascura proprio queste interazioni tra attributi: è utile come semplificazione, e facilita i conti, ma è oggettivamente poco verosimile quando la classe è associata a combinazioni caratteristiche di più proprietà.
18.5.4. Concetti fondamentali#
Pensate ai concetti fondamentali illustrati in questo paragrafo ed elencateli. Nella lista qui sotto sono già presenti gli stessi concetti, ma nascosti. Cliccate sul pulsante per mostrarli sotto forma di parole chiave, quindi confrontateli con la vostra lista. Provate infine a descrivere ciascun concetto con parole vostre.