
 Italiano
 English
 Français
 Español
12. Trasformazione dei dati#
Può succedere di avere la necessità di trasformare i dati osservati per diverse ragioni: per poterli confrontare con altri riportandoli ad un intervallo predefinito, per poter confrontare la loro distribuzione di frequenza con quella di altri dati, oppure per renderli più facilmente leggibili.
Consideriamo un insieme di valori osservati \(X = \{ x_1, x_2, \dots, x_n \}\), con la rispettiva tabella di frequenze relative.
Valori originali |
Frequenze relative |
|---|---|
\(x_1\) |
\(f_1\) |
\(x_2\) |
\(f_2\) |
\(\vdots\) |
\(\vdots\) |
\(x_n\) |
\(f_n\) |
Consideriamo anche una trasformazione \(g\) che trasforma i valori di \(X\) in valori appartenenti all'insieme \(Y=\{x_1',x_2',\dots, x_n'\}\): più precisamente \(\forall i=1, \dots, n\) si ha \(g(x_i) = x_i'\) (quando il nome della funzione si potrà omettere, scriveremo per brevità \(x_i \mapsto x_i'\)). Prenderemo in esame solo trasformazioni iniettive (per le quali cioè a qualsiasi valore trasformato in \(Y\) corrisponde un solo valore in \(X\)). Per questo tipo di trasformazioni i valori delle frequenze nella tabella delle frequenze per \(Y\) rimangono ovviamente i medesimi delle loro preimmagini.
Valori trasformati |
Frequenze relative |
|---|---|
\(x'_1\) |
\(f_1\) |
\(x'_2\) |
\(f_2\) |
\(\vdots\) |
\(\vdots\) |
\(x'_n\) |
\(f_n\) |
Cambieranno invece alcuni indici descrittivi e di conseguenza il grafico della distribuzione: infatti ora i valori osservati sono quelli dell'insieme \(Y\).
12.1. Trasformazioni lineari#
Consideriamo la famiglia delle trasformazioni che prevedono di applicare ai dati una funzione lineare. Fissate cioè due costanti \(a, b \in \mathbb R\), il valore originale \(x\) verrà trasformato in un valore \(x'\) secondo la regola:
Cambiamento di origine (traslazione)#
Se vogliamo traslare i dati di una quantità costante \(k>0\) applichiamo la trasformazione \(x \mapsto x'=x - k\) per traslare verso sinistra e \(x \mapsto x'=x + k\) per traslare verso destra. Questa trasformazione è utile quando i valori osservati sono molto grandi e poco dispersi. Si osservi che:
la media, la mediana e i quantili vengono traslati della stessa quantità \(k\) (nel medesimo verso);
il range, la distanza interquartile, la varianza e la deviazione standard dell'insieme traslato \(Y\) rimangono invece gli stessi dell'insieme di partenza \(X\).
Esercizio
Utilizzando le definizione degli indici viste in precedenza, dimostrate le proprietà sopra elencate.
Vediamo due esempi, caricndo innanzitutto il nostro dataset e estraendo da esso le osservazioni per anno di prima apparizione e indice di forza. Per evitare di modificare i dati originali, lavoreremo su delle copie da cui elimineremo inoltre i valori mancanti.
import pandas as pd
import numpy as np

heroes = pd.read_csv('data/heroes.csv', index_col=0)

year = heroes['first_appearance'].copy()
year = year[pd.notnull(year)]

strength = heroes['strength'].copy()
strength = strength[pd.notnull(strength)]
Per applicare una trasformazione a una serie di dati è di norma sufficiente scrivere la corrispondente espressione in funzione della serie stessa. Per esempio, la seguente cella applica agli anni di prima apparizione una funzione in modo che i dati trasformati partano da zero. In questo caso, la costante \(k\) coinciderà con il minimo dei valori osservati e la traslazione verrà fatta verso sinistra.
transformed_year = year - min(year)
transformed_year.iloc[:10]
id
Laufey             90.0
Layla Miller       77.0
Lazav              85.0
Leapfrog           94.0
Leatherface        46.0
Leeloo             69.0
Legacy             84.0
Legacy (WW2)       85.0
Legion             57.0
Leon S. Kennedy    70.0
Name: first_appearance, dtype: float64
Analogamente, impostando \(k\) alla media campionaria di una serie e traslando verso sinistra, i valori trasformati avranno media campionaria nulla. La cella seguente effettua tale operazione sugli indici di forza.
transformed_strength = strength - strength.mean()
transformed_strength.iloc[:10]
id
Laufey               55.121694
Laugh-a-Lot Bear      0.121694
Laughing Jack       -43.878306
Laura Moon          -14.878306
Laura Palmer         55.121694
Laura Weathermill   -43.878306
Lauren Reed         -43.878306
Lavagirl            -19.878306
Lavender             55.121694
Lavos                55.121694
Name: strength, dtype: float64
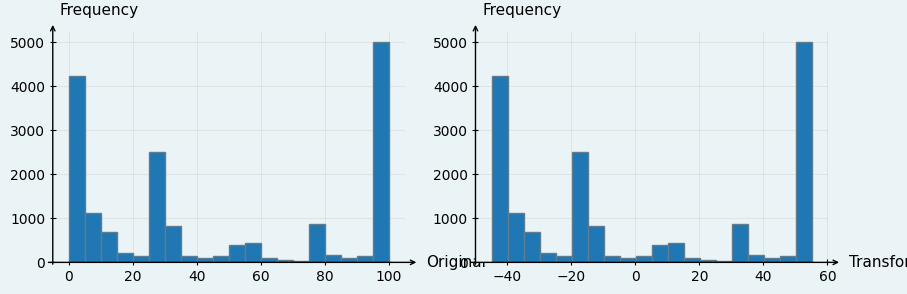
Come già sottolineato, la traslazione è una trasformazione iniettiva e quindi i dati osservati varieranno ma le loro frequenze resteranno uguali. Ciò è evidente se si visualizzano per esempio le tabelle delle frequenze assolute dei dati originali e di quelli trasformati.
pd.crosstab(index=strength,
            columns=['Abs. freqence'],
            colnames=['Original']).iloc[:10]
| Original | Abs. freqence |
|---|---|
| strength | |
| 0 | 1331 |
| 1 | 2901 |
| 5 | 662 |
| 6 | 217 |
| 7 | 12 |
| 8 | 200 |
| 9 | 25 |
| 10 | 294 |
| 11 | 12 |
| 12 | 2 |
pd.crosstab(index=transformed_strength,
            columns=['Abs. freqence'],
            colnames=['Transformed']).iloc[:10]
| Transformed | Abs. freqence |
|---|---|
| strength | |
| -44.878306 | 1331 |
| -43.878306 | 2901 |
| -39.878306 | 662 |
| -38.878306 | 217 |
| -37.878306 | 12 |
| -36.878306 | 200 |
| -35.878306 | 25 |
| -34.878306 | 294 |
| -33.878306 | 12 |
| -32.878306 | 2 |
Analogamente, una visualizzazione grafica dei dati originali avrebbe la stessa forma di quella relativa ai dati trasformati: le frequenze sono infatti invariate, e l'unica differenza consisterebbe nei valori riportati sull'asse delle ascisse. Lo si vede facilmente affiancando per esempio gli istogrammi degli indici di forza originali e trasformati.
plt.figure(figsize=(10, 3))
plt.subplot(1, 2, 1)
strength.plot.hist(bins=20)
plt.xlabel('Original')
plt.subplot(1, 2, 2)
transformed_strength.plot.hist(bins=20)
plt.xlabel('Transformed')
plt.show()
Cambiamento di scala (dilatazione o contrazione)#
Se vogliamo dilatare o contrarre i valori di un fattore costante \(h \in \mathbb R^+\) applichiamo la trasformazione \(x \mapsto x' = \frac{x}{h}\). Se \(h > 1\) il range dei valori risulta diminuito (è cioè stata applicata una contrazione), mentre se \(h < 1\) si applica una dilatazione (il caso \(h = 1\) è poco interessante perché la funzione corrispondente lascia i dati inalterati). Inoltre, se \(h\) è minore del valore minimo, allora tutti i valori trasformati saranno maggiori di \(1\), mentre se \(h\) è maggiore del valore massimo, tutti i valori trasformati saranno minori di \(1\).
Si osservi che:
la media, la mediana e i quantili vengono scalati della stessa quantità \(\frac{1}{h}\);
il range di variazione e la distanza interquartile vengono scalati della stessa quantità \(\frac{1}{h}\);
la varianza viene scalata di una quantità \(\frac{1}{h^2}\) mentre la deviazione standard viene scalata di \(\frac{1}{h}\).
Esercizio
Anche in questo caso, dimostrare le proprietà sopra elencate utilizzando le definizioni degli indici coinvolti.
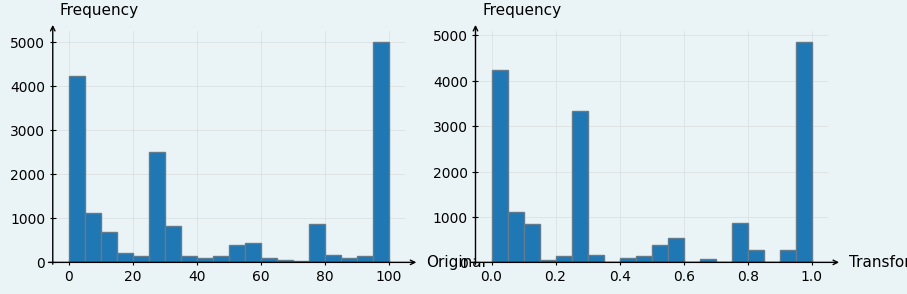
Come nel caso delle traslazioni, anche per applicare un cambiamento di scala è sufficiente eseguire la corrispondente operazione aritmetica sulla serie coinvolta. Per esempio, nella cella seguente una copia degli indici di forza originali (da cui anche in questo caso vengono eliminati i valori mancanti) vengono contratti utilizzando un fattore per cui \(h\) corrisponde al massimo tra i valori originali. Tenuto conto del fatto che questi ultimi sono non negativi, ciò implica che i dati trasformati varieranno nell'intervallo \([0, 1]\).
strength = heroes['strength'].copy()
strength = strength[pd.notnull(strength)]

transformed_strength = strength / max(strength)
transformed_strength.iloc[:10]
id
Laufey               1.00
Laugh-a-Lot Bear     0.45
Laughing Jack        0.01
Laura Moon           0.30
Laura Palmer         1.00
Laura Weathermill    0.01
Lauren Reed          0.01
Lavagirl             0.25
Lavender             1.00
Lavos                1.00
Name: strength, dtype: float64
Anche in questo caso si verifica facilmente come la tabella delle frequenze varia solo relativamente ai valori osservati, così come gli istogrammi avranno la medesima forma e gli stessi valori sull'asse delle ordinate, ma varieranno su un intervallo diverso se si considera l'asse delle ascisse.
pd.crosstab(index=transformed_strength,
            columns=['Abs. freqence'],
            colnames=['Transformed']).iloc[:10]
| Transformed | Abs. freqence |
|---|---|
| strength | |
| 0.00 | 1331 |
| 0.01 | 2901 |
| 0.05 | 662 |
| 0.06 | 217 |
| 0.07 | 12 |
| 0.08 | 200 |
| 0.09 | 25 |
| 0.10 | 294 |
| 0.11 | 12 |
| 0.12 | 2 |
plt.figure(figsize=(10, 3))
plt.subplot(1, 2, 1)
strength.plot.hist(bins=20)
plt.xlabel('Original')
plt.subplot(1, 2, 2)
transformed_strength.plot.hist(bins=20)
plt.xlabel('Transformed')
plt.show()
Cambiamento di origine e scala#
Se abbiamo un insieme di valori nell'intervallo \((a, b)\) e vogliamo adattarli in modo che appartengano all'intervallo \((c, d)\), la trasformazione da applicare sarà
Esercizio
Utilizzando la formula della retta passante per due punti dati, ricavate la trasformazione.
Immaginiamo che risulti più pratico misurare la forza dei supereroi in una scala che va da \(-10\) a \(10\). La trasformazione relativa corrisponderà ai valori \(c = -10\), \(d = 10\) e rispettivamente al minimo e al massimo dei valori originali per quanto riguarda \(a\) e \(b\).
strength = heroes['strength'].copy()
strength = strength[pd.notnull(strength)]

old_min = min(strength)
old_max = max(strength)
new_min = -10.0
new_max = 10.0

transformed_strength = new_min + (new_max - new_min)/(old_max - old_min) * (strength - old_min)
transformed_strength.iloc[:10]
id
Laufey               10.0
Laugh-a-Lot Bear     -1.0
Laughing Jack        -9.8
Laura Moon           -4.0
Laura Palmer         10.0
Laura Weathermill    -9.8
Lauren Reed          -9.8
Lavagirl             -5.0
Lavender             10.0
Lavos                10.0
Name: strength, dtype: float64
Ipotizziamo che i valori originali varino nell'intervallo [a,b] e consideriamo i seguenti casi particolari:
vogliamo trasportare i valori in \([0,1]\): in questo caso la trasformazione da applicare è
nel caso particolare \(a = 0\), la trasformazione precedente consiste nel dividere i dati per il valore massimo \(b\);
vogliamo trasportare i valori nell'intervallo \([-1,1]\); la trasformazione sarà pertanto
Standardizzazione#
La standardizzazione (o normalizzazione) è un caso particolare di cambiamento di origine e scala, e consiste nell'applicare una scala il cui fattore è uguale alla deviazione standard dei valori, per poi traslare verso sinistra rispetto alla media dei valori. Se indichiamo rispettivamente con \(\overline x\) e con \(\sigma_x\) la media campionaria e la deviazione standard campionaria dei valori, la trasformazione sarà quindi
La trasformazione di standardizzazione trasforma pertanto l'insieme dei valori in un altro insieme di valori la cui media è \(0\) e la cui varianza è \(1\).
Esercizio
Si controlli che le proprietà sopra menzionate sono soddisfatte.
L'operazione di standardizzazione dei valori di forza dà luogo alla serie seguente:
transformed_strength = (strength - strength.mean()) / strength.std()
transformed_strength.iloc[:10]
id
Laufey               1.352920
Laugh-a-Lot Bear     0.002987
Laughing Jack       -1.076959
Laura Moon          -0.365177
Laura Palmer         1.352920
Laura Weathermill   -1.076959
Lauren Reed         -1.076959
Lavagirl            -0.487898
Lavender             1.352920
Lavos                1.352920
Name: strength, dtype: float64
Questa trasformazione dovrebbe avere l'effetto di rendere nulla la media campionaria dei dati trasformati.
transformed_strength.mean()
Il risultato non deve essere particolarmente sconcertante: il fatto di non aver ottenuto un valore esattamente nullo è dovuto al fatto che le operazioni fatte sulle variabili in virgola mobile richiedono di effettuare delle approssimazioni numeriche. In ogni caso, i dati originali hanno un ordine di grandezza che è quindici volte più grande del valore della media campionaria, per cui quest'ultima è per noi essenzialmente equivalente a zero.
Trasformazioni logaritmiche#
A volte i valori di una variabile osservata sono molto grandi oppure molto distanziati. In questi casi può essere utile considerare non tanto il valore originale ma, pensando a tale valore come potenza di una data base, ragionare in termini del relativo esponente. Ciò corrisponde ad applicare una trasformazione logaritmica del seguente tipo:
La scelta della base del logaritmo in questa trasformazione viene di norma fatta a seconda delle situazioni che si affrontano: scelte comunemente utilizzate sono 10, la costante di Napier \(\mathrm e \approx 2.71\) oppure 2.
Nel caso i valori siano molto distanziati tra loro e caratterizzati da una distribuzione di frequenza unimodale fortemente asimmetrica, la trasformazione logaritmica permette di ottenere una distribuzione di frequenza pià simmetrica. Questo tipo di trasformazione ha molti altri vantaggi, dovuti al fatto che l'operazione di prodotto (o quoziente) tra due valori viene trasformata nella somma (o nella differenza) dei rispettivi logaritmi.
Consideriamo per esempio i primi dieci anni di prima apparizione nel nostro dataset e applichiamo loro una trasformazione logaritmica usando 10 come base.
pd.crosstab(index=np.log10(year),
            columns=['Abs. freqence'],
            colnames=['Transformed']).iloc[:10]
| Transformed | Abs. freqence |
|---|---|
| first_appearance | |
| 3.285107 | 3 |
| 3.285782 | 1 |
| 3.286007 | 1 |
| 3.286232 | 1 |
| 3.286681 | 1 |
| 3.286905 | 1 |
| 3.287354 | 2 |
| 3.287578 | 7 |
| 3.287802 | 17 |
| 3.288026 | 10 |
Anche in questo caso l'iniettività della trasformazione assicura che le frequenze di dati originali e dati trasformati coincidono.
pd.crosstab(index=year,
            columns=['Abs. freqence'],
            colnames=['Original']).iloc[:10]
| Original | Abs. freqence |
|---|---|
| first_appearance | |
| 1928.0 | 3 |
| 1931.0 | 1 |
| 1932.0 | 1 |
| 1933.0 | 1 |
| 1935.0 | 1 |
| 1936.0 | 1 |
| 1938.0 | 2 |
| 1939.0 | 7 |
| 1940.0 | 17 |
| 1941.0 | 10 |