
 Italiano
 English
 Français
 Español
19.1. Concetti fondamentali#
Come ho anticipato a inizio capitolo, spesso un esperimento casuale si descrive meglio non nei termini dell'esito in sé, ma attraverso un numero che ne cattura un aspetto rilevante — e sul quale possiamo poi operare con strumenti matematici, ove ciò abbia senso. La definizione seguente dà forma precisa a questo passaggio dall'esito al numero, introducendo la nozione di variabile aleatoria.
Definizione 25 (Variabile aleatoria)
Dato uno spazio di probabilità \((\Omega, \mathsf A, \mathbb P)\), una variabile aleatoria è una funzione \(X \colon \Omega \to \mathbb R\) tale che, per ogni \(x \in \mathbb R\), l'insieme \(X^{-1}(x) = \{\omega \in \Omega : X(\omega) \leq x\}\) appartiene a \(\mathsf A\), ed è quindi un evento.
In linea di principio, il passaggio logico corretto consiste nell'eseguire l'esperimento casuale, osservarne l'esito e applicare a quest'ultimo la funzione \(X\), ottenendo così un numero reale. Le variabili aleatorie presentano però un importante vantaggio pratico: una volta definita la corrispondenza tra esiti e valori numerici, spesso non è più necessario fare esplicito riferimento all'esperimento casuale sottostante. Possiamo invece concentrarci direttamente sulla variabile aleatoria stessa, immaginando di osservarla e di ottenere come risultato un valore \(x \in \mathbb{R}\). In questo senso, la variabile aleatoria diventa l'oggetto principale di studio, mentre i dettagli dell'esperimento che l'ha generata passano in secondo piano.
_
Per convenzione, le variabili aleatorie sono indicate con lettere maiuscole, come \(X\), \(Y\) e \(Z\), mentre i valori da esse assunti, che per brevità vengono spesso detti realizzazioni o _osservazioni, sono indicati con le corrispondenti lettere minuscole, come \(x\), \(y\) e \(z\). Ciò permette di ragionare su espressioni come \(X = x\), \(X \leq x\) e così via. Questa distinzione tra lettere maiuscole e minuscole è uno standard quasi universale nella teoria della probabilità e nella statistica.
La condizione richiesta dalla definizione precedente, detta di misurabilità, garantisce che a ogni domanda della forma «\(X\) è minore o uguale di \(x\)?» corrisponda un evento ben definito, e quindi una probabilità. Più precisamente, la probabilità dell'evento \(\{ \omega \in \Omega \mid X(\omega) \leq x \}\), che come anticipato indicherò con la notazione abbreviata \(X \leq x\). Vedremo che questo modo di procedere si estende anche a tutti gli eventi individuati da una condizione sui valori assunti da \(X\): per esempio, potremmo considerare \(X = x\), \(X > 4\), \(X\) è un numero primo e via discorrendo. Qualora dovesse servire, racchiuderò questi eventi tra parentesi graffe (quindi gli esempi precedenti potrebbero anche apparire indicati come \(\{ X = x \}\), \(\{ X > 4 \}\) e \(\{ X \text{ è primo} \}\) ); ciò mi permetterà di essere più preciso quando costruirò degli eventi complessi, ma anche quando vorrò dare enfasi al fatto che queste espressioni rappresentano in tutto e per tutto degli eventi, dei quali può essere interessante calcolare la probabilità.
Sulla condizione di misurabilità
Nel Paragrafo 18.1 abbiamo visto che, quando \(\Omega\) è finito o numerabile, possiamo tranquillamente considerare \(2^\Omega\) come algebra: ogni sottoinsieme è un evento, e di conseguenza ogni funzione \(X \colon \Omega \to \mathbb R\) soddisfa la condizione di misurabilità. In altre parole, qualunque funzione può essere considerata una variabile aleatoria.
Abbiamo anche visto che la situazione cambia quando si considerano variabili aleatorie continue, perché non tutti i sottoinsiemi di \(\Omega\) possono essere eventi, e siamo costretti a considerare una \(\sigma\)-algebra più piccola di \(2^\Omega\). È allora che la condizione in questione diventa interessante, perché non tutte le funzioni \(X \colon \Omega \to \mathbb R\) sono misurabili — è questo il nome che si dà alle funzioni che soddisfano la condizione — ed è per questo motivo che la Definizione 25 lo richiede esplicitamente (riprenderò brevemente questo concetto nel Paragrafo 19.3).
In pratica, esibire una funzione non misurabile richiede costruzioni piuttosto artificiose, che esulano dal livello di questo libro[1]. Per questo, nel seguito considererò la misurabilità come un requisito implicitamente soddisfatto, senza verificarlo di volta in volta.
Esempio 62 (Avanscoperta in due quartieri)
Squirrel Girl coordina due gruppi di scoiattoli che perlustrano in modo indipendente due quartieri distinti, in cerca di potenziali minacce. Ciascun gruppo, al rientro, segnala un numero di minacce compreso tra \(1\) e \(6\). Se assumiamo, per semplicità, che ognuno dei due gruppi segnali ciascuno di questi valori con la stessa probabilità, indipendentemente dall'altro, lo spazio degli esiti è \(\Omega = \{ (g_1, g_2) \mid g_1, g_2 \in [1 .. 6] \}\), e ogni coppia è equiprobabile. La funzione \(X \colon \Omega \to \mathbb R\) tale che \(X((g_1, g_2)) = g_1 - g_2\) per ogni \((g_1, g_2) \in \Omega\) definisce la variabile aleatoria che misura la differenza tra il numero di minacce nei due quartieri. Se \(X\) è positiva, il primo quartiere presenta più minacce del secondo; se è negativa, accade il contrario.
L'evento \(X \geq 2\) raccoglie gli esiti in cui il primo gruppo segnala almeno due minacce in più del secondo. Come evidenziato nella Figura 32, questi esiti sono dieci, e dunque
Analogamente, la probabilità che il primo gruppo indichi al massimo una minaccia in più del secondo sarà \(\mathbb P(X < 2) = 1 - \mathbb P(X \geq 2) = \frac{13}{18}\).
import matplotlib as mpl
import matplotlib.pyplot as plt
import numpy as np

g1, g2 = np.meshgrid(range(1, 7), range(1, 7))
g1, g2 = g1.ravel(), g2.ravel()
PRIMO_PEGGIORE = (g1 - g2) >= 2

with mpl.rc_context({'figure.figsize': (4, 3),
                'figure.dpi': 150,
                'xtick.labelsize': 7,
                'ytick.labelsize': 7,
                'axes.labelsize': 7}):

   EDGE_COLOR = '#010177'

   fig, ax = plt.subplots()
   ax.set_facecolor('#eaf3f5')
   ax.scatter(g1[~PRIMO_PEGGIORE], g2[~PRIMO_PEGGIORE], s=22, c='white',
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=3)
   ax.scatter(g1[PRIMO_PEGGIORE], g2[PRIMO_PEGGIORE], s=22, c='steelblue',
      edgecolors=EDGE_COLOR, linewidths=0.5, zorder=4)
   ax.set_xlabel('Primo gruppo', loc='default')
   ax.set_ylabel('Secondo gruppo', loc='default')
   ax.set_xticks(range(1, 7))
   ax.set_yticks(range(1, 7))
   ax.set_xlim(0.5, 6.5)
   ax.set_ylim(0.5, 6.5)
   ax.grid(True, color=EDGE_COLOR, alpha=0.12)
   ax.set_aspect('equal')
   plt.show()
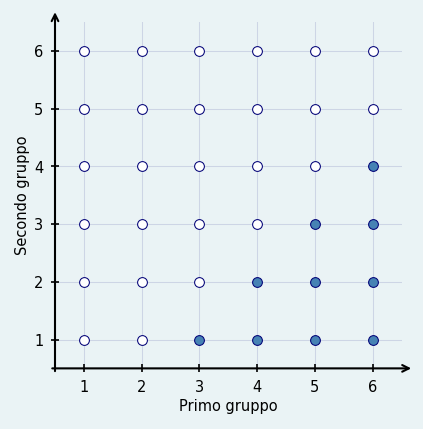
Figura 32 Spazio degli esiti dell'Esempio 62: i punti colorati in blu sono quelli per cui \(X \geq 2\), cioè quelli in cui il primo gruppo segnala almeno due minacce in più del secondo.#
Nell'esempio precedente ci siamo posti due domande — quanto vale \(\mathbb P(X \geq 2)\) e quanto \(\mathbb P(X < 2)\) — che, a ben vedere, erano della stessa natura: chiedevano la probabilità che \(X\) apartenesse a un certo insieme di valori. Non si tratta di una particolarità di quell'esempio: vedremo infatti che gran parte di ciò che vogliamo sapere su una variabile aleatoria si formula proprio in questo modo. Conviene allora considerare in blocco la totalità di queste risposte — una per ogni insieme di valori che potremmo considerare — e dare un nome all'oggetto che ne risulta.
Definizione 26 (Distribuzione di una variabile aleatoria)
La distribuzione (o legge) di una variabile aleatoria \(X\) è la funzione che a ogni insieme misurabile[2] \(A\) di numeri reali associa la probabilità \(\mathbb P_X(A) = \mathbb P(X \in A)\) che \(X\) assuma un valore in \(A\)[3].
Resta però un problema pratico: \(\mathbb P_X\) assegna una probabilità a tutti gli insiemi misurabili, ed è dunque definita su un'intera famiglia di insiemi. Un oggetto di questo tipo è troppo ingombrante per sperare di scriverlo in forma analitica, come faremmo con una funzione di una variabile reale. Conviene allora cercare altri oggetti matematici, più facili da trattare, da cui si possa recuperare per intero l'informazione contenuta in \(\mathbb P_X\). Il prossimo paragrafo ne introduce uno, che ha il vantaggio di funzionare in modo identico per le variabili aleatorie continue e discrete.
19.1.1. La funzione di ripartizione#
La condizione di misurabilità introdotta nella Definizione 25 sembra fornire agli eventi della forma \(X \leq x\) un ruolo particolare. In effetti, il primo strumento matematico che si introduce per lavorare con le variabili aleatorie è esattamente incentrato su questo tipo di evento. Si tratta della funzione di ripartizione introdotta di seguito.
Definizione 27 (Funzione di ripartizione)
Data una variabile aleatoria \(X\), la sua funzione di ripartizione (o funzione di distribuzione cumulativa) è la funzione \(F_X \colon \mathbb R \to [0, 1]\) definita da
La funzione di ripartizione si può quindi pensare come la restrizione della distribuzione di una variabile aleatoria \(X\) agli intervalli della forma \((-\infty, x]\).
Esempio 63 (Il primo gruppo di scoiattoli)
Con riferimento aell'Esempio 62, consideriamo la variabile aleatoria definita da \(Y((g_1, g_2)) = g_1\), che descrive il numero di minacce segnalate dal primo gruppo di scoiattoli. Poiché la funzione può assumere i valori \(1, 2, \dots, 6\) e questi sei valori sono equiprobabili, la funzione di ripartizione di \(Y\) cresce di un sesto ogni volta che la soglia supera uno di tali valori:
Questa forma a tratti è probabilmente la più utile per farsi un'idea dell'andamento della funzione, che è costante a tratti, con dei salti che sono mostrati graficamente nella Figura 33. Se però si vuole una scrittura più compatta ed elegante, si può anche usare l'operatore \(\lfloor \cdot \rfloor\) di parte intera inferiore:
Per esempio, si ha \(F_Y(3) = \mathbb P(Y \leq 3) = \frac{3}{6} = \frac{1}{2}\), perché tre dei sei valori possibili di \(Y\) non superano la soglia \(3\).
from fractions import Fraction
import scipy.stats as st

v = np.arange(1, 7)
p = np.array([1/6] * 6)

X = st.rv_discrete(values=(v, p))
fig, ax = plt.subplots()

x_plot = np.concatenate(([v[0] - 2], v, [v[-1] + 2]))
y_plot = np.concatenate(([0], X.cdf(v), [1]))
ax.step(x_plot, y_plot, where='post', color='C0')

prev = np.concatenate(([0.0], X.cdf(v)[:-1]))
ax.plot(v, X.cdf(v), 'o', color='C0', zorder=3)

ticks = np.arange(1, 7) / 6
labels = [str(Fraction(t).limit_denominator(36)) for t in ticks]
ax.set_yticks(ticks)
ax.set_yticklabels(labels)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_X(x)$')
plt.show()
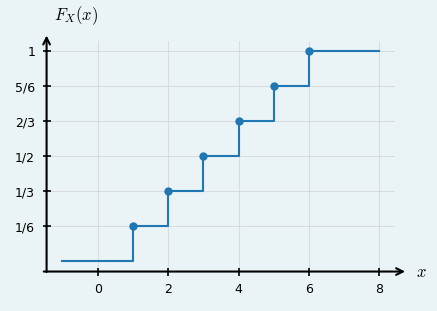
Figura 33 Funzione di ripartizione della variabile \(Y\) definita nell'Esempio 63.#
Esempio 64 (La ripartizione della differenza tra i gruppi)
Sempre con riferimento all'Esempio 62, riconsideriamo la variabile aleatoria \(X\) ivi descritta, che era definita da \(X((g_1, g_2)) = g_1 - g_2\). La sua funzione di ripartizione \(F_X\) associa a ogni \(x\) la probabilità che il primo gruppo segnali al più \(x\) minacce in più del secondo.
In modo non molto dissimile dall'esempio precedente, poiché \(X\) può assumere solo valori interi compresi tra \(-5\) e \(5\), \(F_X\) resta costante tra due interi consecutivi e cambia valore soltanto quando la soglia \(x\) supera uno di questi undici valori. Contando, ogni volta, quante delle \(36\) coppie equiprobabili \((g_1, g_2)\) soddisfano la condizione \(g_1 - g_2 \leq x\), si ottiene la definizione
Anche in questo caso, \(F_X\) è una funzione costante a tratti, come mostrato anche nella Figura 34.
v = np.arange(-5, 6)
p = np.array([1, 2, 3, 4, 5, 6, 5, 4, 3, 2, 1]) / 36

X = st.rv_discrete(values=(v, p))
fig, ax = plt.subplots()

x_plot = np.concatenate(([v[0] - 1], v, [v[-1] + 1]))
y_plot = np.concatenate(([0], X.cdf(v), [1]))
ax.step(x_plot, y_plot, where='post', color='C0')

prev = np.concatenate(([0.0], X.cdf(v)[:-1]))
ax.plot(v, X.cdf(v), 'o', color='C0', zorder=3)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_X(x)$')

ticks = np.arange(4, 37, 4) / 36
labels = [str(Fraction(t).limit_denominator(36)) for t in ticks]
ax.set_yticks(ticks)
ax.set_yticklabels(labels)

plt.show()
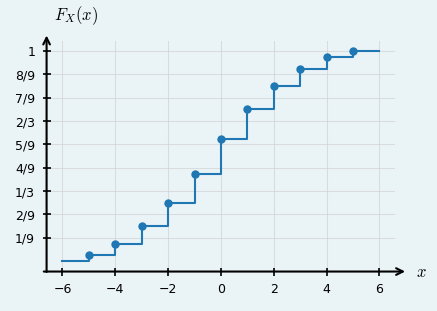
Figura 34 Funzione di ripartizione della variabile \(X\) descritta nell'Esempio 64.#
La funzione di ripartizione codifica per intero il comportamento probabilistico di una variabile aleatoria \(X\), nel senso che a partire da questa funzione si possono calcolare le probabilità di tutti gli eventi che coinvolgono \(X\). Il caso più diretto è quello delle condizioni del tipo \(a < X \leq b\), di cui si occupa il prossimo risultato; ma anche le probabilità dei singoli valori si possono leggere a partire dalla ripartizione, attraverso i suoi salti, come vedremo trattando le variabili discrete.
Lemma 3
Per ogni variabile aleatoria \(X\) e per ogni coppia di numeri reali \(a \leq b\) vale
Dimostrazione.
Poiché \(a \leq b\), l'evento \(\{X \leq b\}\) si decompone come
e i due eventi a secondo membro sono disgiunti, dato che il primo richiede \(X \leq a\) e il secondo \(X > a\). Il terzo assioma di Kolmogorov assicura allora che \(\mathbb P(X \leq b) = \mathbb P(X \leq a) + \mathbb P(a < X \leq b)\), vale a dire
da cui (19.1) segue isolando l'ultimo addendo.
La funzione di ripartizione gode di alcune proprietà generali, valide per qualunque variabile aleatoria, che enuncio nel teorema seguente.
Teorema 18 (Proprietà della funzione di ripartizione)
Siano \(X\) una variabile aleatoria e \(F_X\) la sua funzione di ripartizione. Allora
\(0 \leq F_X(x) \leq 1\) per ogni \(x \in \mathbb R\);
\(F_X\) è non decrescente, cioè \(F_X(a) \leq F_X(b)\) quando \(a \leq b\);
\(\displaystyle \lim_{x \to -\infty} F_X(x) = 0\) e \(\displaystyle \lim_{x \to +\infty} F_X(x) = 1\);
\(F_X\) è continua da destra, cioè \(\displaystyle \lim_{x \to x_0^+} F_X(x) = F_X(x_0)\) per ogni \(x_0\).
Dimostrazione.
La prima proprietà è immediata, perché \(F_X(x) = \mathbb P(X \leq x)\) è una probabilità, e dunque appartiene per definizione all'intervallo \([0, 1]\).
La seconda discende dal Lemma 3: se \(a \leq b\), allora
perché ancora una volta si tratta della probabilità di un evento, e quindi \(F_X(a) \leq F_X(b)\).
Le ultime due proprietà richiedono di passare al limite lungo successioni di eventi, e si dimostrano applicando la continuità della probabilità rispetto a successioni monotone di eventi. Mi limito a darne l'idea: per la terza, basta osservare che gli eventi \(\{X \leq x\}\) si riducono all'insieme vuoto quando \(x \to -\infty\) e crescono fino a riempire tutto \(\Omega\) quando \(x \to +\infty\), sicché le loro probabilità tendono rispettivamente a \(0\) e a \(1\). Per la quarta, gli eventi \(\{X \leq x\}\) con \(x \to x_0^+\) decrescono fino all'evento \(\{X \leq x_0\}\), e la continuità della probabilità garantisce che \(F_X(x)\) tenda a \(F_X(x_0)\). Ometto i dettagli tecnici, che riprenderò quando tratterò le successioni di eventi.
Teorema 19 (Caratterizzazione delle funzioni di ripartizione)
Una funzione \(F \colon \mathbb R \to [0, 1]\) è la funzione di ripartizione di una qualche variabile aleatoria se e solo se è non decrescente, continua da destra, e soddisfa
Una metà di questo enunciato ci è già nota: per il Teorema 18, ogni funzione di ripartizione è non decrescente, continua da destra e possiede i due limiti prescritti, sicché la necessità di queste tre condizioni è acquisita. Il contenuto sostanziale del teorema è il viceversa, ovvero la loro sufficienza: ogni funzione \(F\) che le soddisfi è effettivamente la funzione di ripartizione di una variabile aleatoria, nel senso che se ne può sempre costruire una che ammette proprio \(F\) come legge. Questa direzione richiede però di esibire una tale variabile a partire da \(F\), e presuppone strumenti che non ho ancora introdotto: per questo la enuncio senza dimostrazione. Ne ricaviamo comunque un criterio pratico, che useremo di frequente: per riconoscere se una data funzione può descrivere la legge di una variabile aleatoria è sufficiente verificarne la monotonicità, la continuità da destra e i limiti agli estremi.
Esempio 65 (L'altezza dell'ultimo supereroe)
Torniamo all'esperimento, già incontrato in precedenza, di misurare l'altezza dell'ultimo supereroe che compare in un fumetto. Consideriamo la funzione
e chiediamoci se possa essere la funzione di ripartizione di una variabile aleatoria \(H\) che rappresenta tale altezza, espressa in centimetri.
Il grafico nella Figura 35 mostra che \(F_H\) è non decrescente; inoltre il tratto obliquo che collega \((150, 0)\) a \((210, 1)\) evidenzia che la funzione è continua, quindi in particolare continua da destra. Si vede anche che \(F_H(x)\) tende a \(0\) quando \(x \to -\infty\) e a \(1\) quando \(x \to +\infty\). Per il Teorema 19, queste proprietà bastano a concludere che \(F_H\) è effettivamente la funzione di ripartizione di una qualche variabile aleatoria.
Per esempio,
perché \(180\) si trova esattamente a metà dell'intervallo in cui la funzione cresce da \(0\) a \(1\).
fig, ax = plt.subplots()

x_plot = np.array([140, 150, 210, 220])
y_plot = st.uniform(150, 60).cdf(x_plot)
ax.plot(x_plot, y_plot)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_H$')
ax.set_xticks([150, 180, 210])
ax.set_yticks([0, 1 / 2, 1])
ax.set_yticklabels(['0', '1/2', '1'])
plt.show()
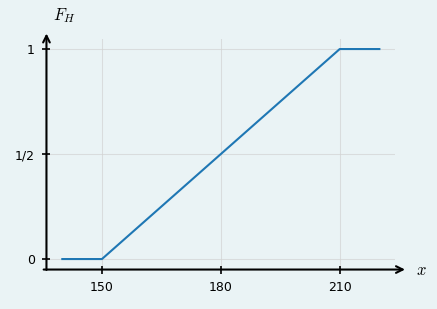
Figura 35 Grafico della funzione \(F_H\) dell'Esempio 65: la funzione è non decrescente, continua e ha i limiti corretti agli estremi, quindi soddisfa le condizioni del Teorema 19.#
La funzione di ripartizione visualizzata in Figura 35 esibisce un comportamento che la distingue rispetto a quelle viste precedentemente: a differenza di queste ultime, che sono costanti a tratti (crescono «per salti»), varia in modo continuo. Questa caratteristica non è un semplice dettaglio grafico, ma riflette la natura della variabile aleatoria e della distribuzione sottostanti, nel senso che ho anticiato all'inizio di questo capitolo. Più precisamente, quando la funzione di ripartizione è costante a tratti la variabile aleatoria è discreta, e quando è continua allora la variabile aleatoria è continua. Vedremo più avanti che esistono anche situazioni intermedie, nelle quali convivono entrambe le caratteristiche.
Conviene quindi fissare un punto che ci farà da filo conduttore: la funzione di ripartizione è un particolare descrittore di una variabile aleatoria, o, equivalentemente, della sua distribuzione, che non dipende dal suo tipo. Le proprietà che abbiamo appena visto, e la caratterizzazione che ne discende, valgono per le variabili discrete, continue e miste. Nei prossimi capitoli approfondirò questa distinzione, a partire dal caso discreto.
19.1.2. Variabili aleatorie in Python#
Il modulo scipy.stats fornisce due classi base per rappresentare variabili
aleatorie: rv_discrete per distribuzioni discrete e rv_continuous per
quelle continue. Una volta costruiti gli oggetti corrispondenti, la funzione di
ripartizione — così come altri oggetti matematici legati alla
distribuzione — è disponibile invocando il metodo cdf, senza che vi sia
bisogno di implementarla a mano.
Per costruire l'oggetto che corrisponde a una distribuzione discreta, è sufficiente passare l'insieme dei valori e le probabilità corrispondenti:
import numpy as np
import scipy.stats as st

v = np.arange(1, 7)
p = np.array([1/6] * 6)

X = st.rv_discrete(values=(v, p))
Come sopra indicato, su X è possibile invocare il metodo cdf per ottenere
i valori della funzione di ripartizione. È importante sottolineare che cdf è
una funzione vettoriale, che accetta come argomenti liste, vettori o altri
oggetti ad accesso posizionale[4] e restituisce un array NumPy
della stessa forma, applicando in modo efficiente il calcolo elemento per
elemento, senza cicli Python espliciti. Ciò comporta che invocare cdf su un
vettore di, diciamo \(n\) elementi, è tendenzialmente più veloce che invocarlo
per \(n\) volte sui singoli elementi.
X.cdf([-4, 1, 1.1, 5, 7])
array([0. , 0.16666667, 0.16666667, 0.83333333, 1. ])
Uno dei modi più agevoli per disegnare il grafico delle funzioni di
ripartizione di variabili aleatorie discrete è quello di usare ax.step, che
è appunto pensato per le funzioni costanti a tratti. I pallini che evidenziano
la continuità da destra si aggiungono separatamente usando ax.plot.
import matplotlib.pyplot as plt

fig, ax = plt.subplots()

x_plot = np.concatenate(([v[0] - 2], v, [v[-1] + 2]))
y_plot = np.concatenate(([0], X.cdf(v), [1]))
ax.step(x_plot, y_plot, where='post', color='C0')

prev = np.concatenate(([0.0], X.cdf(v)[:-1]))
ax.plot(v, X.cdf(v), 'o', color='C0', zorder=3)

ticks = np.arange(1, 7) / 6
labels = [str(Fraction(t).limit_denominator(36)) for t in ticks]
ax.set_yticks(ticks)
ax.set_yticklabels(labels)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_X(x)$')
plt.show()
Nell'invocazione di ax.step è importante specificare l'argomento opzionale
where="post", per riprodurre correttamente la continuità da destra: in questo
modo, ogni segmento orizzontale parte dal valore a destra del salto, in accordo
con la definizione \(F(x) = P(X \leq x)\).
In generale, userò rv_discrete solo per distribuzioni molto specifiche, che
individuano variabili aleatorie con pochi valori, così che la loro
distribuzione si possa descrivere in modo estensivo, specificando ogni valore
insieme alla relativa probabilità. All'atto pratico, vedremo nel
Capitolo 20 che si utilizzano dei particolari modelli di
distribuzione, per ognuno dei quali si utilizzano delle classi Python dedicate,
derivate da rv_discrete. Il caso delle distribuzioni continue è meno agevole
da trattare: sebbene scipy.stats metta a disposizione la classe
rv_continuous, le variabili aleatorie corrispondenti hanno infiniti valori
possibili, dunque non ha senso pensare di istanziare questa classe in modo
analogo all'esempio appena visto. Infatti, rv_continuous è normalmente usata
come base per derivare modelli di variabili aleatorie, tra cui quelli che
vedremo nel Capitolo 21[5]. Per creare delle
variabili aleatorie che non sono annoverate in questi modelli è necessaria una
conoscenza sulla creazione di classi in Python, che in questo libro non
approfondirò.
19.1.3. Vero o falso?#
Analizzate ciascuna delle seguenti affermazioni, che riguardano una variabile aleatoria \(X\), e dite se è vera o falsa, motivando il vostro ragionamento. Cliccate su di essa per visualizzare la risposta corretta.
La funzione di ripartizione \(F_X\) è non decrescente.
Vera. Per il Teorema 18, se \(x \leq y\) allora \(\{X \leq x\} \subseteq \{X \leq y\}\), quindi \(F_X(x) = \mathbb P(X \leq x) \leq \mathbb P(X \leq y) = F_X(y)\).
Per qualunque variabile aleatoria \(X\) vale \(\lim_{x \to +\infty} F_X(x) = 1\).
Vera. Al crescere di \(x\) verso \(+\infty\), l'evento \(\{X \leq x\}\) «esaurisce» l'intero spazio degli esiti, quindi la sua probabilità tende a \(\mathbb P(\Omega) = 1\).
La funzione di ripartizione è continua da sinistra in ogni punto.
Falsa. Per il Teorema 18, \(F_X\) è continua da destra in ogni punto, ma non necessariamente da sinistra: nelle variabili aleatorie discrete \(F_X\) presenta salti nei valori del supporto, e in corrispondenza di un salto il limite sinistro è strettamente minore del valore della funzione.
Se \(a < b\) e \(F_X(a) = F_X(b)\), allora \(X\) non può mai assumere valori nell'intervallo \((a, b]\).
Vera. Per il Lemma 3, \(\mathbb P(a < X \leq b) = F_X(b) - F_X(a) = 0\), il che significa che la probabilità che \(X\) cada nell'intervallo \((a, b]\) è nulla.
Due variabili aleatorie con la stessa funzione di ripartizione coincidono come funzioni da \(\Omega\) a \(\mathbb R\).
Falsa. Consideriamo lo spazio degli esiti \(\Omega= \{ \omega_1, \omega_2 \}\), e su di esso definiamo \(\mathbb P(\{ \omega_1 \}) = \mathbb P(\{ \omega_2 \})=\frac{1}{2}\). Le due variabili aleatorie \(X\) e \(Y\) definite da \(X(\omega_1) = 0\), \(X(\omega_2) = 1\), \(Y(\omega_1) = 1\) e \(Y(\omega_2) = 0\) non coincidono come funzioni su \(\Omega\), poiché ad esempio \(X(\omega_1) \neq Y(\omega_1)\). Tuttavia, \(\mathbb P(X=0) = \mathbb P(X=1) = \frac{1}{2}\) e \(\mathbb P(Y=0) = \mathbb P(Y=1) = \frac{1}{2}\). Di conseguenza le due funzioni di ripartizione coincidono:
Quindi due variabili aleatorie possono avere la stessa funzione di ripartizione pur essendo diverse come funzioni da \(\Omega\) a \(\mathbb R\).
La funzione di ripartizione caratterizza completamente la distribuzione di \(X\).
Vera. Per il Teorema 19, la funzione di ripartizione \(F_X\) determina univocamente la distribuzione di \(X\): due variabili aleatorie con la stessa \(F_X\) hanno la stessa distribuzione di probabilità.
19.1.4. Esercizi#
Esercizio 137 (•)
Durante alcuni esperimenti sulle anomalie temporali, Moon Girl utilizza un dispositivo che deve classificare tre segnali come provenienti o meno da una distorsione temporale. Per semplificare il modello, assumiamo che per ciascun segnale il dispositivo abbia la stessa probabilità di fornire una classificazione corretta (\(C\)) o errata (\(E\)), e che le classificazioni siano indipendenti tra loro. Sia \(X\) la variabile aleatoria che conta il numero di classificazioni corrette.
Descrivete lo spazio degli esiti \(\Omega\) dell'esperimento aleatorio collegato.
Per ciascun valore \(x\) che \(X\) può assumere, elencate gli esiti che compongono l'evento \(\{X = x\}\) e calcolate \(\mathbb P(X = x)\).
Calcolate \(\mathbb P(X \geq 2)\) e \(\mathbb P(X \leq 1)\), e verificate che le due probabilità siano coerenti tra loro.
Calcolate la probabilità dell'evento «il numero di classificazioni corrette è pari», cioè \(\mathbb P(X \in \{0, 2\})\).
Solution to Esercizio 137 (•)
Lo spazio degli esiti è \(\Omega = \{ C, E \}^3\), cioè l'insieme delle terne ordinate di classificazioni: contiene \(2^3 = 8\) esiti, ognuno dei quali ha probabilità \(\tfrac{1}{8}\).
La variabile \(X\) può assumere tutti i valori interi da \(0\) (nessuna delle classificazioni è corretta) a \(3\) (tutte le classificazioni sono corrette), e
\[\begin{aligned} \{ X = 0 \} &= \{ (E,E,E) \}, & \mathbb P(X = 0) &= \tfrac{1}{8}, \\ \{ X = 1 \} &= \{ (C, E, E), (E, C, E), (E, E, C) \}, & \mathbb P(X = 1) &= \tfrac{3}{8}, \\ \{ X = 2 \} &= \{ (C, C, E), (C, E, C), (E, C, C) \}, & \mathbb P(X = 2) &= \tfrac{3}{8}, \\ \{ X = 3 \} &= \{ (C, C, C) \}, & \mathbb P(X = 3) &= \tfrac{1}{8}. \end{aligned}\]Si verifica immediatamente che la somma di queste probabilità è \(1\).
L'evento \(\{ X \geq 2 \}\) si può esprimere come \(\{ X = 2 \} \cup \{ X = 3 \}\), e questi due ultimi eventi sono disgiunti, pertanto per il terzo assioma di Kolmogorov \(\mathbb P(X \geq 2) = \mathbb P(X = 2) + \mathbb P(X = 3) = \tfrac{3}{8} + \tfrac{1}{8} = \tfrac{1}{2}\). Analogamente, \(\mathbb P(X \leq 1) = \mathbb P(X = 0) + \mathbb P(X = 1) = \tfrac{1}{8} + \tfrac{3}{8} = \tfrac{1}{2}\). Le due probabilità ottenute sommano a \(1\), riflettendo il fatto che \(\{ X \geq 2 \}\) e \(\{ X \leq 1 \}\) sono complementari l'uno dell'altro.
\(\mathbb P(X \in \{ 0, 2 \}) = \mathbb P(X = 0) + \mathbb P(X = 2) = \tfrac{1}{8} + \tfrac{3}{8} = \tfrac{1}{2}\).
Esercizio 138 (••)
Come cambierebbero le risposte all'esercizio precedente se le classificazioni corretta ed errata avessero, rispettivamene, probabilità \(\tfrac{3}{4}\) e \(\tfrac{1}{4}\)?
Solution to Esercizio 138 (••)
Sebbene gli esiti non siano più equiprobabili, \(\Omega\) resta invariato.
Anche i valori che \(X\) può assumere non cambiano, però sono diverse le relative probabilità:
\[\begin{aligned} \{ X = 0 \} &= \{ (E,E,E) \}, & \mathbb P(X = 0) &= \tfrac{1}{64}, \\ \{ X = 1 \} &= \{ (C, E, E), (E, C, E), (E, E, C) \}, & \mathbb P(X = 1) &= \tfrac{9}{64}, \\ \{ X = 2 \} &= \{ (C, C, E), (C, E, C), (E, C, C) \}, & \mathbb P(X = 2) &= \tfrac{27}{64}, \\ \{ X = 3 \} &= \{ (C, C, C) \}, & \mathbb P(X = 3) &= \tfrac{27}{64}. \end{aligned}\]In questo caso, \(\mathbb P(X \geq 2) = \tfrac{27}{32}\) e \(\mathbb P(X \leq 1) = \tfrac{5}{32}\).
\(\mathbb P(X \in \{ 0, 2 \}) = \tfrac{1}{64} + \tfrac{27}{64} = \tfrac{7}{16}\).
Esercizio 139 (••)
Quando si attiva, lo scarabeo di Blue Beetle seleziona una fra quattro configurazioni di diversa potenza, dove quest'ultima è descritta da una variabile aleatoria \(X\) che assume i valori interi da \(1\) a \(4\). Queste configurazioni non sono equiprobabili: lo scarabeo predilige quelle intermedie, e in particolare
Verificate che questi quattro valori definiscano effettivamente una distribuzione, e scrivete la forma analitica della funzione di ripartizione \(F_X\).
Disegnate l'andamento del grafico di \(F_X\) e indicate dove la funzione è costante, dove siano localizzate le sue discontinuità e quale siano le ampiezze dei salti corrispondenti.
Indicate come analizzare il grafico del punto precedente per ottenere la probabilità \(\mathbb P(X = 3)\).
Solution to Esercizio 139 (••)
Le quattro probabilità sono non negative e la loro somma è \(1\), e ogni evento che riguarda \(X\) si può facilmente riscrivere in termini dell'unione di eventi della forma \(\{ X = i \}\), con \(i \in [1 .. 4]\). Quindi i quattro valori individuano la distribuzione \(\mathbb P_X\). La funzione di ripartizione della variabile aleatoria è
\[F_X(x) = \begin{cases} 0 & \text{se } x < 1, \\ \tfrac18 & \text{se } 1 \leq x < 2, \\ \tfrac38 & \text{se } 2 \leq x < 3, \\ \tfrac78 & \text{se } 3 \leq x < 4, \\ 1 & \text{se } x \geq 4. \end{cases}\]La funzione di ripartizione ha il tipico grafico delle distribuzioni discrete, costante a tratti. Come si vede nel grafico generato dalla cella che segue, sono presenti quattro salti, in corrispondenza dei valori di \(X\): uno di ampiezza \(\tfrac{1}{8}\) in \(x = 1\), un secondo ampio \(\tfrac{1}{4}\) in \(x = 2\) e altri due in \(x = 3\) e \(x = 4\), i cui salti sono rispettivamente grandi \(\tfrac{1}{2}\) (è il salto più pronunciato) e \(\tfrac{1}{8}\).
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as st

v = np.arange(1, 5)
p = np.array([1/8, 1/4, 1/2, 1/8])

X = st.rv_discrete(values=(v, p))

fig, ax = plt.subplots()

x_plot = np.concatenate(([v[0] - 1], v, [v[-1] + 1]))
y_plot = np.concatenate(([0], X.cdf(v), [1]))
ax.step(x_plot, y_plot, where='post', color='C0')

prev = np.concatenate(([0.0], X.cdf(v)[:-1]))
ax.plot(v, X.cdf(v), 'o', color='C0', zorder=3)

ticks = np.array([1, 3, 7, 8]) / 8
labels = [str(Fraction(t)) for t in ticks]
ax.set_yticks(ticks)
ax.set_yticklabels(labels)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_X(x)$')
plt.show()
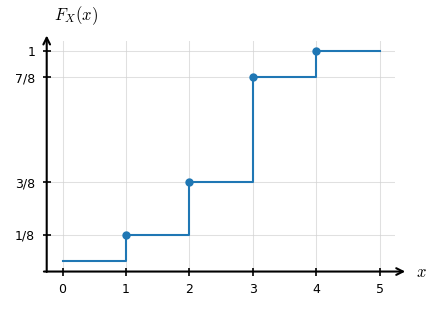
Si ritrova la probabilità \(\mathbb P(X = 3)\) considerando l'ampiezza del salto in \(x = 3\). Nel punto precedente abbiamo visto che tale ampiezza è uguale a \(\tfrac{1}{2}\). Da un punto di vista operativo, la si può determinare calcolando la differenza tra i valori della funzione di ripartizione in \(3\) e in uno dei valori prossimi a sinistra; più precisamente,
\[\mathbb P(X = 3) = F_X(3) - \lim_{x \to 3^-} F_X(x) = F_X(3) - F_X(2) = \tfrac{7}{8} - \tfrac{3}{8} = \tfrac{1}{2} \enspace,\]che coincide con la probabilità assegnata in partenza.
Esercizio 140 (••)
Ogni volta che entra in azione, The Tick urla ogni volta il suo grido di battaglia («SPOON!») un numero diverso di volte. Indichiamo con \(X\) la variabile aleatoria che indica il numero di grida lanciate, e assumiamo
Scrivete la funzione di ripartizione \(F_X\), visualizzatene il graifco e poi utilizzate il Lemma 3 per calcolare le seguenti probabilità:
\(\mathbb P(0 < X \leq 2)\),
\(\mathbb P(0 \leq X \leq 2)\),
\(\mathbb P(0 < X < 2)\),
\(\mathbb P(X = 2)\).
Confrontate i primi tre risultati e spiegate perché differiscono, pur riferendosi a intervalli con gli stessi estremi.
Solution to Esercizio 140 (••)
La funzione di ripartizione è
e il suo grafico si può tracciare nel modo seguente.
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as st

v = np.arange(0, 4)
p = np.array([1/2, 1/4, 1/8, 1/8])

X = st.rv_discrete(values=(v, p))

fig, ax = plt.subplots()

x_plot = np.concatenate(([v[0] - 1], v, [v[-1] + 1]))
y_plot = np.concatenate(([0], X.cdf(v), [1]))
ax.step(x_plot, y_plot, where='post', color='C0')

prev = np.concatenate(([0.0], X.cdf(v)[:-1]))
ax.plot(v, X.cdf(v), 'o', color='C0', zorder=3)

ticks = np.arange(1, 5) / 4
labels = [str(Fraction(t)) for t in ticks]
ax.set_yticks(ticks)
ax.set_yticklabels(labels)

ax.set_xlabel(r'$x$')
ax.set_ylabel(r'$F_X(x)$')
plt.show()
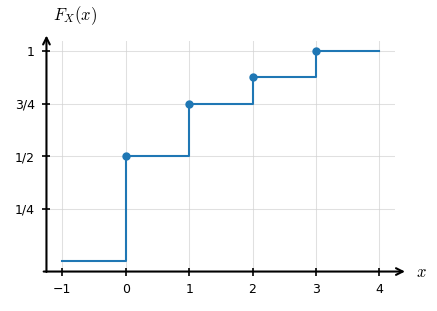
Il Lemma 3 si applica direttamente:
\[\mathbb P(0 < X \leq 2) = F_X(2) - F_X(0) = \tfrac{7}{8} - \tfrac{1}{2} = \tfrac{3}{8} \enspace.\]Rispetto al caso precedente bisogna includere anche il caso \(X = 0\), che prima veniva escluso. Un modo per farlo è quello di diminuire l'estremo sinistro dell'insieme, aggiungendo il primo valore da escludere:
\[\mathbb P(0 \leq X \leq 2) = \mathbb P(-1 < X \leq 2) = F_X(2) - F_X(-1) = F_X(2) = \tfrac{7}{8} \enspace.\]In alternativa, la stessa probabilità si può calcolare come \(\mathbb P(X = 0) + \mathbb P(0 < X \leq 2) = \mathbb P(X = 0) + F_X(2) - F_X(0) = \tfrac{1}{2} \times \tfrac{3}{8} = \tfrac{7}{8}\).
In questo caso, possiamo procedere come nel punto precedente, escludendo il caso \(X = 2\):
\[\mathbb P(0 < X < 2) = \mathbb P(0 < X \leq 1) = F_X(1) - F_X(0) = \tfrac{3}{4} - \tfrac{1}{2} = \tfrac14 \enspace.\]L'evento \(\{ X = 2 \}\) coincide con \(\{ 1 < X \leq 2 \}\), pertanto:
\[\mathbb P(X = 2) = F_X(2) - F_X(1) = \tfrac{7}{8} - \tfrac{3}{4} = \tfrac{1}{8} \enspace.\]
Gli insiemi considerati nei primi tre punti hanno gli stessi estremi \(0\) e \(2\), ma differiscono per il fatto di includerli o meno. Poiché \(X\) assume i valori \(0\) e \(2\) con probabilità non nulla, includerli o escluderli cambia il risultato che si ottiene quando si calcola la probabilità.
Esercizio 141 (••••)
Brainiac 5, fra le menti più acute della Legione dei Super-Eroi, sottopone le seguenti funzioni \(F \colon \mathbb R \to [0, 1]\) al vaglio del Teorema 19. Per ciascuna di esse, stabilite se si tratta della funzione di ripartizione di una qualche variabile aleatoria; in caso negativo, indicate quali delle condizioni del teorema non risultano soddisfatte.
In tutti i casi nei quali la funzione rispetta le condizioni del teorema, specificate se la distribuzione corrispondente è continua o discreta.
Solution to Esercizio 141 (••••)
\(F_1\) è una funzione di ripartizione: è non decrescente, continua da destra (in quanto continua tout court) e tende ai limiti \(0\) e \(1\) quando il suo argomento tende rispettivamente a meno e più infinito.
\(F_2\) non è una funzione di ripartizione, perché non è non decrescente: per la precisione, è non decrescente fino a \(x = 1\), da lì fino a \(x = 2\) diviene non crescente \(\tfrac{3}{4} = F(0) > F(1) = \tfrac{1}{2}\). Soddisfa invece tutte le altre proprietà indicate nella tesi del teorema.
\(F_3\) non è una funzione di ripartizione: è non decrescente e continua da destra, inoltre \(\lim_{x \to +\infty} F_3(x) = 0\). Ma \(\lim_{x \to +\infty} F_3(x) = \tfrac{2}{3} \neq 1\).
Anche \(F_4\) non è una funzione di ripartizione: rispetta tutti i requisiti richiesti, a parte la continuità da destra: \(F_4(1) = 0\), mentre \(\lim_{x \to 1^+} F_4(x) = 1 \neq 0\).
\(F_5\) è una funzione di ripartizione: l'arcotangente è strettamente crescente e continua, dunque \(F_5\) è non decrescente e continua da destra; inoltre \(\lim_{x \to \pm\infty} \arctan x = \pm\tfrac{\pi}{2}\), pertanto, quando \(x\) tende a più e meno infinito, \(F_5(x)\) tende a \(0\) e \(1\), rispettivamente.
\(F_6\) è una funzione di ripartizione, perché è definita in modo simile a \(F_4\), garantendo però la continuità da destra: l'unico punto di discontinuità è \(x = 1\), e $\lim_{x \to 1^+} F_6(x) = 1 = F_6(x).
Infine, \(F_7\) è una funzione di ripartizione: per costruzione i suoi limiti agli estremi sono \(0\) e \(1\) e la continuità a destra è assicurata, inoltre la funzione è non decrescente.
Tra tutti i casi che individuano delle funzioni di ripartizione, \(F_1\) ed \(F_5\) individuano una distribuzione continua, perché sono continue (e non solamente continue da destra). Invece, \(F_6\) ed \(F_7\) descrivono delle variabili aleatorie discrete, essendo costanti a tratti.
Esercizio 142 (••)
Dopo un intervento sul campo, Atomic Robo entra in modalità di raffreddamento per un tempo pari a \(T\) minuti, dove \(T\) è una variabile aleatoria la cui funzione di ripartizione è
Verificate che \(F_T\) soddisfi le condizioni del Teorema 19.
Calcolate \(\mathbb P(T \leq 1)\) e \(\mathbb P(1 < T \leq \tfrac32)\).
Trovate il valore mediano di \(T\), inteso come il numero \(m \in \mathbb R\) per cui \(F_T(m) = \tfrac{1}{2}\).
Solution to Esercizio 142 (••)
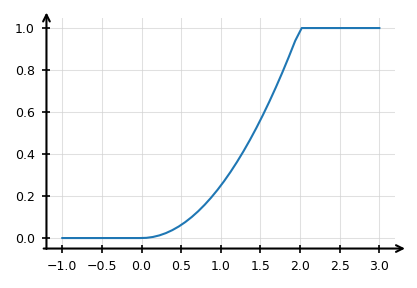
Sull'intervallo \([0, 2)\) la funzione \(t \mapsto t^2/4\) è crescente, e si raccorda con continuità ai tratti costanti:
\[ F_T(0) = 0 = \lim_{t \to 0} F_T(t), \quad F_T(2) = 1 = \lim_{t \to 2} F_T(t) \enspace,\]il che mostra che \(F_T\) è continua, e a maggior ragione continua da destra. Per costruzione, i suoi limiti a più e meno infinito sono rispettivamente \(0\) e \(1\). Nel tratto non costante si ha \(F'_T(t) = t / 2\), e la derivata è sempre non negativa per \(t \in [0, 2)\), quindi \(F_T\) è anche non decrescente, come si vede nel grafico seguente. Le tre condizioni del teorema sono pertanto soddisfatte.
def F_T(t):
   return np.clip(t, 0, 2)**2 / 4

fig, ax = plt.subplots()
t = np.linspace(-1, 3, 50)
plt.plot(t, F_T(t))
plt.show()
La prima probabilità si ottiene direttamente utilizzando la definizione di funzione di ripartizione:
\[\mathbb P(T \leq 1) = F_T(1) = \tfrac14 \enspace,\]mentre la seconda si ottiene applicando il Lemma 3:
\[\mathbb P \left(1 < T \leq \tfrac{3}{2}\right) = F_T \left(\tfrac{3}{2}\right) - F_T(1) = \frac{(3/2)^2}{4} - \frac14 = \frac{9}{16} - \frac{4}{16} = \frac{5}{16} \enspace.\]Imponendo \(F_T(m) = \tfrac12\) si ha \(m^2/4 = \tfrac12\), cioè \(m^2 = 2\) e dunque \(m = \sqrt 2 \approx 1{,}41\) minuti.
Esercizio 143 (•••)
Bouncing Boy e Matter-Eater Lad si allenano per partecipare a un gioco a squadre: ciascuno lancia, in modo indipendente dall'altro, un dado bilanciato a quattro facce. Il più alto dei due valori ottenuti diventa il punteggio della squadra, che sarà quindi descritto dalla variabile aleatoria \(X = \max(B, M)\), dove \(B\) ed \(M\) sono a loro volta variabili aleatorie che indicano i punteggi di Bouncing Boy e di Matter-Eater.
Descrivete lo spazio degli esiti e dite quante coppie equiprobabili lo compongono.
Osservando che \(\{X \leq k\}\) equivale a «entrambi i punteggi non superano \(k\)», calcolate \(\mathbb P(X \leq k)\) per \(k = 1, 2, 3, 4\) e deducete tutti i possibili valori di \(\mathbb P(X = k)\).
Scrivete la forma analitica della funzione di ripartizione \(F_X\).
Calcolate \(\mathbb P(X \geq 3)\).
Solution to Esercizio 143 (•••)
Lo spazio degli esiti è \(\Omega = \{(a, b) \mid a, b \in [1 .. 4]\}\), che contiene \(16\) coppie equiprobabili.
Per ogni \(k \in \{1, 2, 3, 4\}\), poniamo \(B_k = \{B \leq k\}\) ed \(M_k = \{M \leq k\}\). L'evento \(\{X \leq k\}\) coincide allora con \(B_k \cap M_k\), perché il massimo tra \(B\) ed \(M\) non supera \(k\) se e solo se entrambi i punteggi non superano \(k\). Siccome i due lanci sono indipendenti, anche gli eventi \(B_k\) ed \(M_k\) sono indipendenti; inoltre \(\mathbb P(B_k) = \mathbb P(M_k) = \tfrac{k}{4}\). Quindi
\[\mathbb P(X \leq k) = \mathbb P(B_k \cap M_k) = \mathbb P(B_k) \cdot \mathbb P(M_k) = \left(\tfrac{k}{4}\right)^2 \enspace.\]Dunque
\[\mathbb P(X \leq 1) = \tfrac{1}{16}, \quad \mathbb P(X \leq 2) = \tfrac{2}{8}, \quad \mathbb P(X \leq 3) = \tfrac{9}{16}, \quad \mathbb P(X \leq 4) = 1 \enspace.\]Le probabilità dei singoli valori si ottengono come differenze consecutive (ossia come salti):
\[\mathbb P(X = 1) = \tfrac{1}{16}, \quad \mathbb P(X = 2) = \tfrac{3}{16}, \quad \mathbb P(X = 3) = \tfrac{5}{16}, \quad \mathbb P(X = 4) = \tfrac{7}{16} \enspace.\]I valori della funzione di ripartizione sono già stati calcolati al punto precedente:
\[F_X(x) = \begin{cases} 0 & \text{se } x < 1, \\ \tfrac{1}{16} & \text{se } 1 \leq x < 2, \\ \tfrac{4}{16} & \text{se } 2 \leq x < 3, \\ \tfrac{9}{16} & \text{se } 3 \leq x < 4, \\ 1 & \text{se } x \geq 4. \end{cases}\]Possiamo calcolare la probabilità nei seguenti due modi:
utilizzando la funzione di ripartizione: \(\mathbb P(X \geq 3) = 1 - \mathbb P(X \leq 2) = 1 - \tfrac{4}{16} = \tfrac{3}{4}\);
facendo riferimento alle probabilità che \(X\) assuma i valori che comportano che l'evento si verifichi: \(\mathbb P(X \geq 3) = \mathbb P(X = 3) + \mathbb P(X = 4) = \tfrac{5}{16} + \tfrac{7}{16} = \tfrac{3}{4}\).
Esercizio 144 (•)
Considerate la variabile aleatoria \(X = g_1 - g_2\) dell'Esempio 62, la cui funzione di ripartizione \(F_X\) è stata ricavata nell'Esempio 64. Usando solamente \(F_X\) (e non nuovi conteggi sugli elementi dello spazio degli esiti), calcolate:
\(\mathbb P(-1 < X \leq 2)\);
\(\mathbb P(X = 0)\), ottenuta come salto di \(F_X\) in \(0\), verificando il risultato contando direttamente gli esiti per cui \(g_1 = g_2\);
\(\mathbb P(X > 3)\).
Solution to Esercizio 144 (•)
Richiamando i valori di \(F_X\) dall'Esempio 64:
Per il Lemma 3,
\[\mathbb P(-1 < X \leq 2) = F_X(2) - F_X(-1) = \tfrac{5}{6} - \tfrac{5}{12} = \tfrac{5}{12} \enspace.\]Il salto di \(F_X\) in \(0\) vale
\[\mathbb P(X = 0) = F_X(0) - \lim_{x \to 0^-} F_X(x) = \tfrac{7}{12} - \tfrac{5}{12} = \tfrac{1}{6} \enspace.\]La verifica diretta è immediata: gli esiti per cui \(g_1 = g_2\) sono i sei elementi dell'insieme \(\{ (i, i) \mid i = 1, \dots, 6 \}\), dunque \(\mathbb P(X = 0) = \tfrac{6}{36} = \tfrac{1}{6}\).
\(\mathbb P(X > 3) = 1 - \mathbb P(X \leq 3) = 1 - F_X(3) = 1 - \tfrac{11}{12} = \tfrac{1}{12}\).
Esercizio 145 (•••)
Fissato uno spazio degli esiti \(\Omega\), siano date una generica variabile aleatoria \(X\) e la la sua funzione di ripartizione \(F_X\). Stabilite se ciascuna delle seguenti affermazioni è vera o falsa, motivando brevemente la risposta.
Qualunque funzione \(X \colon \Omega \to \mathbb R\) è una variabile aleatoria.
Se \(F_X(3) = F_X(5)\), allora \(\mathbb P(3 < X \leq 5) = 0\).
Per ogni \(a \in \mathbb R\) vale \(\mathbb P(X = a) = F_X(a) - \lim_{x \to a^-} F_X(x)\).
Se \(F_X\) è continua nel punto \(a\), allora \(\mathbb P(X = a) = 0\).
Se \(F_X\) è continua da sinistra in ogni punto, allora è continua ovunque.
Solution to Esercizio 145 (•••)
Falsa. Quando \(\Omega\) è finito o numerabile e si lavora in \(2^\Omega\) ogni funzione soddisfa la condizione di misurabilità ed è quindi una variabile aleatoria; ma se la \(\sigma\)-algebra è più piccola di \(2^\Omega\) — come accade necessariamente nel caso continuo — esistono funzioni non misurabili, che la Definizione 25 esclude.
Vera. Per il Lemma 3, \(\mathbb P(3 < X \leq 5) = F_X(5) - F_X(3) = 0\).
Vera. Si ha \(\mathbb P(X = a) = \mathbb P(X \leq a) - \mathbb P(X < a) = F_X(a) - \lim_{x \to a^-} F_X(x)\): la probabilità del singolo valore è l'ampiezza del salto di \(F_X\) in \(a\).
Vera. È il caso particolare del punto precedente in cui il limite da sinistra coincide con \(F_X(a)\): il salto è nullo, quindi \(\mathbb P(X = a) = 0\).
Vera. Per il Teorema 18, \(F_X\) è sempre continua da destra; se è anche continua da sinistra in ogni punto, allora i due limiti laterali coincidono con il valore della funzione ovunque, ed è dunque continua.
19.1.5. Concetti fondamentali#
Pensate ai concetti fondamentali illustrati in questo paragrafo ed elencateli. Nella lista qui sotto sono già presenti gli stessi concetti, ma nascosti. Cliccate sul pulsante per mostrarli sotto forma di parole chiave, quindi confrontateli con la vostra lista. Provate infine a descrivere ciascun concetto con parole vostre.