
 Italiano
 English
 Français
 Español
4.9. Leggere dati da file#
Di solito la quantità di dati da analizzare è tale che non è pensabile di
poterli immettere manualmente in una o più lista come abbiamo fatto noi.
Normalmente i dati sono memorizzati su un file ed è necessario leggerli.
Prendiamo in considerazione il file di testo heroes.csv contenuto nella
directory data: esso contiene 735 righe, ognuna con le informazioni relative
a un supereroe, separate da virgola. Le prime tre righe del file sono indicate
di seguito.
!head -3 data/heroes.csv
id,name,identity,intelligence,strength,speed,durability,power,combat,creator,universe,full_name,place_of_birth,first_appearance,alignment,height,weight,eye_color,hair_color,
Laufey,Laufey,,High,100,100,100,100,100,Sony Interactive Entertainment,GoW - God of War,,Jötunheim,2018,Good,,,Blue,Strawberry Blond,
Laugh-a-Lot Bear,Laugh-a-Lot Bear,,Average,45,50,40,65,10,,Care Bears - Care Bears Universe,,,,Good,,,Black,Orange,
Il formato CSV (comma separated values) indica un record su ogni riga, separando i campi corrispondenti con un carattere speciale che di norma, ma non sempre, è la virgola. Come si può vedere, nel nostro caso la prima riga indica il tipo di dati presente in ogni riga (sono gli stessi a cui abbiamo fatto riferimento finora), viene usato il punto e virgola per separare i campi (ciò permette di inserire delle virgole nei luoghi di nascita, come nel primo record) e possono esistere dei valori mancanti (quali per esempio il luogo di nascita nel secondo record).
La cella seguente legge i contenuti del file e li inserisce nella lista
heroes.
import csv

with open('data/heroes.csv', 'r') as heroes_file:
  heroes_reader = csv.reader(heroes_file, quotechar='"')
  heroes = list(heroes_reader)[1:]
Nella cella:
l'apertura del file è fatta utilizzando la parola chiave
with: nelle istruzioni indentate che seguono è possibile usareheroes_fileper fare riferimento all'oggetto che descrive il file, e quest'ultimo sarà automaticamente chiuso, anche nel caso in cui vengano lanciate eccezioni, all'uscita del corpo diwith;la funzione che apre il file accetta come primo argomento il pathname corrispondente e come secondo una stringa che indica come effettuare l'accesso:
'rb'indica lettura in modalità binaria, cosa che permette di non doversi preoccupare di dover gestire come il sistema operativo indica la fine linea nei file di testo;la lettura effettiva del file è demandata al modulo
csvche si occupa direttamente di convertire dal formato CSV: la funzionecsv.readergestisce anche il fatto di avere un separatore diverso dalla virgola e permette di inserire un punto e virgola in un campo a patto di delimitare quest'ultimo tra doppi apici;la parola chiave
listconverte il contenuto del file in una lista, e da quest'ultima si esclude la prima riga (in quanto essa contiene le intestazioni dei campi).
Nomenclatura
In generale usando il nome di un tipo come se fosse una funzione è possibile
effettuare conversioni tra tipi di dati: per esempio int('42') converte una
stringa in intero e str(42) effettua la conversione inversa.
Proviamo a visualizzare i primi due record (che corrispondono alle due righe sopra mostrate):
heroes[:2]
[['Laufey',
  'Laufey',
  '',
  'High',
  '100',
  '100',
  '100',
  '100',
  '100',
  'Sony Interactive Entertainment',
  'GoW - God of War',
  '',
  'Jötunheim',
  '2018',
  'Good',
  '',
  '',
  'Blue',
  'Strawberry Blond'],
 ['Laugh-a-Lot Bear',
  'Laugh-a-Lot Bear',
  '',
  'Average',
  '45',
  '50',
  '40',
  '65',
  '10',
  '',
  'Care Bears - Care Bears Universe',
  '',
  '',
  '',
  'Good',
  '',
  '',
  'Black',
  'Orange']]
Si vede che tutti i dati sono indicati come stringhe (vedremo più avanti un modo più efficiente di rilevare i diversi tipi di dati in modo corretto), e che la stringa vuota è usata per codificare i dati mancanti.
Per poter generare il grafico delle frequenze assolute con i nuovi dati è necessario estrarre l'anno di prima apparizione da ogni record. Potremmo farlo anche in questo caso usando il trucco di trasporre il corrispondente array, ma c'è un modo molto più efficiente che prende il nome di list comprehension, una sintassi specifica di python. Invece di creare una lista in modo estensivo (cioè elencando i suoi elementi), la list comprehension permette di crearla in modo intensivo, specificando come trasformare gli elementi di un'altra lista che già abbiamo a disposizione. La sintassi di base di una list comprehension è
[f(e) for e in l]
dove f(e) indica una funzione o un'espressione che dipende dalla variabile
muta e e l è una lista di cui quindi e indica il generico elemento.
Questa espressione permette di costruire una nuova lista in cui il primo
elemento è il risultato del calcolo di f sul primo elemento di l, il
secondo è il risultato di f secondo elemento di l e così via. È inoltre
possibile utilizzre la sintassi [f(e) for e in l if g(e)], che indica che
nella creazione della nuova lista bisogna limitarsi a considerare gli elementi
e della lista originale che rendono vera l'espressione g(e). Pertanto
years = [int(h[7]) for h in heroes if h[7]]
assegna a years la lista che contiene l'anno di prima apparizione di ogni
supereroe (che infatti occorre in ottava posizione), convertito da stringa a
intero, ma senza considerare le stringhe vuote (in python la stringa vuota
equivale a un'espressione logica falsa esattamente come 0 o 0. in C, e le
altre stringhe equivalgono a un'espressione logica vera), operazione
necessaria altrimenti la conversione a intero di un dato mancante lancerebbe
un'eccezione.
A questo punto è possibile generare il grafico delle frequenze assolute:
import matplotlib.pyplot as plt
import numpy as np

def get_sorted_counts(sequence):
    counts = {}

    for x in sequence:
        if x in counts:
            counts[x] += 1
        else:
            counts[x] = 1

    pairs = counts.items()
    return sorted(pairs, key=lambda p:p[1], reverse=True)

counts = get_sorted_counts(years)
x, y = np.array(counts).transpose()
plt.bar(x, y)
plt.show()
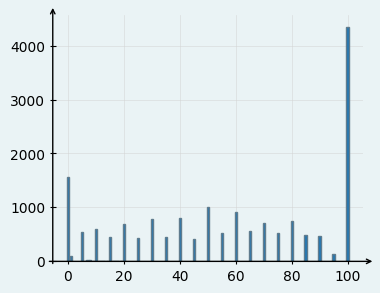
Il grafico appare "spostato" verso sinistra, a causa della presenza di una barra in prossimità dell'anno 2100. Potrebbe essere un supereroe effettivamente nato nel futuro, oppure si potrebbe trattare di un dato errato. Si tratta di una situazione più comune di quanto non si possa pensare: queste misurazioni affette da rumore prendono il nome di dati fuori scala o outlier e più avanti vedremo come gestirle. Per ora limitiamoci a vedere quale sia questo valore. Possiamo farlo usando una list comprehension appena più complicata di quella vista poco fa:
[year for year in years if year > 2020]
[]
In soldoni, la presenza dell'anno 2099 causa lo spostamento del grafico.
Potremmo eliminare il record corrispondente dal nostro dataset, ma così facendo
perderemmo i valori per gli altri campi che non è detto siano anch'essi degli
outlier. Un modo molto più pratico di procedere è quello di visualizzare il
grafico restringendo le ascisse all'intervallo temporale che va dal 1950 al
2015: ciò viene fatto invocando la funzione plt.xlim e passandole una coppia
con gli estremi di questo intervallo. Già che ci siamo, possiamo anche
impostare l'ampiezza dell'asse delle ordinate in modo che ci sia un po' di
spazio sopra la barra che corrisponde alla frequenza massima:
plt.bar(x, y)
plt.xlim((1950, 2015))
plt.ylim((0, 18.5))
plt.show()
Nomenclatura
In teoria, una volta ottenuta la lista counts, è possibile generare il
grafico (ridmensionamento dei suoi assi a parte) usando l'istruzione più
compatta plt.bar(*np.array(counts[1:]).T) in cui
l'invocazione del metodo
transposeè sostituita dall'utilizzo della proprietàT: si tratta essenzialmente della stessa cosa, ma permette di essere più succinti;invece di assegnare a due variabili
xeyle liste di ascisse e ordinate, si usa l'operatore*per effettuare un'altra forma di unpacking delle liste in modo che i due elementi della lista restituita daTvengano rispettivamente usati come primo e secondo argomento dinp.bar.
Va in ogni caso sottolineato che il minor numero di linee si paga con del codice più complesso e quindi meno facile da leggere e da correggere in caso di errore, quindi almeno fino a quando non si è abbastanza confidenti nel linguaggio è meglio non ricorrere a soluzioni troppo complicate.