
 Italiano
 English
 Français
 Español
21.1. Dal discreto al continuo#
Dato \(n \in \mathbb N\), consideriamo l'insieme \(D_n = \{ \frac{i}{n}, i = 0, \dots, n \}\) e la variabile aleatoria \(X_n\) definita dalla funzione di massa di probabilità
Chiaramente, la distribuzione di \(X_n\) ricorda il modello uniforme discreto, con la sola differenza che in questo caso il dominio include la specificazione \(0\). Supponiamo ora che \(n\) assuma un valore molto grande: dato un generico \(k \in D_n\), si ha \(\mathbb P(X_n = k) = \frac{1}{n + 1}\) e dunque diventa molto vicina a zero la probabilità che \(X_n\) assuma una qualsiasi delle sue specificazioni. Ciò non deve sembrare strano, perché queste ultime si addensano in \([0, 1]\) man mano che \(n\) cresce, pertanto specificazioni molto vicine tra loro diventeranno praticamente indistinguibili.
Esempio 123 (Il multiverso DC)
A partire dal 1961, e in particolare nel numero 123 di «The Flash», le storie dei fumetti pubblicati da DC non avvengono in un unico universo, bensì in più universi che esistono in uno spazio comune, ma i cui abitanti "vibrano" a frequenze diverse. Ogni universo è identificato in modo univoco da un nome, che nella maggior parte dei casi indica come viene denominato il pianeta Terra, e l'insieme di tutti gli universi è chiamato multiverso [1]. Ogni protagonista può avere caratteristiche molto diverse a seconda del corrispondente universo: per esempio, Wonder Woman è buona quasi sempre, ma sicuramente non su Terra-Ventidue. Ora, ipotizziamo che in ognuno di questi universi esistano esattamente \(n = 15000\) protagonisti diversi, oguno con il proprio allineamento (buono, neutrale o cattivo). Immaginiamo anche che esista un criterio per scegliere a caso un universo all'interno del multiverso. La variabile aleatoria \(X_n\) che indica la frazione di protagonisti "buoni" nell'universo selezionato è distribuita sul dominio \(D_{15000}\) secondo la funzione di massa di probabilità (21.1). Ora, ha poco senso discriminare, per dire, tra le specificazioni \(\frac{42}{15000}\), \(\frac{43}{15000}\) e \(\frac{49}{15000}\), perché la loro differenza massima equivale a meno dello \(0.05\%\) del totale.
Prima di approfondire che cosa succede all'aumentare di \(n\), calcoliamo il valore atteso e la varianza di \(X_n\), perché ci saranno utili in seguito.
Lemma 5
Il valore atteso e la varianza di \(X_n\) sono rispettivamente uguali a \(\frac{1}{2}\) e a \(\frac{1}{12} + \frac{1}{6 n}\).
Dimostrazione.
Applicando le formule per il calcolo di valore atteso e varianza si ottiene:
Va notato come il valore atteso sia sempre uguale a \(\frac{1}{2}\) indipendentemente dal valore di \(n\), come ci si può aspettare tenuto conto del fatto che, essendo la massa di probabilità costante, la centralità della distribuzione deve coincidere con il baricentro delle osservazioni. Per quanto riguarda invece la varianza, è presente un termine che dipende da \(n\) ma il cui contributo tende a diventare trascurabile man mano che questo parametro cresce.
Come dicevamo, valori tra loro abbastanza vicini per le specificazioni risultano fondamentalmente equivalenti, e dunque ha più senso ragionare in termini della probabilità che \(X_n\) assuma valori in un intervallo (anche piccolo) di specificazioni piuttosto che studiare eventi in cui essa risulta uguale a una fissata specificazione. Calcoliamo dunque la funzione di distribuzione cumulativa di \(X_n\): fissato \(x \in [0, 1]\), esisteranno \(i \in \{ 0, \dots, n \}\) ed \(\epsilon < \frac{1}{n}\) tali che \(x = \frac{i}{n} + \epsilon\), e pertanto
così che in generale
A questo punto possiamo calcolare la probabilità che \(X_n\) assuma valori in un intervallo: fissati \(a, b \in [0, 1]\) con \(a \leq b\) esisteranno \(i, j \in \{ 0, \dots, n \}\) con \(i < j\) ed \(\epsilon_1, \epsilon_2 \in [0, \frac{1}{n})\) tali che \(a = \frac{i}{n} - \epsilon_1\) e \(b = \frac{j}{n} + \epsilon_2\). Pertanto
Prima di approfondire cosa succede quando \(n \to +\infty\), osserviamo il comportamento di questa probabilità al crescere di \(n\). Usando la disuguaglianza \(x - 1 < \lfloor x \rfloor \leq x\) applicata separatamente a \(\lfloor nb \rfloor\) e \(\lceil na \rceil\), e applicando il teorema dei due Carabinieri, si ottiene
Nel passaggio al limite, dunque, la probabilità che la variabile aleatoria cada nell'intervallo \([a, b]\) tende alla sua semplice ampiezza. Questo risultato sarà il filo conduttore per capire come si calcolano le probabilità nel caso continuo.
import matplotlib.pyplot as plt
import numpy as np

def cdf(x, n):
    return np.clip((np.floor(n * x) + 1) / (n + 1), 0, 1)

def cdf_graph(n, ax):
    x = np.linspace(-0.1, 1.1, 100)
    y = cdf(x, n)
    ax.step(x, y)
    ax.plot(x, np.clip(x, 0, 1), dashes=[2,], linewidth=1.2,
            color='#1f77b4')
    ax.set_xlabel(rf'$n = {n}$')

fig, ax = plt.subplots(1, 3, figsize=(15, 5))

for i in range(1, 4):
    cdf_graph(10 * i, ax[i-1])

fig
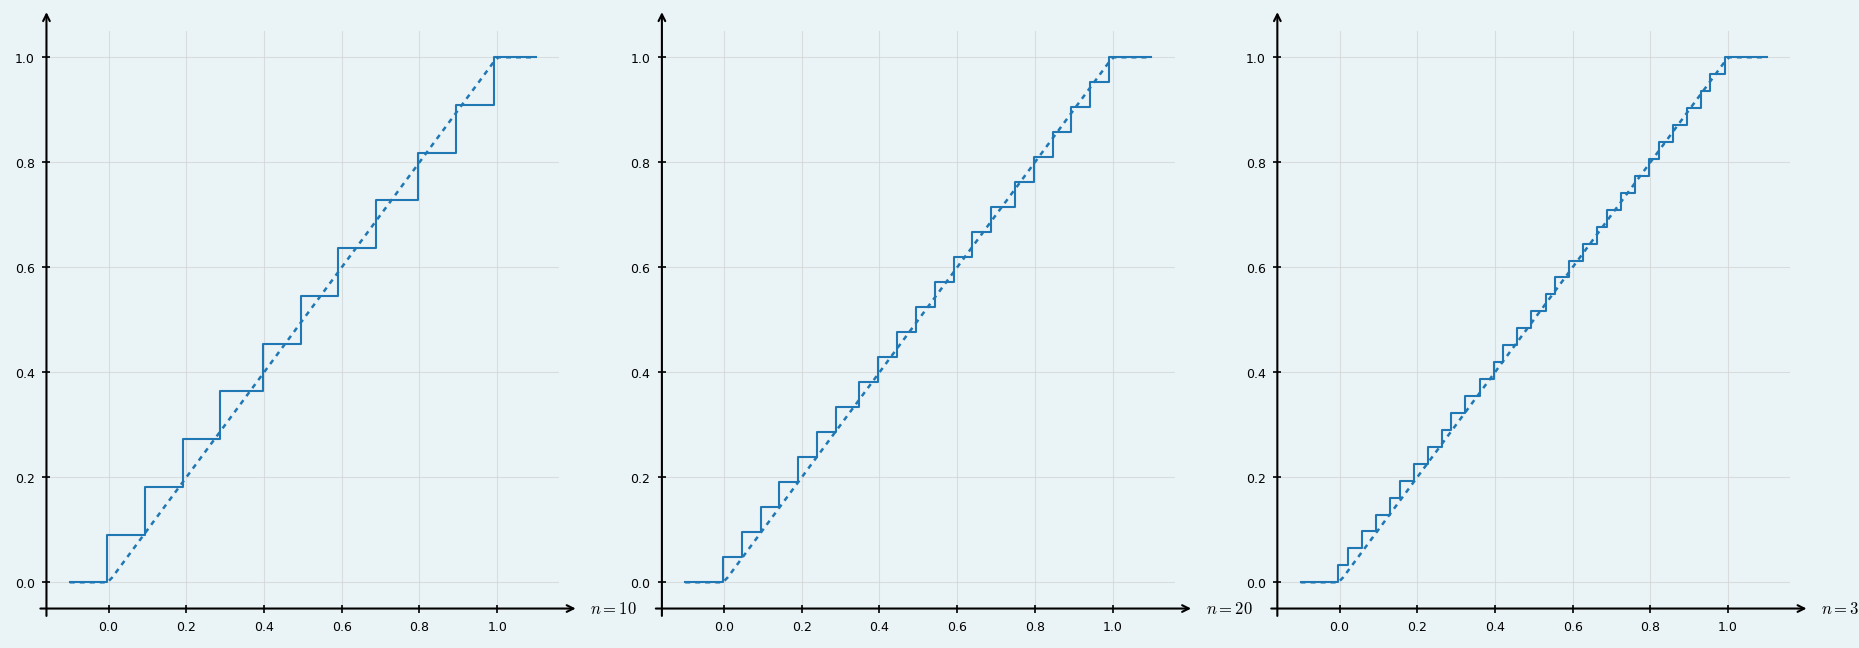
Figura 86 Le spezzate piene mostrano i grafici della funzione di distribuzione cumulativa di \(X_n\) per \(n\) rispettivamente uguale a \(10\), \(20\) e \(30\) (da sinistra verso destra); la spezzata tratteggiata evidenzia il grafico di \(F_X\).#
Che cosa succede a \(F_{X_n}\) se il valore di \(n\) aumenta progressivamente? Consideriamo la funzione \(F: \mathbb R \to [0, 1]\) definita da
La Figura 86, che mostra i grafici di \(F_{X_{10}}\), \(F_{X_{20}}\) e \(F_{X_{30}}\) affiancandoli a quello di \(F\), suggerisce l'intuizione che \(F_{X_n}\) tenda a \(F\) quando \(n \to +\infty\). Non è difficile provare formalmente che questa intuizione è corretta: ricordando che per ogni \(x\) vale \(x - 1 \leq \lfloor x \rfloor \leq x\), da (21.2) si verifica che
e applicando il teorema dei due Carabinieri si ottiene \(F_{X_n}(x) \to x = F(x)\) per ogni \(x \in [0, 1]\). Estendere questo risultato a ogni \(x \in \mathbb R\) è banale [3].
Notiamo che \(F\) soddisfa tutti i criteri indicati nel Teorema 19, dunque essa deve essere la funzione di distribuzione cumulativa di una qualche variabile aleatoria \(X\). Questa variabile aleatoria è però completamente diversa da quelle che abbiamo finora considerato: il grafico di \(F\) non evidenzia discontinuità alle quali far corrispondere i punti di massa della distribuzione perché questa funzione è continua. D'altronde da (21.1) si vede facilmente che per ogni \(x \in \mathbb R\) si ha \(\lim_{n \to + \infty} p_{X_n}(x; n) = 0\), o equivalentemente \(\mathbb P(X = x) = 0\). Analogamente, dato un qualsiasi insieme finito \(A = \{ a_1, \dots, a_n \} \subseteq [0, 1]\) si avrà
In altre parole, quando \(n\) tende a infinito ci troviamo di fronte a una distribuzione che non evidenzia alcun punto di massa di probabilità. Ciò richiede innanzitutto di definire in modo diverso il concetto di dominio per la distribuzione stessa. Nel caso che stiamo considerando, solo valori compresi tra \(0\) e \(1\) possono essere specificazioni valide, quindi il dominio di \(X\) può essere intuitivamente individuato nell'intervallo corrispondente. Si può inoltre verificare abbastanza facilmente che se all'inizio del paragrafo avessimo posto \(D_n = \{\frac{1}{n}, \dots, n \}\) e definito la funzione di massa di probabilità di \(X_n\) come \(p_{X_n}(x; n) = \frac{1}{n} \mathrm I_{D_n}(x)\), escludendo in altre parole il punto di massa \(0\) dal dominio, avremmo comunque ottenuto \(F\) come limite delle corrispondenti funzioni di ripartizione quando \(n \to +\infty\). Il risultato non sarebbe cambiato se avessimo deciso di escludere il punto di massa \(1\) al posto di \(0\), o di escluderli entrambi. Tenuto conto di quanto appena ricavato, possiamo per convenzione scegliere \([0, 1]\) come dominio di \(X\).
La differenza fondamentale tra \(X\) e le variabili aleatorie che abbiamo studiato finora sta proprio nel fatto che il suo dominio è un insieme continuo. Quando questo succede, si parla di variabili aleatorie aventi una distribuzione continua, o più brevemente di variabili aleatorie continue. La formalizzazione di questo tipo di variabili aleatorie e delle relative famiglie di distribuzione verrà descritta a partire dal Paragrafo 21.2: in particolare, nel Paragrafo 21.3 vedremo che \(X\) segue una distribuzione uniforme continua sull'intervallo \([0, 1]\).
Tornando a concentrarci sul caso che stiamo analizzando, la mancanza di punti di massa di probabilità richiede di rimpiazzare la corrispondente funzione con un altro strumento che permetta di calcolare le probabilità di eventi che coinvolgono \(X\). La risposta è già nascosta nella funzione di ripartizione \(F\) che abbiamo appena costruito. Ricordiamo che \(F(x)\) misura quanta probabilità si è «accumulata» fino al punto \(x\). Nel caso discreto, ogni volta che \(x\) attraversa una specificazione \(k\), la funzione \(F_{X_n}\) compie un salto di ampiezza \(\frac{1}{n+1}\): è in quei punti che si concentra tutta la massa di probabilità. Nel caso limite, invece, \(F\) non compie mai salti: cresce in modo regolare e uniforme su tutto \([0, 1]\), senza punti privilegiati. Possiamo però chiederci quanto velocemente \(F\) cresca in ciascun punto. Fissato \(x \in [0,1]\) e un \(\varepsilon > 0\) piccolo, la probabilità che \(X\) cada nell'intervallo \((x, x+\varepsilon]\) è
Dividendo per \(\varepsilon\) si ottiene il tasso di crescita medio di \(F\) attorno a \(x\):
Quando \(\varepsilon \to 0\), questo rapporto tende alla derivata di \(F\) nel punto \(x\). La funzione \(F'\) misura quindi la velocità con cui la probabilità si accumula al variare di \(x\): è alta nelle regioni in cui la probabilità è concentrata, bassa dove essa è rarefatta. Questa funzione è la funzione di densità di probabilità (o, più brevemente, funzione di densità) di \(X\), che indichiamo con \(f_X\):
Nel caso che stiamo analizzando, \(F(x) = x\) per \(x \in [0,1]\), e dunque
e \(f_X(x) = 0\) altrove. La densità è costante: ogni punto dell'intervallo contribuisce in uguale misura all'accumulo di probabilità, esattamente come ci si aspetta da un modello uniforme. Riassumendo, \(f_X(x) = \mathrm I_{[0, 1]}(x)\).
Sapere che \(f_X = F'\) non determina \(F\) in modo univoco: qualsiasi funzione della forma \(F(x) + C\), con \(C\) costante reale, ha la stessa derivata \(f_X\). Tuttavia nel nostro contesto sappiamo qualcosa in più: \(F\) è una funzione di ripartizione, e deve quindi soddisfare \(\lim_{x \to -\infty} F(x) = 0\). Questo vincolo seleziona univocamente la costante \(C = 0\), e ci permette di scrivere
In altre parole, \(F\) non è una generica primitiva di \(f_X\), ma l'unica primitiva che si annulla a \(-\infty\). A partire da questa relazione, il teorema fondamentale del calcolo integrale fornisce immediatamente un modo per calcolare la probabilità di qualsiasi intervallo \((a, b]\):
Vale inoltre la pena osservare che questo risultato è coerente con il limite calcolato nel caso discreto: avevamo ricavato che \(\mathbb P(a \leq X_n \leq b) \to b - a\) quando \(n \to +\infty\), e integrare la densità uniforme \(f_X = 1\) sull'intervallo \([a, b]\) dà esattamente \(b - a\).
Infine, la relazione \(F(x) = \int_{-\infty}^x f_X(t)\, \mathrm{d}t\) ci fornisce anche le due proprietà fondamentali che ogni densità di probabilità deve soddisfare. Poiché \(F\) è non decrescente, la sua derivata è non negativa ovunque, quindi \(f_X(x) \geq 0\) per ogni \(x \in \mathbb{R}\). Poiché \(F\) tende a \(0\) per \(x \to -\infty\) e a \(1\) per \(x \to +\infty\), applicando il teorema fondamentale del calcolo agli estremi si ottiene
Queste due condizioni — non negatività e integrale unitario — sono per la funzione di densità esattamente ciò che la non negatività e la somma uguale a uno erano per la funzione di massa: le proprietà minime affinché \(f_X\) descriva una distribuzione di probabilità coerente.
Risulta quindi molto facile calcolare la probabilità che \(X\) sia contenuta in un intervallo \((a, b] \subseteq [0, 1]\):
Questo risultato è coerente con quello che otterremmo ricavando la stessa probabilità usando la funzione di ripartizione come indicato in (19.1): infatti,
Vale la pena osservare una cosa interessante: questo risultato non dipende dalla particolare forma dell'intervallo considerato, che può essere aperto, semichiuso o chiuso. Infatti, le proprietà dell'integrale di Riemann ci assicurano che calcolando, per esempio, \(\mathbb P(X \in [a, b])\) in modo analogo a quanto fatto in (21.4), otterremmo lo stesso valore di probabilità. Non c'è alcuna incoerenza in questo risultato, in quanto \(\mathbb P(X \in [a, b]) = \mathbb P(X \in (a, b]) + \mathbb P(X = a)\) e l'ultima di queste probabilità è nulla. Con un ragionamento analogo è facile mostrare che succede lo stesso quando si considerano intervalli della forma \((a, b)\) o \([a, b)\).
Vedremo in modo preciso come la maggior parte dei concetti già introdotti per le variabili aleatorie discrete si possono estendere in modo naturale alle variabili aleatorie continue. Questo richiederà quasi sempre di modificare le formule relative sostituendo la funzione di massa di probabilità con la funzione di densità e le sommatorie con integrali, ma in alcuni casi non sarà strettamente necessario utilizzare il formalismo matematico. Consideriamo per esempio il valore atteso di \(X\): per calcolarlo è sufficiente osservare che la sua densità è costante in \([0, 1]\) e nulla altrove, pertanto la centralità della distribuzione di \(X\), e dunque il suo valore atteso, deve essere uguale a \(\frac{1}{2}\). D'altra parte, abbiamo visto come \(\mathbb E(X_n) = \frac{1}{2}\), dunque è naturale che lo stesso valga per la distribuzione limite che stiamo considerando. Facendo un ragionamento analogo, possiamo supporre che la varianza di \(X\) si ottenga come
Nel Paragrafo 21.3 vedremo come calcolare questi due valori in modo formale.