
 Italiano
 English
 Français
 Español
20.2. Le distribuzioni binomiali#
Le Lanterne Verdi sono un gruppo di supereroi, a ognuno dei quali è affidato un settore dell'Universo sul quale vegliare. Essi indossano un anello che conferisce loro un insieme non ben definito di poteri, tra i quali la capacità di creare oggetti, di volare e di sopravvivere nello spazio. La potenza di questo anello diminuisce progressivamente, ed è quindi necessario effettuare periodicamente delle operazioni di ricarica, inserendo l'anello in una batteria a forma di lanterna (da cui il nome dei supereroi). Le modalità con cui la potenza diminuisce e la frequenza di ricarica sono cambiate via via che le serie che coinvolgono il gruppo delle Lanterne Verdi hanno preso forma. Semplificando, immaginiamo che la potenza dell'anello diminuisca di una quantità fissa ogni volta che questo viene utilizzato, e che partendo da una piena ricarica sia possibile farlo per dieci volte. Supponiamo che quando un (o una) Lanterna Verde affronta un nemico, ogni attacco fatto grazie all'anello vada a segno con una probabilità \(p\) prefissata. Se l'anello è completamente carico e Lanterna Verde ha di fronte a sé dieci nemici che attacca uno dopo l'altro, ognuno per una sola volta, di quanti di essi riuscirà adisfarsi? Sappiamo che l'anello può essere utilizzato per dieci volte, quindi in teoria ogni attacco potrebbe avere successo, sconfiggendo tutti e dieci gli avversari. D'altro canto, se nessuno degli attacchi va a segno non vi sarà alcun nemico battuto. In generale, ci potranno essere da zero a dieci attacchi vittoriosi, e ogni attacco può essere pensato come un esperimento di Bernoulli di parametro fisso, nel quale ovviamente il successo si verifica quando l'avversario viene battuto. Il numero di vittorie si può quindi pensare come il numero di successi in dieci ripetizioni di questo esperimento di Bernoulli. Se si esegue nuovamente l'intero processo che consiste nell'eseguire le dieci ripetizioni e nel contare i successi, il risultato sarà potenzialmente diverso, dunque siamo in presenza di un nuovo tipo di esperimento casuale, i cui esiti vengono generalmente descritti utilizzando una distribuzione binomiale.
20.2.1. Il modello binomiale#
Quando un fissato esperimento di Bernoulli di parametro \(p\) viene ripetuto in condizioni di indipendenza per \(n\) volte e si conta il numero di successi, il risultato è un numero intero che definisce in modo banale una variabile aleatoria, nel senso che è possibile definire una variabile aleatoria \(X\) che assume come valore esattamente il numero di successi rilevato. La distribuzione di questa variabile aleatoria viene detta di tipo binomiale, e il suo supporto sarà dunque l'insieme dei numeri \(D_X = \{ 0, 1, \dots, n \}\). Dato \(x \in D_X\), per calcolare la probabilità \(\mathbb P(X=x)\) che esattamente \(x\) delle \(n\) ripetizioni abbiano come esito un successo possiamo ragionare nel modo seguente. Per evitare ambiguità, chiamiamo esperimento binomiale l'esperimento casuale che consiste nel contare il numero di successi nelle \(n\) esecuzioni, così da non confonderlo con l'esperimento di Bernoulli che viene ripetuto. Possiamo visualizzare lo spazio \(\Omega\) degli esiti dell'esperimento binomiale come l'insieme delle parole di \(n\) caratteri, ognuno dei quali può essere alternativamente \(\text{S}\) oppure \(\text{F}\), a indicare, nell'ordine, un successo e un fallimento. Per esempio, fissando \(n=7\), \(\text{SSSFFFF}\) indica l'esito che si verifica quando nelle sette ripetizioni dell'esperimento di Bernoulli si ottiene un successo alle prime tre ripetizioni, mentre tutte quelle che seguono portano a un fallimento. Ora, la probabilità che questo succeda è
e l'indipendenza che governa per definizione la ripetizione degli esperimenti permette di calcolare questa probabilità come
Siccome le probabilità di successo e di insuccesso sono sempre uguali a \(p\) e a \(1-p\), quale che sia la ripetizione considerata, avremo
Usando lo stesso ragionamento si verifica facilmente che si ottiene la stessa probabilità se invece di \(\text{SSSFFFF}\) si considera \(\text{FFFFSSS}\), \(\text{FSFSFSF}\) o in generale qualunque esito che contiene tre successi e quattro insuccessi. Se indichiamo con \(e_1, \dots, e_m\) tutti e soli gli esiti di questo tipo e per ogni \(i = 1, \dots, m\) definiamo \(E_i \triangleq \{ e_i \}\), avremo \(\mathbb P(E_i) = p^3 (1-p)^4\) e \(\{ X=3 \} = \cup_{i=1}^m E_i\). Essendo gli eventi \(E_1, \dots, E_m\) a due a due disgiunti, applicando il terzo assioma di Kolmogorov si ottiene
Rimane da calcolare il valore di \(m\), che corrisponde al numero di modi diversi di avere \(3\) successi in \(7\) esecuzioni dell'esperimento, o in alternativa nel numero di parole di \(7\) caratteri dei quali \(3\) sono uguali a \(\text{S}\) e i rimanenti sono uguali a \(\text{F}\). Questo conteggio si effettua facilmente se si calcola il numero di modi nei quali è possibile selezionare le tre posizioni nelle quali inserire \(\text{S}\), perché una volta fatto questo basterà completare le stringhe inserendo \(\text{F}\) in tutte le posizioni rimaste libere. Ognuna delle posizioni selezionate si può descrivere con un numero intero da \(1\) a \(7\), e quindi le posizioni selezionate descrivono un sottoinsieme di \(\{1, 2, 3, 4, 5, 6, 7 \}\) che contiene esattamente tre elementi. Il numero di siffatti sottoinsiemi è uguale al numero di combinazioni di \(7\) oggetti in \(3\) posti, il che permette di concludere che
Se riconsideriamo ora l'intero ragionamento, ma in termini di un generico numero \(n\) di ripetizioni, fissato \(x \in D_X\) si ottiene facilmente che
Siamo quindi in grado di definire in modo formale la famiglia delle distribuzioni binomiali.
Definizione 46 (La famiglia delle distribuzioni binomiali)
Fissati \(n \in \mathbb N\) e \(p \in [0, 1]\), la distribuzione binomiale di parametri \(n\) e \(p\) è definita dalla funzione di massa di probabilità
Per indicare che una variabile aleatoria \(X\) segue una siffatta distribuzione utilizzerò la notazione \(X \sim \mathrm B(n, p)\). L'insieme di tutte le distribuzioni binomiale al variare dei relativi parametri prende il nome di famiglia delle distribuzioni binomiali.
Si verifica facilmente che l'andamento della funzione di massa di probabilità nei relativi punti di massa cresce inizialmente per poi decrescere. Infatti, per un generico \(x \in \{0, \dots, n-1\}\) vale
e lo stesso rapporto diventa uguale a \(1\) quando \(x = (n+1)p - 1\). Se tale valore è intero, lo sarà anche \((n+1)p\) e \(f_X(x+1; n, p) = f_X(x; n, p)\). In tal caso, sempre calcolando \(f_X\) solo in corrispondenza delle specificazioni della distribuzione, avremo che la funzione di massa di probabilità
è strettamente crescente da \(x = 0\) a \(x = (n+1)p - 1\),
assume il suo massimo per \(x = (n+1)p - 1\) e \(x = (n+1)p\), che sono quindi i due valori modali, e
decresce strettamente da \(x = (n+1)p\) in avanti.
Quando invece \((n+1)p - 1\) non è intero, i valori della funzione di massa di probabilità crescono strettamente fino alla moda \(x = \lfloor (n+1)p \rfloor\), per poi decrescere, sempre strettamente, come illustrato nella Figura 65, che mostra i grafici della funzione di massa di probabilità della distribuzione binomiale di parametri \(n = 10\) e \(p\) uguale a \(\frac{4}{11} \approx 0.36\) (a sinistra) e \(0.4\) (a destra).
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as st

fig, axes = plt.subplots(1, 2, sharey=True)

n = 10
x = np.arange(n+1)

for ax, p in zip(axes, (4 / (n+1), 0.4)):

    X = st.binom(n, p)

    ax.vlines(x, 0, X.pmf(x))
    ax.plot(x, X.pmf(x), 'o')
    ax.set_xticks(range(0, 11, 2))

fig
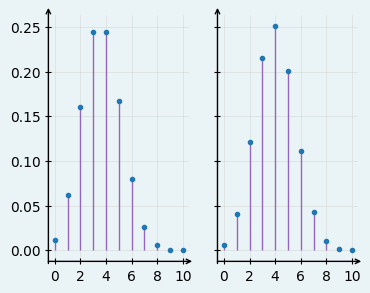
Figura 65 Grafici della funzione di massa di probabilità della distribuzione binomiale di parametri \(n = 10\) e \(p\) rispettivamente uguale a \(\frac{4}{11} \approx 0.36\) (a sinistra) e \(0.4\) (a destra).#
Va notato come le due distribuzioni mostrate in questa figura sono approssimativamente simmetriche rispetto all'asse che coincide con il suo valore massimo (o che è posto esattamente a metà tra i due massimi). Si ha invece una simmetria completa quando \(f_X(x; n, p) = f_X(n-x; n, k)\) per ogni \(x = 1, \dots, \lfloor n/2 \rfloor\), che equivale a richiedere
che a sua volta coincide con \(p = 1-p\), che è verifcata solo quando \(p = 1/2\). Il modo più semplice per esprimere la forma analitica della funzione di ripartizione di \(X \sim \mathrm B(n, p)\) è
perché a differenza di quanto succede per buona parte delle distribuzioni che studieremo, non è possibile semplificare ulteriormente la sommatoria. Riassumendo, la funzione di massa di probabilità di una distribuzione ha un grafico a bastoncini approssimativamente simmetrico (con eccezione del caso \(p = n/2\), nel quale è simmetrico) le cui altezze crescono fino a un valore della specificazione che si trova vicino a \(np\) per poi iniziare a diminuire. Da ciò segue il fatto che la somma dei valori di massa di probabilità che si trovano a sinistra dell'asse di simmetria sarà approssimativamente uguale a \(\frac{1}{2}\), e lo stesso vale per i valori a destra di questo asse. La funzione di ripartizione ha di conseguenza un grafico costante a tratti che è approssimativamente simmetrico rispetto a un punto non troppo distante da \((np, 1/2)\). Ciò è illustrato in Figura 66, nel quale i grafici delle funzioni di massa di probabilità e di ripartizione vengono sovrapposti, evidenziando rispettivamente con un segmento tratteggiato e con un quadrato i suddetti asse e punto di simmetria. Modificando i valori dei due parametri si può vedere come cambia il grafico prodotto.
import asyncio
import matplotlib.pyplot as plt
import numpy as np
import scipy.stats as st
from js import document, console
from pyscript import display
from pyscript.web import page, when

n_1 = int(page['#n'][0].value)
p_1 = float(page['#p'][0].value)
B_1 = st.binom(n_1, p_1)

x_1 = np.arange(0, n_1 + 1)
y_1 = B_1.pmf(x_1)

fig_1, ax_1 = plt.subplots()

cdf_y = [0] + list(B_1.cdf(x_1))
cdf_xmin = list(range(-1, n_1 + 1))
cdf_xmax = list(range(0, n_1 + 1)) + [20]
cdf = ax_1.hlines(cdf_y, cdf_xmin, cdf_xmax)
pmf_lines = ax_1.vlines(x_1, 0, y_1, color='k')
pmf_dots = ax_1.plot(x_1, y_1, 'o')[0]

ax_1.set_xlabel('$x$', fontsize=12, ha='right')
ax_1.set_ylabel('$f, F$', fontsize=12, rotation=0)
ax_1.set_xlim(-1, 21)
ax_1.set_ylim(0, 1.1)
ax_1.set_xticks(range(0, 21, 2))

@when("input", "#p, #n")
def binomial_plot(event):
    p_1 = float(page['#p'][0].value)
    page['#p-value'][0].innerHTML = f'{p_1:.1f}'
    n_1 = int(page['#n'][0].value)
    page['#n-value'][0].innerHTML = f'{n_1}'

    B_1 = st.binom(n_1, p_1)
    x_1 = np.arange(0, n_1 + 1)
    y_1 = B_1.pmf(x_1)

    cdf_y = [0] + list(B_1.cdf(x_1))
    cdf_xmin = list(range(-1, n_1 + 1))
    cdf_xmax = list(range(0, n_1 + 1)) + [20]
    cdf_segments = [[[xmin, y_val], [xmax, y_val]]
                    for y_val, xmin, xmax in zip(cdf_y, cdf_xmin, cdf_xmax)]

    cdf.set_segments(cdf_segments)

    # Update PMF vertical lines
    pmf_segments = [[[xi, 0], [xi, yi]] for xi, yi in zip(x_1, y_1)]
    pmf_lines.set_segments(pmf_segments)

    pmf_dots.set_data(x_1, y_1)

    display(fig_1, target='graph-1', append=False)

display(fig_1, target='graph-1', append=False)
Figura 66 Grafici delle funzioni di massa di probabilità e di ripartizione del modello binomiale.#
Infine, vale la pena sottolineare un'importante relazione tra le distribuzioni binomiale e di Bernoulli: abbiamo visto che il valore assunto da \(X \sim \mathrm B(n, p)\) corrisponde al numero di successi ottenuti ripetendo \(n\) volte un esperimento di Bernoulli in condizioni di indipendenza. Se quindi introduciamo \(n\) nuove variabili aleatorie \(X_1, \dots, X_n\), tra loro indipendenti e ognuna distribuita secondo una legge di Bernoulli di parametro \(p\), vale intuitivamente la relazione
che dimostreremo in modo formale nel Paragrafo 20.2.3, ma che utilizzeremo già nel prossimo paragrafo per semplificare il calcolo del valore atteso e della varianza della distribuzione binomiale. Ragionando in modo analogo, date due variabili aleatorie indipendenti \(X_1 \sim \mathrm B(n_1, p)\) e \(X_2 \sim \mathrm B(n_2, p)\), ponendo \(Y = X_1 + X_2\) si può dimostrare che \(Y \sim \mathrm B(n_1 + n_2, p)\).
20.2.2. Valore atteso e varianza della distribuzione binomiale#
Per quanto visto alla fine del paragrafo precedente, dati \(n \in \mathbb N\), \(p \in [0, 1]\) e una variabile aleatoria \(X \sim \mathbb B(n, p)\), possiamo sempre scomporre quest'ultima nella somma di \(n\) variabili aleatorie \(X_1, \dots, X_n\), tutte tra loro indipendenti e distribuite ciascuna secondo una legge di Bernoulli di parametro \(p\). Questo permette di calcolare il valore atteso e la varianza della distribuzione binomiale in modo estremamente semplice. Per quanto riguarda il valore atteso, infatti, si ha
mentre la varianza è uguale a
dove il secondo passaggio è basato sul fatto che la varianza della somma di variabili aleatorie indipendenti è uguale alla somma delle varianze delle singole variabili.
Chiaramente, si arriva allo stesso risultato se si calcola il valore atteso applicando la relativa definizione, come dimostrato nel seguente teorema.
Teorema 35
Dati \(n \in \mathbb N\), \(p \in [0, 1]\) e una variabile aleatoria \(X \sim \mathrm B(n, p)\), \(\mathbb E(X) = np\).
Dimostrazione.
Applicando la definizione di valore atteso si ha
dove
nel terztultimo passaggio ho applicato all'indice muto della sommatoria la trasformazione \(y = x - 1\), e
nel penultimo ho messo in evidenza il fatto che il generico addendo della sommatoria coincide con il valore della funzione di massa di probabilità di variabile aleatoria \(Y \sim \mathrm B(n - 1, p)\); essendo questi valori sommati per tutte le specificazioni di questa variabile aleatoria, il totale vale \(1\).
Similmente, la varianza si può calcolare in modo analogo a quanto fatto finora per le altre distribuzioni, come mostrato di seguito.
Teorema 36
Dati \(n \in \mathbb N\), \(p \in [0, 1]\), la varianza di una variabile aleatoria \(X \sim \mathrm B(n, p)\) è uguale a \(np(1-p)\).
Dimostrazione.
Procedendo in modo analogo al Teorema 35 si ha
così che \(\mathrm{Var}(X) = \mathbb E \left( X^2 \right) - \mathbb E(X)^2 = np - n^2p^2 = n p (1 - p)\).
20.2.3. Momenti delle distribuzioni binomiali (*)#
Fissati \(n \in \mathbb N\) e \(p \in [0, 1]\), la funzione generatrice dei momenti di una variabile aleatoria \(X \sim \mathrm B(n, p)\) soddisfa
e permette di dimostrare (20.4).
Teorema 37
Dati \(n \in \mathbb N\), \(p \in [0, 1]\) e una variabile aleatoria \(X \sim \mathbb B(n, p)\), vale la relazione
dove per ogni \(i = 1, \dots, n\) si ha \(X_i \sim \mathrm B(p)\), e queste \(n\) variabili aleatorie sono tra loro indipendenti.
Dimostrazione.
L'ipotesi di indipendenza di \(X_1, \dots, X_n\) permette di applicare il Teorema 32: indicando con \(m_X\) la funzione generatrice dei momenti della distribuzione \(\mathrm B(p)\) si ottiene
da cui segue la tesi.
Procedendo in modo molto simile possiamo dimostrare che la somma di due variabili aleatorie binomiali indipendenti e con lo stesso parametro \(p\) segue anch'essa una distribuzione binomiale.
Teorema 38
Siano dati \(n_1, n_2 \in \mathbb N\), \(p \in [0, 1]\) e due variabili aleatorie indipendenti \(X_1\) e \(X_2\) tali che \(X_i \sim \mathbb B(n_i, p)\) per \(i = 1, 2\). Definita \(Y \triangleq X_1 + X_2\), si ha \(Y \sim \mathbb B(n_1+n_2, p)\).
Dimostrazione.
Anche in questo caso, indicando per semplicità con \(m_1\) e \(m_2\) le funzioni generatrici dei momenti di \(X_1\) e \(X_2\), possiamo applicare il Teorema 32, ottenendo
che individua per \(Y\) una distribuzione binomiale di parametri \(n_1 + n_2\) e \(p\).
Derivare la funzione generatrice dei momenti della distribuzione binomiale risulta abbastanza intricato. Questo rende più ragionevole il calcolo dei momenti della distribuzione applicando direttamente la loro definizione, e sfruttando la stessa tecnica utilizzata nel Paragrafo 20.2.2 per derivare i momenti primo e secondo. Per esempio, il momento terzo si ottiene nel modo seguente:
dove \(Y \sim \mathrm B(n - 1, p)\), e dunque
Il momento centrale terzo sarà quindi uguale a
e di conseguenza la skewness vale
evidenziando come la distribuzione binomiale sia simmetrica quando \(p = \frac{1}{2}\), asimmetrica a destra quando \(p < \frac{1}{2}\) e asimmetrica a sinistra nei casi rimanenti, come esemplificato in Figura 67, che mostra il grafico della funzione di massa di probabilità binomiali di parametri \(n = 10\) e \(p\) rispettivamente uguale a \(0.3\) (a sinistra), \(0.5\) (al centro) e \(0.7\) (a destra), evidenziando rispettivamente l'asimmetria a destra, la simmetria e l'asimmetria a sinistra delle corrispondenti distribuzioni.
def binomial_plot(p, ax):
    n = 10
    x = np.arange(0, n+1)
    B = st.binom(n, p)
    ax.vlines(x, 0, B.pmf(x))
    ax.plot(x, B.pmf(x), 'o')
    ax.set_ylim(0, 0.3)

fig, axes = plt.subplots(1, 3, sharey=True)
for p, ax in zip((.3, .5, .7), axes):
    binomial_plot(p, ax)
fig
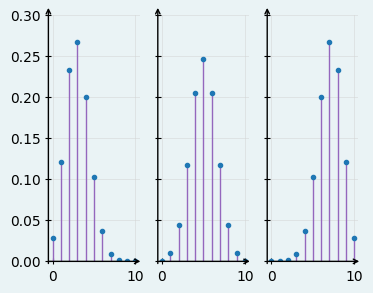
Figura 67 Grafico della funzione di massa di probabilità delle distribuioni binomiali caratterizzate da \(n = 10\) e \(p\) rispettivamente uguale a \(0.3\) (a sinistra), \(0.5\) (al centro) e \(0.7\) (a destra); i tre casi esemplificano, nell'ordine, il concetto di distribuzione asimmetrica a destra, simmetrica e asimmetrica a sinistra.#
Va notato come i due parametri influenzino in modo diverso questo coefficiente: infatti, indipendentemente da \(n\) il suo valore tende a infinito tanto più \(p\) si avvicina a \(0\) oppure a \(1\), e ciò è dovuto al fatto che la distribuzione non possiede una delle sue due code, essendo localizzata vicino agli estremi del suo supporto; d'altra parte, quando \(p\) è abbastanza lontano dai suoi valori estremi la simemtria della distribuzione è maggiormente influenzata da \(n\), perché quanto più esso aumenta, tanto più si estendono la sue due code.
In modo simile si ottiene il momento quarto: sempre introducendo \(Y \sim \mathbb B(n-1, p)\),
così che il momento centrale corrispondente è
Ciò permette di ricavare la curtosi:
da cui si verifica che, indipendentemente dal valore di \(n\), la distribuzione risulta rispettivamente platicurtica, mesocurtica o leptocurtica negli stessi casi di una distribuzione di Bernoulli il cui parametro coincide con \(p\). Fatto salvo tutto ciò, \(n\) influisce comunque sulla propensione della distribuzione a generare valori fuori scala: (20.5) mostra infatti che quando \(n\) aumenta, se la distribuzione è platicurtica deve aumentare anche la curtosi, e ciò è dovuto al fatto che il supporto diventa sempre più grande e quindi le specificazioni che si possono considerare dei valori fuori scala diventano sempre di più; al contrario, quando la distribuzione è platicurtica l'aumentare del supporto tenderà ad accentuare la propensione della distribuzione a non generare valori fuori scala. La Figura 68 illustra il grafico skewness-curtosi per la famiglia delle distribuzioni di Bernoulli, generando diverse curve per differenti valori di \(n\).
from matplotlib import cm

fig, ax = plt.subplots()

n_values = (1, 2, 3, 5, 10, 100)
p = np.linspace(0.001, 0.999, 500)

colors = cm.Blues(np.linspace(0.4, 0.9, len(n_values)))

for n, c in zip(n_values, colors):
    skewness = (1 - 2*p) / (n * p * (1 - p))**0.5
    kurtosis = (1 - 6 * p * (1 - p)) / (n * p * (1 - p))

    ax.plot(skewness, kurtosis, label=n, color=c)

ax.set_xlim(-3, 3)
ax.set_ylim(-2, 2)
ax.legend()
fig
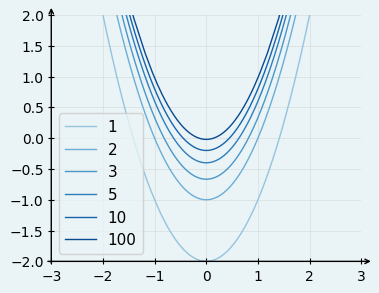
Figura 68 Grafico skewness-curtosi del modello binomiale.#
20.2.4. Quantili della distribuzione binomiale (*)#
Analizzando (20.3) si vede come determinare in modo esatto un generico quantile per la distribuzione binomiale sia decisamente complesso: occorrerebbe, dato \(q \in [0, 1]\), determinare \(x_q\) tale che
e in effetti trovare una forma analitica per la soluzione di questa equazione richiederebbe di introdurre delle funzioni, cosiddette speciali, definite in termini di particolari integrali. Possiamo però analizzare il caso particolare della mediana con un po' più di attenzione, ricordando che il grafico della funzione di massa di probabilità della distribuzione binomiale è approssimativamente simmetrico attorno al valore (o ai valori) della sua moda.
Consideriamo prima il caso nel quale ci sono due valori modali, che abbiamo visto essere i due valori interi successivi \(m_1 = (n+1)p - 1\) e \(m_2 = (n+1)p\). La simmetria approssimata ci permette di dire che
per ogni \(i = 1, \dots, \min\{m_1, n - m_2 \}\), e inoltre l'uguaglianza diventa esatta per \(i = 0\). Ciò significa che
e quindi \(\mathbb P(X \leq m_1) \approx \mathbb P(X \geq m_2)\). La somma di queste due probabilità è uguale a \(1\), dunque è ragionevole supporre che entrambe siano uguali a \(\frac{1}{2}\). Se questo fosse vero, allora la mediana di \(X\) sarebbe necessariamente uguale a \(m_1\), perché \(F_X(m_1) = \frac{1}{2}\) e \(m_1\) è la più piccola specificazione di \(X\) in corrispondenza della quale la funzione di ripartizione è maggiore o uguale di \(\frac{1}{2}\) (perché i valori della ripartizione in corrispondenza delle specificazioni più piccole di \(m_1\), se esistono, saranno necessariamente più piccoli di \(\frac{1}{2}\)). Va sottolineato, inoltre, che in questo caso \(m_1 = \lfloor np \rfloor\).
Nei casi rimanenti, c'è un unico valore modale \(m = \lfloor(n+1)p\rfloor = \lceil np \rceil\), e usando la stessa argomentazione legata alla simmetria della funzione di massa di probabilità, possiamo assumere
e i valori di queste due probabilità devono essere necessariamente minori di \(\frac{1}{2}\), altrimenti la specificazione che corrisponde alla moda avrebbe probabilità nulla. Se le due probabilità fossero uguali, ciò implicherebbe che \(m\) è anche la mediana della distribuzione. Ciò non è necessariamente vero, ma in generale si può dimostrare che la mediana della distribuzione è sempre compresa tra \(\lfloor np \rfloor\) e \(\lceil np \rceil\).
Questo tipo di ragionamento non si può estendere facilmente al calcolo dei
rimanenti quantili utilizzando una formula analitica, ma questo non ci
impedisce di calcolarli operativamente, scrivendo del codice che somma i
valori della funzione di massa di probabilità fino a quando non si ottiene un
risultato che supera il livello del quantile. La cella seguente implementa
questa strategia per implementare la funzione quantiles, che restituisce una
lista di valori che corrispondono ai quantili di una distribuzione binomiale,
specificando i parametri di quest'ultima e una lista dei livelli
corrispondenti.
from scipy.special import binom

def quantiles(n, p, levels):
    x = 0

    pdf = (1-p)**n
    cdf = pdf
    quantiles = []

    for q in levels:
        while cdf < q:
            pdf *= (n - x) / (x + 1) * p / (1 - p)
            cdf += pdf
            x += 1
        quantiles.append(x)

    return quantiles
Invece di ricalcolare da zero tutti i valori della funzione di ripartizione \(F\), questa implementazione li ottiene sfruttando una strategia basata sull'accumulazione[1]: una volta ottenuto \(F(0)\), ogni valore successivo \(F(x+1)\) è ricavato sommando a \(F(x)\), che è già stato ricavato, la probabilità della nuova specificazione \(x\). In questo modo, l'esecuzione richiede meno tempo. C'è un aspetto ancora più importante che coinvolge l'efficienza del codice: anche la funzione di massa di probabilità viene calcolata accumulandone i valori, sfruttando esplicitamente (20.2). Calcolare la funzione di massa di probabilità usando la formula (20.1) nella relativa definizione richierebbe ogni volta di valutare tre fattoriali e due elevamenti a potenza, che risulterebbero nell'esecuzione di \(3n\) moltiplicazioni. In questo modo si calcola ogni valore di \(f\) partendo da quello precedentemente ottenuto, al prezzo di \(4\) moltiplicazioni.
La funzione quantiles si può utilizzare per tabulare i quantili della
distribuzione binomiale, come fatto per esempio nella cella seguente e
relativamente al caso \(n = 32\) e \(p = 0.65\).
import pandas as pd

n = 32
p = 0.65
levels = np.arange(0.05, 1, 0.05)


content = []
for q, x in zip(levels, quantiles(n, p, levels)):
    content.append({'Livello': q, 'Quantile': x})

table = pd.DataFrame.from_records(content)

table.set_index('Livello')
| Quantile | |
|---|---|
| Livello | |
| 0.05 | 16 |
| 0.10 | 17 |
| 0.15 | 18 |
| 0.20 | 19 |
| 0.25 | 19 |
| 0.30 | 19 |
| 0.35 | 20 |
| 0.40 | 20 |
| 0.45 | 21 |
| 0.50 | 21 |
| 0.55 | 21 |
| 0.60 | 22 |
| 0.65 | 22 |
| 0.70 | 22 |
| 0.75 | 23 |
| 0.80 | 23 |
| 0.85 | 24 |
| 0.90 | 24 |
| 0.95 | 25 |
Analogamente, la Figura 69 mostra il diagramma a scatola
di una generica distribuzione binomiale (e se guardate nel codice nascosto
scoprirete che per produrlo viene utilizzata proprio la funzione quantiles),
evidenziando i valori numerici di mediana, primo e terzo quartile.Agendo sui
selettori che corrispondono ai due parametri della distribuzione è possibile
vedere come cambia il diagramma.
fig_bp, ax_bp = plt.subplots()

@when("input", "#p-bp, #n-bp")
def binomial_bp(event):
    p_bp = float(page['#p-bp'][0].value)
    page['#p-bp-value'][0].innerHTML = f'{p_bp:.1f}'
    n_bp = int(page['#n-bp'][0].value)
    page['#n-bp-value'][0].innerHTML = f'{n_bp}'

    B_bp = st.binom(n_bp, p_bp)
    q1 = B_bp.ppf(0.25)
    median = B_bp.median()
    q3 = B_bp.ppf(0.75)
    stats = [{
        'med': median,
        'q1': q1,
        'q3': q3,
        'whislo': 0,
        'whishi': n_bp,
        'fliers': []
    }]

    # Clear and redraw
    ax_bp.clear()
    ax_bp.bxp(stats, vert=False)
    ax_bp.text(0, 0.9, 0, ha='center', fontsize=8)
    if p_bp != 0 and p_bp != 1:
        ax_bp.text(q1, 1.1, int(q1), ha='center', fontsize=8)
        ax_bp.text(median, 0.85, int(median), ha='center', fontsize=8)
        ax_bp.text(q3, 1.1, int(q3), ha='center', fontsize=8)
    ax_bp.text(n_bp, 0.9, n_bp, ha='center', fontsize=8)
    ax_bp.set_xlim(-0.5, 20.5)
    ax_bp.set_ylim(0.6, 1.4)
    ax_bp.axis('off')

    display(fig_bp, target='graph-2', append=False)

binomial_bp(None)
Figura 69 Diagramma a scatola del modello binomiale.#
20.2.5. Implementazione della distribuzione binomiale#
La creazione di oggetti che corrispondono a una distribuzione binomiale
viene effettuata in scipy.stats dalla funzione binom, che accetta come
argomenti i valori per i parametri \(n\) e \(p\) della distribuzione. Una volta
che questi oggetti sono stati creati, è possibile invocare su di essi tutti i
metodi visti nel capitolo precedente. Per esempio, nella cella seguente
vengono calcolati i decili della distribuzione binomiale di parametri
\(n = 132\) e \(p = 0.73\) (si tratta della stessa distribuzione di cui abbiamo
tabulato i quantili nel paragrafo precedente, e come si può verificare i
valori ottenuti coincidono con quelli equivalenti in quella tabulazione).
import scipy.stats as st

X = st.binom(n, p)

X.ppf(np.arange(0.1, 1, .1))
array([17., 19., 19., 20., 21., 22., 22., 23., 24.])
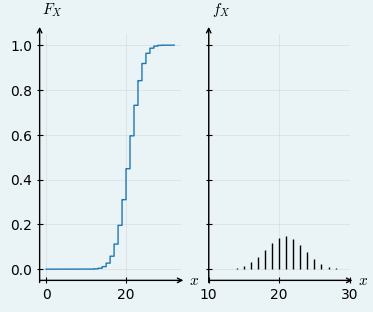
Analogamente, è possibile ottenere il grafico delle funzioni di massa di probabilità e di ripartizione della stessa distribuzione.
fig, axes = plt.subplots(1, 2, sharey=True)

x = np.arange(-0.1, n+0.1, 0.01)
axes[0].step(x, X.cdf(x))

x = np.arange(*X.support())
axes[1].vlines(x, 0, X.pmf(x), color='k')

for ax in axes:
    ax.set_xlabel(r'$x$')

axes[1].set_xlim(10, 30)

axes[0].set_ylabel(r'$F_X$', rotation='horizontal')
axes[1].set_ylabel(r'$f_X$', rotation='horizontal')
fig
Usando le stesse convenzioni grafiche del capitolo precedente, anche in questo caso è possibile simulare l'osservazione di un campione di osservazioni da una distribuzione binomiale e confrontare il grafico delle sue frequenze relative con quello della funzione di massa di probabilità. Nella Figura 70, questo viene fatto relativamente alla stessa distribuzione binomiale che abbiamo considerato finora, ma i selettori che corrispondono ai due parametri permettono, nella versione interattiva, di verificare come il grafico risultante rimanga coerente al variare dei parametri coinvolti.
import pandas as pd

fig_sim, ax_sim = plt.subplots()

@when("input", "#p-sim, #n-sim, #m-sim")
def binomial_simulation(event):

    p_sim = float(page['#p-sim'][0].value)
    page['#p-sim-value'][0].innerHTML = f'{p_sim:.1f}'
    n_sim = int(page['#n-sim'][0].value)
    page['#n-sim-value'][0].innerHTML = f'{n_sim}'
    m_sim = int(page['#m-sim'][0].value)

    B_sim = st.binom(n_sim, p_sim)
    x_sim = B_sim.rvs(m_sim)

    freq_sim = pd.Series(x_sim).value_counts(normalize=True)
    freq_sim = freq_sim.reindex(np.arange(0, n_sim + 1), fill_value=0).values

    ax_sim.clear()
    x_sim = np.arange(n_sim + 1)
    ax_sim.bar(x_sim, freq_sim, facecolor='lightgray', edgecolor='gray', width=.1)

    ax_sim.vlines(x_sim, 0, B_sim.pmf(x_sim))
    ax_sim.plot(x_sim, B_sim.pmf(x_sim), 'o')

    ax_sim.set_xlim(-1, 21)
    ax_sim.set_ylim(0, 1.1)

    display(fig_sim, target='graph-3', append=False)

binomial_simulation(None)
Figura 70 Diagramma a barre delle frequenze di un insieme di osservazioni estratte da un modello binomiale, sovrapposto al diagramma a bastoncini della corrispondente funzione di massa di probabilità.#