
 Italiano
 English
 Français
 Español
19.4. Misure di dispersione#
Come abbiamo visto nel paragrafo precedente, la centralità è solo uno degli aspetti che descrivono la distribuzione di una variabile aleatoria. La seconda caratteristica che si studia prende il nome di dispersione, o variabilità. Se la centralità ci permette di capire dove si colloca una distribuzione lungo l'insieme dei valori possibili, la dispersione permette invece di valutarne l'estensione, cioè quanto i valori che la variabile aleatoria può assumere risultano più o meno distanti tra loro. Come per la centralità, esistono vari indici ai quali si può fare riferimento, e io qui mi limiterò a introdurre solo quelli principali, considerando separatamente le due modalità con la quale si può calcolare la dispersione: rispetto a un valore centrale di riferimento, oppure nei termini della distanza tra i valori della distribuzione.
19.4.1. Dispersione rispetto a un valore centrale#
Nel Paragrafo 19.3 abbiamo visto che il valore atteso individua il baricentro di una variabile aleatoria, specificando che la sua distribuzione è descritta solo parzialmente da questo indice. In altre parole, possono esistere variabili aleatorie diverse che hanno uno stesso valore atteso, e un modo per differenziarle consiste proprio nel valutare quanto i loro valori tendano a discostarsi rispetto a questo valore atteso, come mostrato nell'esempio che segue.
Esempio 93
Consideriamo due variabili aleatorie:
\(X\), con supporto \(S_X = \{3, 5, 6\}\) e funzione di massa di probabilità definita da \(p_X(3) = 0.1\), \(p_X(5) = 0.7\) e \(p_X(6) = 0.2\);
\(Y\), caratterizzata da \(S_Y = \{1, 5, 7\}\) e \(p_Y(1) = 0.1\), \(p_Y(5) = 0.7\) e \(p_Y(7) = 0.2\).
Si verifica facilmente che
I due valori attesi sono uguali, ma le due distribuzioni sono chiaramente distinte. In particolare, quella di \(X\) è più concentrata attorno al valore atteso: i suoi valori diversi da \(5\) si trovano infatti a distanza \(2\) e \(1\) dal valore atteso comune. La distribuzione di \(Y\) è invece più sparsa, poiché gli analoghi scarti diventano rispettivamente pari a \(4\) e \(2\). La Figura 43 mostra una famiglia di distribuzioni che collega progressivamente questi due casi: spostando il selettore verso destra, le masse di probabilità più lontane dal centro si allontanano ulteriormente, mentre il valore atteso rimane fissato in \(5\). In questo modo si visualizza come una stessa centralità possa accompagnarsi a diversi gradi di dispersione.
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import FancyArrowPatch
from pyscript import display
from pyscript.web import page, when

fig_dispersion, ax_dispersion = plt.subplots()
probabilities = np.array([0.1, 0.7, 0.2])
initial_values = np.array([4.0, 5.0, 5.5])

stem_lines = ax_dispersion.vlines(initial_values, 0, probabilities)
point_markers, = ax_dispersion.plot(initial_values, probabilities, 'o',
                                    color='C0')

ax_dispersion.set_xlabel(r'$x$')
ax_dispersion.set_ylabel(r'$p_X$')
ax_dispersion.set_xlim(0, 7.5)
ax_dispersion.set_ylim(0, 0.8)
ax_dispersion.axvline(5, color='#cc6600', linestyle='--', linewidth=.5)

def render_dispersion_plot():
  dist = float(page['#dist'][0].value)

  values = np.array([5 - dist, 5, 5 + dist/2])
  segments = [((value, 0), (value, probability))
              for value, probability in zip(values, probabilities)]

  stem_lines.set_segments(segments)
  point_markers.set_data(values, probabilities)

  if dist == 2:
    ax_dispersion.set_ylabel(r'$p_X$')
  elif dist == 4:
    ax_dispersion.set_ylabel(r'$p_Y$')
  else:
    ax_dispersion.set_ylabel(r'$p_Z$')

  display(fig_dispersion, target='graph-1', append=False)


@when('input', '#dist')
def update_dispersion_plot(event):
  render_dispersion_plot()


render_dispersion_plot()
Figura 43 Funzioni di massa di probabilità di una famiglia di variabili aleatorie discrete, tutte con valore atteso uguale a \(5\), ma con diversa dispersione attorno a questo valore. Con il selettore completamente a sinistra si ottiene la distribuzione della variabile \(X\) dell'Esempio 93; con il selettore completamente a destra si ottiene invece quella di \(Y\). Nelle posizioni intermedie si visualizzano distribuzioni con la stessa centralità, ma via via più disperse.#
L'esempio precedente introduce il concetto di dispersione di una distribuzione attorno a un valore centrale, che in questo caso è proprio il valore atteso. Anche quando quest'ultimo risulta fissato, esistono in generale infinite distribuzioni aventi ognuna una dispersione differente: si può concentrare la probabilità vicino al valore atteso, oppure distribuirla più lontano, mantenendo inalterato il baricentro complessivo. Una prima idea per quantificare questo aspetto per una variabile aleatoria \(X\) potrebbe essere quella di misurare il valore atteso dello scarto dalla media, cioè considerare la variabile \(X - \mathbb E(X)\). Il problema è che, come mostrato alla fine del capitolo precedente, ogni variabile aleatoria centrata ha valore atteso nullo. In altre parole,
vale sempre, indipendentemente dal fatto che la distribuzione sia molto concentrata o molto dispersa. Gli scarti positivi e quelli negativi si compensano infatti esattamente. Per ottenere un vero indice di dispersione, occorre quindi trasformare gli scarti in modo da evitare queste compensazioni, e tipicamente questo viene fatto elevandoli al quadrato. Ciò porta alla definizione della varianza e della deviazione standard, indici a cui si fa comunemente riferimento per valutare la dispersione attorno al valore atteso, introdotti di seguito.
Definizione 35 (Varianza e deviazione standard)
Sia \(X\) una variabile aleatoria che ammette valore atteso, e sia \(\mu = \mathbb E(X)\). Se anche \((X - \mu)^2\) ammette valore atteso, si definiscono la varianza di \(X\) come
e la deviazione standard di \(X\) come la radice quadrata della varianza:
mentre negli altri casi si dice che \(X\) non ammette varianza, né deviazione standard.

Figura 44 Ritratto di Ronald Aylmer Fisher (Fotografia di autore sconosciuto, 1913. Immagine di pubblico dominio. Fonte: Wikimedia Commons).#
_
Mentre per il valore atteso si utilizza tipicamente la notazione \(\mathbb E(X)\), che è particolarmente compatta, l'uso di \(\operatorname{Var}(X)\) e \(\operatorname{SD}(X)\) per varianza e deviazione standard risulta un po' più pesante, ma nella pratica è universalmente accettato. La sigla \(\operatorname{SD}\) è talvolta sostituita da \(\operatorname{std}\), soprattutto in ambito informatico. Si incontrano frequentemente anche le notazioni \(\sigma_X^2\) e \(\sigma_X\) per varianza e deviazione standard, omettendo il pedice quando la variabile aleatoria considerata è chiara dal contesto. Questo modo di procedere ha gli stessi vantaggi e svantaggi dell'uso di \(\mu_X\) per denotare il valore atteso di \(X\). È interessante sottolineare che il termine deviazione standard è stato introdotto nel 1894 da Karl Pearson, unitamente al al simbolo \(\sigma\), presumibilmente basandosi sull'associazione con l'iniziale S. Solo più di venti anni dopo, Ronald Aylmer Fisher introdusse il termine varianza, usando \(\sigma^2\) come notazione per denotarla. L'apparizione di \(\operatorname{Var}\), invece, risulta più difficile da tracciare con precisione: sicuramente compare in [Feller, 1950], la cui influenza ha sicuramente contribuito a diffonderne l'utilizzo.
La varianza è dunque il valore atteso dello scarto quadratico dalla media, ed esprime il baricentro di questo tipo di scarti, calcolato rispetto alla distribuzione della variabile aleatoria. Il suo valore ci dice quindi quale sia, in media, lo scarto quadratico dei valori di \(X\) rispetto a \(\mathbb E(X)\). Nel caso discreto, si avrà dunque
Esempio 94 (Confrontare due dispersioni)
Riprendiamo le variabili dell'Esempio 93. Per \(X\) si ha
Per \(Y\), invece,
e questo cattura in modo quantitativo la differenza tra la dispersione di \(X\) e \(Y\): la prima variabile aleatoria è più concentrata della seconda attorno al proprio valore atteso. La Figura 45 mostra lo stesso grafico contenuto nella Figura 43, evidenziando per ogni distribuzione quali siano i valori degli scarti e calcolando esplicitamente la varianza.
import matplotlib.pyplot as plt
import numpy as np
from matplotlib.patches import FancyArrowPatch
from pyscript import display
from pyscript.web import page, when

fig_var, ax_var = plt.subplots()
probabilities_var = np.array([0.1, 0.7, 0.2])
initial_values_var = np.array([4.0, 5.0, 5.5])

stem_lines_var = ax_var.vlines(initial_values_var, 0, probabilities_var)
point_markers_var, = ax_var.plot(initial_values_var, probabilities_var, 'o',
                                 color='C0')
left_arrow_var = FancyArrowPatch((initial_values_var[0], 0.5),
                                 (initial_values_var[1], 0.5),
                                 arrowstyle='<->', mutation_scale=12,
                                 linewidth=1.0, color='#9aa3ad')
right_arrow_var = FancyArrowPatch((initial_values_var[1], 0.5),
                                  (initial_values_var[2], 0.5),
                                  arrowstyle='<->', mutation_scale=12,
                                  linewidth=1.0, color='#9aa3ad')
ax_var.add_patch(left_arrow_var)
ax_var.add_patch(right_arrow_var)
left_distance_label = ax_var.text(np.mean(initial_values_var[:2]), 0.52, '',
                                  ha='center', va='bottom', color='#7f8790')
right_distance_label = ax_var.text(np.mean(initial_values_var[1:]), 0.52, '',
                                   ha='center', va='bottom', color='#7f8790')

ax_var.set_xlabel(r'$x$')
ax_var.set_ylabel(r'$p_X$')
ax_var.set_xlim(0, 7.5)
ax_var.set_ylim(0, 0.8)
ax_var.axvline(5, color='#cc6600', linestyle='--', linewidth=.5)

def render_var_plot():
  dist = float(page['#dist-var'][0].value)

  values = np.array([5 - dist, 5, 5 + dist/2])
  segments = [((value, 0), (value, probability))
              for value, probability in zip(values, probabilities_var)]

  stem_lines_var.set_segments(segments)
  point_markers_var.set_data(values, probabilities_var)
  left_arrow_var.set_positions((values[0], 0.5), (values[1], 0.5))
  right_arrow_var.set_positions((values[1], 0.5), (values[2], 0.5))
  left_distance = values[0] - values[1]
  right_distance = values[2] - values[1]
  left_distance_label.set_position(((values[0] + values[1]) / 2, 0.52))
  right_distance_label.set_position(((values[1] + values[2]) / 2, 0.52))
  left_distance_label.set_text(f'${left_distance:.2f}$')
  right_distance_label.set_text(f'${right_distance:.2f}$')
  var = left_distance**2 * 0.1 + right_distance**2 * 0.2

  if dist == 2:
    rv = 'X'
  elif dist == 4:
    rv = 'Y'
  else:
    rv = 'Z'

  ax_var.set_title(rf'$\operatorname{{Var}}({rv}) = '
                   rf'0.1 ({left_distance:.2f})^2 + '
                   rf'0.2 \cdot {right_distance:.2f}^2 = {var:.2f}$')

  ax_var.set_ylabel(rf'$p_{rv}$')

  display(fig_var, target='graph-2', append=False)


@when('input', '#dist-var')
def update_dispersion_plot(event):
  render_var_plot()


render_var_plot()
Figura 45 Stesso grafico della Figura 43, con indicazione degli scarti tra i punti di massa e il valore atteso. Nella parte alta del grafico viene evidenziato il calcolo della varianza.#
Varianza e deviazione standard sono legate da una trasformazione monotona, quindi in generale racchiudono lo stesso tipo di informazione: più il loro valore è vicino a zero, più la distribuzione tende a essere concentrata attorno al valore atteso. La differenza tra i due indici è legata al fatto che \(\operatorname{Var}(X)\) è espressa in un'unità di misura che corrisponde al quadrato dell'unità di misura di \(X\), che molto spesso risulta difficile da interpretare: per esempio, se \(X\) indicasse i millilitri di precipitazione in una data località in un mese, \(\operatorname{Var}(X)\) sarebbe misurato in \(\mathrm{mL}^{2}\), un'unità dal significato poco intuitivo. La deviazione standard, invece, è sempre espressa nella stessa unità di misura di \(X\) e risulta quindi più facilmente comprensibile.
Esempio 95
Nell'Esempio 94 abbiamo trovato \(\operatorname{Var}(X) = 0.6\) e \(\operatorname{Var}(Y) = 2.4\). Le corrispondenti deviazioni standard sono quindi \(\operatorname{SD}(X) = \sqrt{0.6} \approx 0.77\) e \(\operatorname{SD}(Y) = \sqrt{2.4} \approx 1.55\). La seconda variabile ha varianza maggiore, e giocoforza anche una maggiore deviazione standard, ma quest'ultima ha il vantaggio di essere espressa nella stessa unità di misura della variabile aleatoria: pur contenendo la stessa informazione della varianza, risulta generalmente più immediata da interpretare.
La Definizione 35 è concettualmente molto trasparente, ma non sempre è la più comoda per i calcoli. Espandendo il quadrato, si ottiene una formula equivalente, che risulta spesso più maneggevole.
Teorema 27
Sia \(X\) una variabile aleatoria che ammette valore atteso[1] e tale che \(X^2\) ammetta un valore atteso. Allora
Dimostrazione.
Posto \(\mu = \mathbb E(X)\), dalla definizione di varianza si ottiene
Applicando le proprietà del valore atteso dimostrate a partire dal Teorema 26, si ricava
Esempio 96
Riprendendo l'Esempio 94, si ha
Siccome \(\mathbb E(X) = \mathbb E(Y) = 5\), e dunque \(\mathbb E(X)^2 = \mathbb E(Y)^2 = 25\), si ricava \(\operatorname{Var}(X) = 25.6 - 25 = 0.6\) e \(\operatorname{Var}(Y) = 27.4 - 25 = 2.4\), in linea con quanto ricavato nell'Esempio 94.
Esempio 97
Sia \(I_A\) la variabile indicatrice di un evento \(A\), e sia \(p = \mathbb P(A)\). Poiché \(I_A\) può assumere solo i valori \(0\) e \(1\), si ha \(I_A^2 = I_A\). Pertanto, usando (19.11),
La varianza è nulla solo quando l'evento è certo oppure impossibile. È invece più grande quando l'esito è più incerto, e raggiunge il proprio massimo quando \(p = 0.5\).
Esempio 98
Sia \(X\) la variabile aleatoria che descrive il risultato del lancio di un dado bilanciato a sei facce. Nell'Esempio 77 abbiamo calcolato \(\mathbb E(X) = \frac{7}{2}\), pertanto si avrà
che, anche riconoscendo la simmetria dei valori elevati al quadrato, risulta relativamente poco pratica da calcolare. D'altro canto, applicando (A.2) si ottiene
e (19.11) permette di ricavare
Nel paragrafo precedente abbiamo visto che se si trasforma una variabile aleatoria mediante una funzione affine \(x \mapsto ax+b\), il valore atteso della variabile trasformata è legato a quello della variabile originale dalla stessa trasformazione. È naturale chiedersi che cosa accada invece alla varianza. La risposta è semplice: una traslazione non cambia la dispersione catturata da questo indice, mentre una riscalatura la moltiplica per il quadrato del fattore.
Teorema 28 (Varianza di trasformazioni affini)
Sia \(X\) una variabile aleatoria che ammette varianza e siano \(a, b \in \mathbb R\). Allora
Dimostrazione.
Per il Teorema 26, si ha \(\mathbb E(aX+b) = a\,\mathbb E(X) + b\). Pertanto
che conclude la dimostrazione.
Tre conseguenze particolarmente utili sono le seguenti:
per ogni \(b \in \mathbb R\), \(\operatorname{Var}(X+b) = \operatorname{Var}(X)\), a riprova del fatto che la traslazione è un'operazione che non modifica la dispersione dei valori coinvolti;
per ogni \(a \in \mathbb R\), \(\operatorname{Var}(aX) = a^2 \operatorname{Var}(X)\), dunque riscalare la descrizione dei valori di \(X\) (per esempio modificando l'unità di misura) modifica quadraticamente la loro varianza;
per ogni \(b \in \mathbb R\), \(\operatorname{Var}(b) = \operatorname{Var}(0 \cdot X + b) = 0\), e dunque le variabili aleatorie degeneri hanno varianza e deviazione standard nulla, come è naturale attendersi, perché l'unico valore osservabile coincide con il valore atteso.
Esempio 99 (Cambiare origine e cambiare scala)
Sia \(X\) la distanza, in metri, coperta da un balzo d'ombra di Silhouette, e supponiamo che \(\operatorname{Var}(X) = 9 \, \mathrm{m}^2\). Se un nuovo sensore misura la stessa distanza a partire da una piattaforma spostata di due metri, la variabile osservata diventa \(Y = X + 2\). In questo caso
Se invece vogliamo esprimere la stessa distanza in centimetri, dobbiamo porre \(Z = 100 X\), e allora
La dispersione fisica non è cambiata: è cambiata solo l'unità di misura, e per questo la varianza viene moltiplicata per il quadrato del fattore di conversione: nove metri quadrati corrispondono infatti a novantamila centimetri quadrati.
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


fig_affine, ax_affine = plt.subplots()
base_values_affine = np.array([3.0, 5.0, 6.0])
probabilities_affine = np.array([0.1, 0.7, 0.2])

stem_lines_affine = ax_affine.vlines(base_values_affine, 0, probabilities_affine)
point_markers_affine, = ax_affine.plot(base_values_affine, probabilities_affine,
                                       'o', color='C0')

ax_affine.set_xlabel(r'$x$')
ax_affine.set_ylabel(r'$p_{aX+b}$')
ax_affine.set_ylim(0, 1.05)
ax_affine.set_xlim(-20.5, 20.5)


def aggregate_pmf(values, probabilities):
  rounded_values = np.round(values, 10)
  order = np.argsort(rounded_values)
  sorted_values = rounded_values[order]
  sorted_probabilities = probabilities[order]

  aggregated_values = []
  aggregated_probabilities = []

  for value, probability in zip(sorted_values, sorted_probabilities):
    if aggregated_values and abs(value - aggregated_values[-1]) < 1e-9:
      aggregated_probabilities[-1] += probability
    else:
      aggregated_values.append(value)
      aggregated_probabilities.append(probability)

  return np.array(aggregated_values), np.array(aggregated_probabilities)


def render_affine_plot():
  a = float(page['#affine-a'][0].value)
  b = float(page['#affine-b'][0].value)

  transformed_values = a * base_values_affine + b
  plot_values, plot_probabilities = aggregate_pmf(transformed_values,
                                                  probabilities_affine)
  segments = [((value, 0), (value, probability))
              for value, probability in zip(plot_values, plot_probabilities)]

  stem_lines_affine.set_segments(segments)
  point_markers_affine.set_data(plot_values, plot_probabilities)

  page['#affine-a-value'][0].innerHTML = f'{a:.2f}'
  page['#affine-b-value'][0].innerHTML = f'{b:.2f}'

  display(fig_affine, target='graph-3', append=False)


@when('input', '#affine-a, #affine-b')
def update_affine_plot(event):
  render_affine_plot()


render_affine_plot()
Figura 46 Distribuzione iniziale delle Figure 43 e 45, trasformata nella distribuzione di \(a X + b\) al variare di \(a\) e \(b\). Quando \(a=1\) e \(b=0\), si recupera esattamente la funzione di massa di probabilità di \(X\).#
Corollario 6
Sia \(X\) una variabile aleatoria che ammette deviazione standard e siano \(a, b \in \mathbb R\). Allora
Dimostrazione.
Applicando il Teorema 28 si ottiene direttamente
Anche in questo caso, come conseguenza si otiene che la deviazione standard non viene influenzata da una traslazione; ora, però, l'effetto di un'eventuale riscalatura è quello di moltiplicare la deviazione standard per il corrispondente fattore di conversione: per ogni \(a \in \mathbb R\), \(\operatorname{SD}(a X) = \lvert a \rvert \operatorname{SD}(X)\).
Esempio 100
Riprendendo l'Esempio 99, avremo \(\operatorname{SD}(Y) = \operatorname{SD}(X) = 3 \, \mathrm{m}\) e \(\operatorname{SD}(Z) = 100 \operatorname{SD}(X) = 300 \, \mathrm{cm}\).
Varianza e deviazione standard sono spesso usate in parallelo: la prima perché è algebricamente più comoda da trattare e si combina molto bene con le trasformazioni e con le somme di variabili aleatorie; la seconda perché è più immediata da interpretare e da comunicare.
Nell'Esempio 88 abbiamo visto che è possibile centrare una variabile aleatoria, sottraendole il suo valore atteso. Applicando successivamente un'opportuna scalatura, si ottiene una trasformazione di particolare importanza per lo studio delle distribuzioni.
Definizione 36 (Standardizzazione di una variabile aleatoria)
Sia \(X\) una variabile aleatoria che ammette valore atteso \(\mu\) e varianza \(\sigma^2\). La variabile aleatoria
viene detta standardizzazione di \(X\).
Corollario 7
Sia \(X\) una variabile aleatoria che ammette varianza. La sua standardizzazione \(X'\) è tale che
Dimostrazione.
Sia \(\sigma^2\) la varianza di \(X\), e sia \(\mu\) il suo valore atteso, che deve necessariamente esistere perché esiste la varianza. Applicando il Teorema 26 si ottiene immediatamente
Analogamente, il Teorema 28 assicura che
In generale, si può studiare la dispersione di \(X\) attorno a un qualsiasi valore \(c \in \mathbb R\). Se si continuano a utilizzare gli scarti quadratici, ciò equivale a considerare il valore atteso \(\mathbb E\left((X-c)^2\right)\). La varianza, che corrisponde al caso particolare in cui \(c = \mathbb E(X)\), soddisfa una particolare proprietà. Infatti, posto \(\mu = \mathbb E(X)\), si ha ovviamente \(X - c = (X - \mu) + (\mu - c)\). Pertanto
poiché \(\mathbb E(X-\mu) = \mathbb E(X)-\mu = 0\). Siccome il termine \((\mu - c)^2\) è sempre non negativo, \(\mathbb E\left((X-c)^2\right) \geq \operatorname{Var}(X)\), e la quantità \(\mathbb E\left((X-c)^2\right)\) è minima esattamente quando \(c = \mathbb E(X)\). Questo risultato chiarisce un punto importante: il valore atteso non è soltanto un valore centrale naturale, ma è anche il riferimento che rende minima la dispersione misurata tramite gli scarti quadratici,come esemplificato nella Figura 47.
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


fig_c, ax_c = plt.subplots()
values_c = np.array([3.0, 5.0, 6.0])
probabilities_c = np.array([0.1, 0.7, 0.2])
initial_c = 5.0

stem_lines_c = ax_c.vlines(values_c, 0, probabilities_c)
point_markers_c, = ax_c.plot(values_c, probabilities_c, 'o', color='C0')
center_line_c = ax_c.axvline(initial_c, color='#cc6600', linestyle='--', linewidth=1.2)
arrow_levels_c = np.array([0.28, 0.5, 0.82])
distance_arrows_c = [
  FancyArrowPatch((value, level), (initial_c, level), arrowstyle='<->',
          mutation_scale=11, linewidth=1.0, color='#9aa3ad')
  for value, level in zip(values_c, arrow_levels_c)
]
for arrow in distance_arrows_c:
  ax_c.add_patch(arrow)
arrow_labels_c = [
  ax_c.text((value + initial_c) / 2, level + 0.02, '', ha='center',
        va='bottom', color='#7f8790')
  for value, level in zip(values_c, arrow_levels_c)
]
distance_labels_c = [
    ax_c.text(value, probability + 0.04, '', ha='center', va='bottom', color='#7f8790')
    for value, probability in zip(values_c, probabilities_c)
]

ax_c.set_xlabel(r'$x$')
ax_c.set_ylabel(r'$p_X$')
ax_c.set_xlim(1.5, 7.0)
ax_c.set_ylim(0, 1.0)


def render_c_plot():
  c = float(page['#center-c'][0].value)
  distances = values_c - c
  squared_distances = (values_c - c) ** 2
  expected_dispersion = np.dot(probabilities_c, squared_distances)

  center_line_c.set_xdata([c, c])

  for arrow, label, value, level, distance in zip(
      distance_arrows_c, arrow_labels_c, values_c, arrow_levels_c, distances):
    if abs(distance) < 1e-9:
      arrow.set_positions((c - 0.03, level), (c + 0.03, level))
      label.set_position((c, level + 0.02))
    else:
      arrow.set_positions((value, level), (c, level))
      label.set_position(((value + c) / 2, level + 0.02))
    label.set_text(f'${distance:.2f}$')


  page['#center-c-value'][0].innerHTML = f'{c:.2f}'

  ax_c.set_title(
      rf'$\mathbb{{E}}\left((X-{c:.2f})^2\right) = {expected_dispersion:.2f}$')

  display(fig_c, target='graph-4', append=False)


@when('input', '#center-c')
def update_c_plot(event):
  render_c_plot()


render_c_plot()
Figura 47 Distribuzione iniziale delle Figure 43 e 45, con un segmento verticale mobile che identifica il valore centrale \(c\). Spostando il selettore si aggiornano i valori dei singoli scarti e quello di \(\mathbb E((X-c)^2)\), mostrando come la dispersione quadratica attorno a \(c\) venga minimizzata quando \(c = \mathbb E(X)\).#
Naturalmente, lo scarto quadratico non è l'unico modo per misurare la dispersione attorno a un valore assegnato \(c\). Si possono considerare, per esempio:
lo scarto assoluto medio attorno a \(c\), dato da \(\mathbb E(\lvert X-c\rvert)\), che penalizza meno fortemente gli scarti molto grandi e conduce a proprietà di ottimalità diverse, legate alla mediana più che alla media[2];
gli scarti di ordine \(p\), della forma \(\mathbb E(\lvert X-c \rvert^p)\) per \(p > 0\), che generalizzano sia il caso assoluto (\(p=1\)) sia quello quadratico (\(p=2\)).
La scelta dell'indice dipende dunque dal tipo di applicazione e da quali scarti si desidera pesare maggiormente. La varianza resta però particolarmente importante perché combina una chiara interpretazione geometrica con particolari proprietà algebriche che vedremo nel seguito.
19.4.2. Quantili#
Un secondo modo di descrivere la dispersione di una variabile aleatoria non consiste nel misurarne gli scarti rispetto a un singolo valore centrale, ma nel guardare come la massa di probabilità si distribuisce lungo la retta reale. In quest'ottica entrano in gioco i quantili, che sono delle soglie capaci di suddividere la massa di probabilità in due parti ben definite.
Definizione 37 (Quantili di una variabile aleatoria discreta)
Sia \(X\) una variabile aleatoria discreta e sia \(q \in (0,1)\). Si dice quantile di livello \(q\) di \(X\) il valore
In altre parole, una volta fissato il livello, il quantile \(x_q\) permette di suddividere la massa di probabilità in due parti:
la prima è associata all'insieme \((-\infty, x_q]\), sul quale \(X\) assume probabilità almeno \(q\);
la seconda corrisponde a \((x_q, +\infty)\), in cui \(X\) assume probabilità al più \(1 - q\).
In particolare, la mediana (vedi Definizione 33) può essere vista come un quantile di livello \(0.5\), o, alternativamente, i quantili si possono pensare come a una generalizzazione del concetto di mediana.
Se \(F_X\) denota la funzione di ripartizione di \(X\), allora \(x_q\) è anche il più piccolo valore per cui \(F_X(x_q) \geq q\). Siccome siamo nel caso discreto, \(F_X\) è costante a tratti, e dunque cresce per salti. Di conseguenza, un quantile è il primo punto in cui la probabilità cumulata raggiunge oppure supera il livello richiesto. Tuttavia, una volta raggiunto \(x_q\), la disuguaglianza \(F_X(x) \geq q\) continua in generale a valere anche per tutti i valori successivi \(x \geq x_q\). È per questo che la Definizione 37 richiede di considerare il più piccolo tra essi, così da definire il quantile in modo univoco.
Esempio 101
Consideriamo la distribuzione illustrata in Figura 48, che fa riferimento a una variabile aleatoria \(X\) con supporto e funzione di massa di probabilità definiti nella tabella che segue.
\(x\) |
\(p_X(x)\) |
|---|---|
\(1\) |
\(0.2\) |
\(2\) |
\(0.3\) |
\(4\) |
\(0.3\) |
\(6\) |
\(0.2\) |
La Figura 48 mostra il grafico della funzione di massa di probabilità di \(X\), evidenziando come il quantile di livello \(0.5\) sia \(x_{0.5} = 2\). Infatti, \(F_X(2) = 0.2 + 0.3 = 0.5\), mentre per ogni \(x < 2\) si ha \(F_X(x) < 0.5\). Interagendo con il grafico, è possibile selezionare un qualsiasi punto sull'asse delle ascisse, visualizzando il corrispondente valore di \(F_X\) e marcando rispettivamente con ✓ e ✕ i casi nei quali il punto selezionato soddisfi oppure no la condizione alla base della Definizione 37. Agendo sul selettore nella figura, si vede che tutti e soli i punti \(x > 2\) soddisfano questa condizione, dunque il quantile deve essere il più piccolo tra essi, che è appunto \(2\).
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


support_jump_05 = np.array([1.0, 2.0, 4.0, 6.0])
support_jump_05_label = [f'{l:.0f}' for l in support_jump_05]
support_jump_05_label[1] = r'$x_{0.5} = 2$'
probabilities_jump_05 = np.array([0.2, 0.3, 0.3, 0.2])
cdf_jump_05 = np.cumsum(probabilities_jump_05)
right_endpoints_jump_05 = np.append(support_jump_05[1:], support_jump_05[-1] + 1)
ytick_labels_jump_05 = [f'{value:.1f}' for value in cdf_jump_05]
fixed_level_jump_05 = 0.5
quantile_index_jump_05 = int(np.searchsorted(cdf_jump_05, fixed_level_jump_05, side='left'))
quantile_jump_05 = support_jump_05[quantile_index_jump_05]
previous_cdf_jump_05 = 0.0 if quantile_index_jump_05 == 0 else cdf_jump_05[quantile_index_jump_05 - 1]

fig_jump_05, ax_jump_05 = plt.subplots()
ax_jump_05.hlines(
  np.concatenate(([0.0], cdf_jump_05)),
  np.concatenate(([0.5], support_jump_05)),
  np.concatenate(([1.0], right_endpoints_jump_05)),
  color='#006699', linewidth=1)
highlight_plateau_jump_05 = ax_jump_05.hlines(
  cdf_jump_05[quantile_index_jump_05], quantile_jump_05, right_endpoints_jump_05[quantile_index_jump_05],
  color='#cc6600', linewidth=1)
ax_jump_05.plot(support_jump_05, cdf_jump_05, linestyle='None', marker='o',
                color='#006699', zorder=3)
ax_jump_05.plot(np.concatenate(([support_jump_05[0]], right_endpoints_jump_05[:-1])),
                np.concatenate(([0.0], cdf_jump_05[:-1])),
                linestyle='None', marker='o', markerfacecolor='white',
                markeredgecolor='#006699', markeredgewidth=0.8, zorder=3)
lower_quantile_marker_jump_05, = ax_jump_05.plot(
  [quantile_jump_05], [previous_cdf_jump_05], linestyle='None', marker='o',
  markerfacecolor='white', markeredgecolor='#cc6600',
  markeredgewidth=0.8, zorder=4)
upper_quantile_marker_jump_05, = ax_jump_05.plot(
  [quantile_jump_05], [cdf_jump_05[quantile_index_jump_05]], linestyle='None', marker='o',
  color='#cc6600', zorder=5)
level_line_jump_05, = ax_jump_05.plot(
  [0.5, 7.1], [fixed_level_jump_05, fixed_level_jump_05], color='#cc6600',
  linestyle='--', linewidth=.8)
quantile_line_jump_05, = ax_jump_05.plot(
  [quantile_jump_05, quantile_jump_05], [-0.02, 1.05], color='#cc6600',
  linestyle='--', linewidth=.8)
probe_line_jump_05, = ax_jump_05.plot(
  [quantile_jump_05, quantile_jump_05], [0.0, cdf_jump_05[quantile_index_jump_05]], color='#2a7f62',
  linestyle='--', linewidth=.9)
probe_marker_jump_05, = ax_jump_05.plot(
  [quantile_jump_05], [cdf_jump_05[quantile_index_jump_05]], linestyle='None', marker='o',
  color='#2a7f62', zorder=5)

ax_jump_05.set_xticks(support_jump_05)
ax_jump_05.set_xticklabels(support_jump_05_label)
ax_jump_05.set_yticks(np.concatenate(([0.0], cdf_jump_05)))
ax_jump_05.set_yticklabels(['0.0'] + ytick_labels_jump_05)
ax_jump_05.set_xlim(0.5, 7.1)
ax_jump_05.set_ylim(-0.02, 1.05)
ax_jump_05.set_xlabel(r'$x$')
ax_jump_05.set_ylabel(r'$F_X(x)$')
ax_jump_05.grid(axis='y', alpha=0.15)


def cdf_at_point_jump_05(x_value):
  index = np.searchsorted(support_jump_05, x_value, side='right') - 1
  if index < 0:
    return 0.0
  return cdf_jump_05[index]


def render_jump_quantile_plot_05():
  x_value = float(page['#quantile-probe-x-05'][0].value)
  cdf_value = cdf_at_point_jump_05(x_value)

  cdf_status = '✓' if cdf_value >= fixed_level_jump_05 else '✕'

  highlight_plateau_jump_05.set_segments(
    [[(quantile_jump_05, fixed_level_jump_05),
      (right_endpoints_jump_05[quantile_index_jump_05], fixed_level_jump_05)]])
  probe_line_jump_05.set_data([x_value, x_value], [0.0, cdf_value])
  probe_marker_jump_05.set_data([x_value], [cdf_value])
  lower_quantile_marker_jump_05.set_data([quantile_jump_05], [previous_cdf_jump_05])
  upper_quantile_marker_jump_05.set_data([quantile_jump_05], [fixed_level_jump_05])
  level_line_jump_05.set_data([0.5, 7.1], [fixed_level_jump_05, fixed_level_jump_05])
  quantile_line_jump_05.set_data([quantile_jump_05, quantile_jump_05], [-0.02, 1.05])

  page['#quantile-probe-x-value-05'][0].innerHTML = f'{x_value:.2f}'
  page['#quantile-probe-cdf-value-05'][0].innerHTML = f'{cdf_value:.2f}'
  page['#quantile-probe-cdf-status-05'][0].innerHTML = cdf_status

  display(fig_jump_05, target='graph-5', append=False)


@when('input', '#quantile-probe-x-05')
def update_jump_quantile_plot_05(event):
  render_jump_quantile_plot_05()


render_jump_quantile_plot_05()
Figura 48 Funzione di ripartizione della variabile aleatoria descritta nell'Esempio 101, evidenziando il quantile \(x_{0.5}\). Il selettore permette di considerare un qualunque punto \(x\) sull'asse delle ascisse, mostrando il valore di \(\mathbb P(X \leq x)\) ed evidenziando quando questo soddisfa la condizione alla base della Definizione 37.#
Nell'esempio precedente, il valore della funzione di ripartizione calcolato sul quantile selezionato è esattamente uguale al livello: ciò è dovuto al fatto che, passando dal punto di massa \(x = 1\) a quello appena successivo, \(F_X\) aumenta da \(0.2\) a \(0.5\), che è esattamente il livello richiesto. Siccome in una variabile discreta la ripartizione aumenta «per salti», questo comportamento non è assolutamente garantito, come evidenziato nel seguente esempio.
Esempio 102
La Figura 49 mostra la stessa distribuzione dell'Esempio 101, concentrandosi sul quantile \(x_{0.6}\). In questo caso, passando da \(x = 2\) a \(x = 4\), \(F_X\) aumenta da \(0.5\) a \(0.8\). Pertanto, \(x_{0.6} = 4\), ma \(F_X(x_{0.6}) \neq 0.6\).
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


support_jump_06 = np.array([1.0, 2.0, 4.0, 6.0])
support_jump_06_label = [f'{l:.0f}' for l in support_jump_06]
support_jump_06_label[2] = r'$x_{0.6} = 4$'
probabilities_jump_06 = np.array([0.2, 0.3, 0.3, 0.2])
cdf_jump_06 = np.cumsum(probabilities_jump_06)
right_endpoints_jump_06 = np.append(support_jump_06[1:], support_jump_06[-1] + 1)
ytick_labels_jump_06 = [f'{value:.1f}' for value in cdf_jump_06]
fixed_level_jump_06 = 0.6
quantile_index_jump_06 = int(np.searchsorted(cdf_jump_06, fixed_level_jump_06, side='left'))
quantile_jump_06 = support_jump_06[quantile_index_jump_06]
previous_cdf_jump_06 = 0.0 if quantile_index_jump_06 == 0 else cdf_jump_06[quantile_index_jump_06 - 1]

fig_jump_06, ax_jump_06 = plt.subplots()
ax_jump_06.hlines(
  np.concatenate(([0.0], cdf_jump_06)),
  np.concatenate(([0.5], support_jump_06)),
  np.concatenate(([1.0], right_endpoints_jump_06)),
  color='#006699', linewidth=1)
highlight_plateau_jump_06 = ax_jump_06.hlines(
  cdf_jump_06[quantile_index_jump_06], quantile_jump_06, right_endpoints_jump_06[quantile_index_jump_06],
  color='#cc6600', linewidth=1)
ax_jump_06.plot(support_jump_06, cdf_jump_06, linestyle='None', marker='o',
                color='#006699', zorder=3)
ax_jump_06.plot(np.concatenate(([support_jump_06[0]], right_endpoints_jump_06[:-1])),
                np.concatenate(([0.0], cdf_jump_06[:-1])),
                linestyle='None', marker='o', markerfacecolor='white',
                markeredgecolor='#006699', markeredgewidth=0.8, zorder=3)
lower_quantile_marker_jump_06, = ax_jump_06.plot(
  [quantile_jump_06], [previous_cdf_jump_06], linestyle='None', marker='o',
  markerfacecolor='white', markeredgecolor='#cc6600',
  markeredgewidth=0.8, zorder=4)
upper_quantile_marker_jump_06, = ax_jump_06.plot(
  [quantile_jump_06], [cdf_jump_06[quantile_index_jump_06]], linestyle='None', marker='o',
  color='#cc6600', zorder=5)
level_line_jump_06, = ax_jump_06.plot(
  [0.5, 7.1], [fixed_level_jump_06, fixed_level_jump_06], color='#cc6600',
  linestyle='--', linewidth=.8)
quantile_line_jump_06, = ax_jump_06.plot(
  [quantile_jump_06, quantile_jump_06], [-0.02, 1.05], color='#cc6600',
  linestyle='--', linewidth=.8)
probe_line_jump_06, = ax_jump_06.plot(
  [quantile_jump_06, quantile_jump_06], [0.0, cdf_jump_06[quantile_index_jump_06]], color='#2a7f62',
  linestyle='--', linewidth=.9)
probe_marker_jump_06, = ax_jump_06.plot(
  [quantile_jump_06], [cdf_jump_06[quantile_index_jump_06]], linestyle='None', marker='o',
  color='#2a7f62', zorder=5)

ax_jump_06.set_xticks(support_jump_06)
ax_jump_06.set_yticks(np.concatenate(([0.0], cdf_jump_06)))
ax_jump_06.set_yticklabels(['0.0'] + ytick_labels_jump_06)
ax_jump_06.set_xlim(0.5, 7.1)
ax_jump_06.set_ylim(-0.02, 1.05)
ax_jump_06.set_xlabel(r'$x$')
ax_jump_06.set_ylabel(r'$F_X(x)$')
ax_jump_06.grid(axis='y', alpha=0.15)


def cdf_at_point_jump_06(x_value):
  index = np.searchsorted(support_jump_06, x_value, side='right') - 1
  if index < 0:
    return 0.0
  return cdf_jump_06[index]


def render_jump_quantile_plot_06():
  x_value = float(page['#quantile-probe-x-06'][0].value)
  cdf_value = cdf_at_point_jump_06(x_value)

  cdf_status = '✓' if cdf_value >= fixed_level_jump_06 else '✕'

  highlight_plateau_jump_06.set_segments(
    [[(quantile_jump_06, cdf_jump_06[quantile_index_jump_06]),
      (right_endpoints_jump_06[quantile_index_jump_06], cdf_jump_06[quantile_index_jump_06])]])
  probe_line_jump_06.set_data([x_value, x_value], [0.0, cdf_value])
  probe_marker_jump_06.set_data([x_value], [cdf_value])
  lower_quantile_marker_jump_06.set_data([quantile_jump_06], [previous_cdf_jump_06])
  upper_quantile_marker_jump_06.set_data([quantile_jump_06], [cdf_jump_06[quantile_index_jump_06]])
  level_line_jump_06.set_data([0.5, 7.1], [fixed_level_jump_06, fixed_level_jump_06])
  quantile_line_jump_06.set_data([quantile_jump_06, quantile_jump_06], [-0.02, 1.05])

  page['#quantile-probe-x-value-06'][0].innerHTML = f'{x_value:.2f}'
  page['#quantile-probe-cdf-value-06'][0].innerHTML = f'{cdf_value:.2f}'
  page['#quantile-probe-cdf-status-06'][0].innerHTML = cdf_status

  display(fig_jump_06, target='graph-6', append=False)


@when('input', '#quantile-probe-x-06')
def update_jump_quantile_plot_06(event):
  render_jump_quantile_plot_06()


render_jump_quantile_plot_06()
Figura 49 Funzione di ripartizione della variabile aleatoria descritta nell'Esempio 102, evidenziando il quantile \(x_{0.6}\). Stessa notazione della Figura 48.#
Esempio 103
Consideriamo la variabile aleatoria \(X\) che descrive il risultato del lancio di un dado bilanciato a sei facce. Per ogni \(k \in \{1,\dots,6\}\) si ha \(\mathbb P(X = x) = \tfrac{1}{6}\), e quindi \(F_X(x) = \tfrac{\lfloor x \rfloor}{6}\) ogni volta che \(1 \leq x \leq 6\). Ora, affinché un valore \(x\) sia candidato a essere il quantile di \(X\) di un generico livello \(q\), deve valere \(F_X(x) \geq q\), ovvero \(\lfloor x \rfloor \geq 6 q\). Pertanto,
Per esempio, il quantile di livello \(0.25\) è \(x_{0.25} = \lceil \tfrac{6}{4} \rceil = 2\), e la mediana è \(m = \lceil \tfrac{6}{2} \rceil = 3\). La Figura 50 visualizza il grafico di \(F_X\) e permette di evidenziare i quantili di \(X\) in modo interattivo: selezionando il livello \(q\), la figura viene rigenerata evidenziando \(x_q\).
from fractions import Fraction
import matplotlib.pyplot as plt
import numpy as np
from pyscript import display
from pyscript.web import page, when


v = np.arange(1, 7)
p = np.full(6, 1 / 6)
cdf_values = np.cumsum(p)
right_endpoints = np.append(v[1:], v[-1] + 1)
ticks = cdf_values
tick_labels = [str(Fraction(tick).limit_denominator(36)) for tick in ticks]

fig_quantile, ax_quantile = plt.subplots()
base_plateaus = ax_quantile.hlines(np.concatenate(([0], cdf_values)),
                                   np.concatenate(([0.5], v)),
                                   np.concatenate(([1.0], right_endpoints)),
                                   color='#006699', linewidth=2.2)
highlight_plateau = ax_quantile.hlines(cdf_values[0], v[0], v[1],
                                       color='#cc6600', linewidth=3.2)
closed_markers, = ax_quantile.plot(v, cdf_values, linestyle='None', marker='o',
                                   color='#006699', zorder=3)
open_markers, = ax_quantile.plot(np.concatenate(([v[0]], right_endpoints[:-1])),
                                 np.concatenate(([0.0], cdf_values[:-1])),
                                 linestyle='None', marker='o',
                                 markerfacecolor='white',
                                 markeredgecolor='#006699',
                                 markeredgewidth=0.8, zorder=3)
lower_quantile_marker, = ax_quantile.plot([v[0]], [0.0], linestyle='None',
                                          marker='o', markerfacecolor='white',
                                          markeredgecolor='#cc6600',
                                          markeredgewidth=0.8,                zorder=4)
upper_quantile_marker, = ax_quantile.plot([v[0]], [cdf_values[0]],
                                          linestyle='None', marker='o',
                                          color='#cc6600',
                                          zorder=5)
level_line, = ax_quantile.plot([0.5, 7.1], [cdf_values[0], cdf_values[0]],
                               color='#cc6600', linestyle='--', linewidth=.8)
quantile_line, = ax_quantile.plot([v[0], v[0]], [-0.02, 1.05],
                                  color='#cc6600', linestyle='--',
                                  linewidth=.8)

ax_quantile.set_xticks(v)
ax_quantile.set_yticks(np.concatenate(([0], ticks)))
ax_quantile.set_yticklabels(['0'] + tick_labels)
ax_quantile.set_xlim(0.5, 7.1)
ax_quantile.set_ylim(-0.02, 1.05)
ax_quantile.set_xlabel(r'$x$')
ax_quantile.set_ylabel(r'$F_X$')
ax_quantile.grid(axis='y', alpha=0.15)


def render_quantile_plot():
  level = float(page['#quantile-level'][0].value)
  quantile_index = int(np.searchsorted(cdf_values, level, side='left'))
  quantile = int(v[quantile_index])
  cdf_at_quantile = cdf_values[quantile_index]
  previous_cdf = 0.0 if quantile_index == 0 else cdf_values[quantile_index - 1]

  highlight_plateau.set_segments([[(quantile, cdf_at_quantile),
                                   (quantile + 1, cdf_at_quantile)]])
  lower_quantile_marker.set_data([quantile], [previous_cdf])
  upper_quantile_marker.set_data([quantile], [cdf_at_quantile])
  level_line.set_data([0.5, 7.1], [level, level])
  quantile_line.set_data([quantile, quantile], [-0.02, 1.05])

  page['#quantile-level-value'][0].innerHTML = f'{level:.2f}'
  page['#quantile-x-value'][0].innerHTML = f'{quantile}'

  display(fig_quantile, target='graph-7', append=False)


@when('input', '#quantile-level')
def update_quantile_plot(event):
  render_quantile_plot()


render_quantile_plot()
Figura 50 Quantili della distribuzione di una variabile aleatoria che descrive il valore ottenuto lanciando un dado bilanciato a sei facce.#
Chiaramente, i quantili di una distribuzione hanno in comune non solo il nome, ma anche un significato analogo a quello dell'omonimo concetto incontrato nell'ambito della statistica descrittiva. L'idea di fondo è la stessa: individuare soglie che separino la massa totale in porzioni assegnate. Nel caso della statistica descrittiva, la «massa» è costituita dalle osservazioni nel campione, ognuna avente lo stesso peso. Qui, invece, si fa riferimento direttamente alla massa di probabilità della variabile aleatoria. Anche in questo caso, quindi, è possibile considerare delle granularità differenti per descrivere la distribuzione:se la si suddivide in quattro parti di uguale probabilità si ottengono i quartili; se la si ripartisce in dieci o in cento parti si parla rispettivamente di decili e di percentili. Nel caso discreto, questa suddivisione va intesa nel senso già chiarito sopra: il quantile (o quartile, e via discorrendo) cercato è sempre il più piccolo valore per cui la probabilità cumulata raggiunge o supera il livello fissato.
19.4.3. Altre misure di dispersione#
Varianza e deviazione standard misurano la dispersione traducendola in termini di distanza rispetto a un valore centrale, tipicamente il valore atteso. Esistono però anche altri indici che adottano un punto di vista diverso: anziché misurare direttamente gli scarti da un centro, descrivono quanto la distribuzione sia ampia o quanto risultino distanti tra loro sue porzioni significative.
Definizione 38 (Range)
Sia \(X\) una variabile aleatoria discreta con supporto \(S_X\). Il range (o intervallo di variazione) di \(X\) è definito come
quando entrambi gli estremi sono finiti, ed è indefinito altrimenti.
Esempio 104
Le variabili aleatorie descritte negli Esempi 101, 102 e 103 hanno tutte range uguale a cinque, perchè il loro supporto ammette minimo e massimo, rispettivamente uguali a sei e a uno.
Invece, la variabile aleatoria dell'Esempio 70 ha \(\mathbb N\) come supporto, il cui estremo superiore è infinito. Pertanto, il range di questa variabile non è definito.
Se una variabile aleatoria ha supporto finito, allora è sempre possibile calcolare il suo range; d'altro canto, non è necessariamente vero che il range non sia definito quando il supporto è infinito, come mostrato nell'esempio che segue.
Esempio 105
Consideriamo una variabile aleatoria discreta \(X\) con supporto \(S_X = \left\{ \tfrac{1}{n} : n \in \mathbb{N} \right\}\). Questo insieme ha \(1\) come elemento massimo, non ammette un valore minimo, ma ha estremo inferiore pari a zero. Pertanto, \(\inf S_X = 0\), \(\sup S_X = 1\) e il range di \(X\) è uguale a \(1\).
Il range tiene conto soltanto dei due valori estremi che la variabile può assumere. Per questo motivo è molto immediato da interpretare, ma risulta anche piuttosto sensibile a eventuali valori estremi rari, e soprattutto trascura il modo in cui la probabilità è distribuita all'interno del supporto stesso. Un'alternativa più robusta si ottiene sfruttando i quantili.
Definizione 39 (Distanza interquartile)
La distanza interquartile di una variabile aleatoria \(X\) è definita come \(x_{0.75} - x_{0.25}\), dove \(x_{0.25}\) e \(x_{0.75}\) indicano rispettivamente il primo e il terzo quartile della distribuzione di \(X\).
La distanza interquartile misura l'ampiezza dell'intervallo che contiene almeno la metà centrale della massa di probabilità e costituisce dunque una misura di dispersione alternativa alla varianza e alla deviazione standard. Rispetto a queste ultime, è meno influenzata dalle code della distribuzione (cioè dalle sue parti più esterne) e descrive più specificamente la dispersione della sua parte centrale; d'altra parte, fornisce una descrizione meno completa della distribuzione, poiché dipende soltanto dal primo e dal terzo quartile e non tiene conto direttamente di come la massa di probabilità sia distribuita al loro interno, o al di fuori di essi. Lo stesso principio può essere applicato con granularità diverse, considerando la distanza tra coppie di quantili simmetrici rispetto alla mediana. Per esempio, oltre alla distanza interquartile si può considerare la distanza tra il primo e il nono decile, o più in generale tra due percentili opportunamente scelti, ottenendo misure dell'ampiezza di porzioni centrali più o meno estese della distribuzione. In questo senso, il range e la distanza interquartile sono due casi particolarmente importanti di una famiglia più ampia di misure di dispersione che non fanno riferimento allo scostamento da un singolo valore centrale.
Proprio come per la statistica descrittiva, i quartili possono essere usati per visualizzare graficamente una distribuzione, tracciandone un box plot. Sebbene questo tipo di grafico sia utilizzato poco frequentemente, permette di dare una descrizione di alcuni aspetti fondamentali di una variabile aleatoria \(X\): la centralità, espressa dalla mediana, e la dispersione, indicata dalla distanza interquartile e dal range. Quando \(S_X\) è finito, il box plot si costruisce in modo molto simile a quanto abbiamo già visto: la scatola è delimitata dal primo e dal terzo quartile, i baffi dagli estremi della distribuzione e la mediana è posizionata nella scatola. C'è però una differenza fondamentale: in genere non si utilizza l'euristica di Tukey per individuare valori fuori scala.
Esempio 106
Consideriamo la variabile aleatoria \(X\) che indica l'esito del lancio di un dato bilanciato a sei facce, già discussa nell'Esempio 103. In questo caso, il minimo è \(1\) e il massimo è \(6\). Inoltre, per (19.12),
Il corrispondente diagramma a scatola ha dunque i baffi che si estendono fino a \(1\) a sinistra e fino a \(6\) a destra, la scatola compresa tra \(2\) e \(5\), e il segmento della mediana posizionato in \(3\), come mostrato in Figura 51. La distanza interquartile vale \(x_{0.75} - x_{0.25} = 3\), mentre il range è uguale a \(6-1 = 5\).
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(4, 1))

minimum = 1
first_quartile = 2
median = 3
third_quartile = 5
maximum = 6

stats = [{
    "label": "",
    "q1": first_quartile,
    "med": median,
    "q3": third_quartile,
    "whislo": minimum,
    "whishi": maximum,
    "fliers": [],
}]

ax.bxp(stats, orientation='horizontal', widths=0.5)

for x_value, y_value, text in [(minimum, 0.5, minimum),
                               (first_quartile, 1.35, first_quartile),
                               (median, 0.5, median),
                               (third_quartile, 1.35, third_quartile),
                               (maximum, 0.5, maximum)]:
  ax.text(x_value, y_value, text, ha='center')

ax.set_xlim(0, 10)
ax.axis('off')
plt.show()
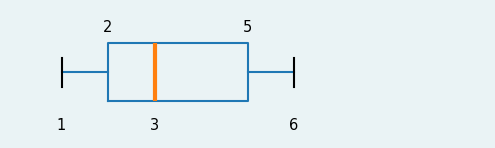
Figura 51 Box plot della distribuzione descritta nell'Esempio 106.#
Esempio 107
Riconsideriamo la variabile aleatoria \(Y\) introdotta nell'Esempio 93, con \(S_Y = \{1, 5, 7 \}\). La sua funzione di ripartizione è tale che \(F_Y(1) = 0.1\), \(F_Y(5) = 0.8\) e \(F_Y(7) = 1\), pertanto \(5\) è al contempo primo quartile, mediana e terzo quartile. Come evidenziato in Figura 52, la scatola del box plot della distribuzione di \(Y\) si riduce quindi a un segmento in corrispondenza di \(y = 5\). Ciò rende visibile in modo molto netto il fatto che la massa di probabilità centrale è tutta raccolta attorno a un singolo valore, pur in presenza di una dispersione complessiva non trascurabile, come mostrano i due baffi che si estendono da \(1\) a \(7\).
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(4, 1))

minimum = 1
first_quartile = 5
median = 5
third_quartile = 5
maximum = 7

stats = [{
    "label": "",
    "q1": first_quartile,
    "med": median,
    "q3": third_quartile,
    "whislo": minimum,
    "whishi": maximum,
    "fliers": [],
}]

ax.bxp(stats, orientation='horizontal', widths=0.5)

for x_value, y_value, text in [(minimum, 0.5, minimum),
                               (first_quartile, 1.35, first_quartile),
                               (median, 0.5, median),
                               (third_quartile, 1.35, third_quartile),
                               (maximum, 0.5, maximum)]:
  ax.text(x_value, y_value, text, ha='center')

ax.set_xlim(0, 10)
ax.axis('off')
plt.show()
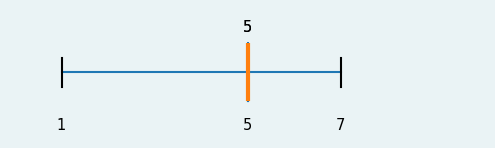
Figura 52 Box plot della variabile aleatoria \(Y\) dell'Esempio 93.#
Esempio 108
La variabile aleatoria \(X\) descritta nell'Esempio 73, caratterizzata dalla funzione di massa di probabilità
ammette una forma relativamente semplice per la funzione di ripartizione. Dato \(x \geq 0\), infatti, per (A.5) si ha
Pertanto, fissato \(q\in(0,1)\), il quantile corrispondente è definito da
e i primi tre quartili hanno la forma seguente:
Riassumendo, \(X\) ha mediana \(m_X = 3\) e distanza interquartile pari a cinque. Il suo valore minimo è zero, mentre non esiste un valore massimo, poiché il supporto è illimitato superiormente, e questo rende indefinito il range. È comunque possibile disegnare una forma generalizzata di box plot, mostrata nella Figura 53, in cui il baffo destro viene parzialmente tratteggiato, a significare che si estende indefinitamente verso \(+\infty\). Questa rappresentazione, oltre a visualizzare l'informazione relativa alla centralità e alla dispersione veicolata dalla mediana e dalla distanza interquartile, evidenzia un aspetto importante della distribuzione: la massa di probabilità che si trova prima della mediana è collocata in \([0, 3)\), mentre quella rimanente è contenuta in \([3, +\infty)\). Queste due masse sono approssimativamente uguali (ammontano rispettivamente al \(49\%\) e al \(51\%\)), dunque la massa di probabilità si dispone in modo diverso a sinistra e a destra rispetto al suo valore centrale, rendendo la distribuzione di \(X\) asimmetrica. Questo aspetto verrà approfondito nel prossimo paragrafo.
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(4, 1))

minimum = 0
first_quartile = 1
median = 3
third_quartile = 6
right_whisker_solid_end = 7
right_whisker_dashed_end = 8.5

stats = [{
    "label": "",
    "q1": first_quartile,
    "med": median,
    "q3": third_quartile,
    "whislo": minimum,
    "whishi": right_whisker_solid_end,
    "fliers": [],
}]

box = ax.bxp(stats, orientation='horizontal', widths=0.5)

box['caps'][1].set_visible(False)
right_whisker = box['whiskers'][1]
ax.plot([right_whisker_solid_end, right_whisker_dashed_end], [1, 1],
        color=right_whisker.get_color(),
        linewidth=right_whisker.get_linewidth(),
        linestyle='--')

for x_value, y_value, text in [(minimum, 0.5, minimum),
                               (first_quartile, 1.35, first_quartile),
                               (median, 0.5, median),
                               (third_quartile, 1.35, third_quartile)]:
  ax.text(x_value, y_value, text, ha='center')

ax.set_xlim(-1, 9)
ax.axis('off')
plt.show()
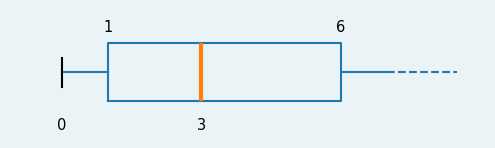
Figura 53 Box plot generalizzato della distribuzione descritta nell'Esempio 108.#
Accanto a questi indici, esistono naturalmente anche altre misure di dispersione che non discuteremo in dettaglio qui. Come gia accennato, alcune si basano su quantili diversi dai quartili; altre confrontano direttamente le distanze tra coppie di valori possibili della distribuzione. L'idea comune, però, rimane sempre la stessa: valutare quanto i valori di una variabile aleatoria risultino sparsi, senza necessariamente riferirsi agli scarti rispetto a un valore centrale.
19.4.4. Vero o falso?#
Analizzate ciascuna delle seguenti affermazioni, che riguardano una variabile aleatoria discreta \(X\) che ammette varianza, e dite se è vera o falsa, motivando il vostro ragionamento. Cliccate su di essa per visualizzare la risposta corretta.
Se \(X\) assume valori negativi, allora anche \(\operatorname{Var}(X)\) è negativa.
Falsa. La Definizione 35 definisce la varianza come il valore atteso dello scarto quadratico \((X - \mu)^2\), che è una quantità non negativa: la varianza non può quindi essere negativa, quale che sia il segno dei valori di \(X\). È proprio per evitare la compensazione tra scarti positivi e negativi, che rende \(\mathbb E(X - \mu)\) sempre nullo, che gli scarti vengono elevati al quadrato.
La deviazione standard è espressa nella stessa unità di misura dei valori di \(X\), mentre la varianza no.
Vera. Elevando al quadrato gli scarti si eleva al quadrato anche la loro unità di misura: se \(X\) indica dei millilitri, \(\operatorname{Var}(X)\) è misurata in \(\mathrm{mL}^2\). La deviazione standard, essendo la radice quadrata della varianza, risulta espressa nell'unità di misura di \(X\), e per questo risulta generalmente più immediata da interpretare, come osservato nell'Esempio 95.
Se \(X\) ammette varianza, allora \(\mathbb E(X^2) \geq \mathbb E(X)^2\).
Vera. Per il Teorema 27 la differenza tra i due membri è esattamente \(\operatorname{Var}(X)\), che non è mai negativa. Le due quantità coincidono quindi soltanto quando la varianza è nulla.
Sommare una costante \(b\) a una variabile aleatoria \(X\) non cambia la varianza, ma ne cambia la deviazione standard.
Falsa. Ponendo \(a = 1\) nel Teorema 28 si ottiene \(\operatorname{Var}(X + b) = \operatorname{Var}(X)\), dunque effettivamente la varianza rimane la stessa. Però la deviazione standard è la radice quadrata della varianza: se non cambia la prima, non cambia nemmeno la seconda.
Per ogni \(a \in \mathbb R\) vale \(\operatorname{SD}(a X) = a \operatorname{SD}(X)\).
Falsa. Il Corollario 6 stabilisce che il fattore deve essere il valore assoluto di \(a\): \(\operatorname{SD}(aX + b) = \lvert a \rvert \operatorname{SD}(X)\). Per \(a = -3\), per esempio, si ottiene \(\operatorname{SD}(-3X) = 3 \operatorname{SD}(X)\), mentre l'affermazione darebbe una deviazione standard negativa, che non può esistere per definizione, essendo la radice quadrata della varianza.
La varianza di una variabile indicatrice \(I_A\) è tanto più grande quanto più l'evento \(A\) è probabile.
Falsa. Nell'Esempio 97 si ricava \(\operatorname{Var}(I_A) = p(1-p)\), con \(p = \mathbb P(A)\): la varianza aumenta man mano che ci si avvicina a un evento di probabilità \(p = 0.5\), al contrario, quando l'evento tende a diventare molto probabile (o molto improbabile), la varianza diminuisce e si avvicina a zero.
Tra tutti i valori \(c \in \mathbb R\), quello che rende minima la quantità \(\mathbb E\left((X-c)^2\right)\) è la mediana di \(X\).
Falsa. Posto \(\mu = \mathbb E(X)\), si ottiene l'identità \(\mathbb E\left((X-c)^2\right) = \operatorname{Var}(X) + (\mu-c)^2\), in cui il termine \((\mu-c)^2\) è non negativo e si annulla soltanto per \(c = \mu\): il minimo si raggiunge dunque nel valore atteso ed è pari alla varianza. È invece lo scarto assoluto medio \(\mathbb E(\lvert X-c \rvert)\) a essere minimizzato dalla mediana.
Nel caso discreto, il quantile di livello \(q\) soddisfa sempre \(F_X(x_q) = q\).
Falsa. La funzione di ripartizione di una variabile aleatoria discreta cresce «per salti», quindi il livello richiesto può venire superato e non raggiunto esattamente: la Definizione 37 chiede infatti \(\mathbb P(X \leq x) \geq q\). L'Esempio 102 mostra proprio un caso di questo tipo, in cui \(x_{0.6} = 4\) ma \(F_X(x_{0.6}) = 0.8\).
La mediana di \(X\) coincide con il suo quantile di livello \(0.5\).
Vera. La Definizione 37 individua il più piccolo valore in cui la probabilità cumulata raggiunge il livello fissato; per \(q = 0.5\) si ritrova la Definizione 33. I quantili si possono quindi leggere come una generalizzazione della mediana.
Se il supporto di \(X\) è infinito, il range di \(X\) non è definito.
Falsa. La Definizione 38 richiede che \(\inf S_X\) e \(\sup S_X\) siano entrambi finiti, e questo può accadere anche con un supporto infinito: per \(S_X = \left\{ \tfrac{1}{n} : n \in \mathbb{N} \right\}\) si ha \(\inf S_X = 0\) e \(\sup S_X = 1\), quindi il range è uguale a \(1\). Il range non è invece definito, per esempio, per la variabile aleatoria dell'Esempio 70, il cui supporto è \(\mathbb N\).
La distanza interquartile è meno influenzata dalle code della distribuzione rispetto alla deviazione standard.
Vera. La Definizione 39 dipende soltanto dal primo e dal terzo quartile, quindi misura l'ampiezza della metà centrale della massa di probabilità e ignora come questa sia distribuita agli estremi. Per lo stesso motivo, però, descrive la distribuzione in modo meno completo della deviazione standard.
Quando si traccia il box plot di una variabile aleatoria, si evidenziano sempre i valori fuori scala.
Falsa. In linea di principio, proprio come nella statistica descrittiva, è possibile sia evidenziare gli outlier applicando la regola euristica di Tukey, oppure scegliere di non farlo, estendendo i baffi fino agli estremi della distribuzione. Normalmente, si utilizza questa seconda modalità.
19.4.5. Esercizi#
Esercizio 166 (•)
Quando Flatman si appiattisce per infilarsi sotto una porta, il suo spessore \(T\), misurato in millimetri, è una variabile aleatoria con supporto \(S_T = \{1, 2, 3\}\) e funzione di massa di probabilità
Calcolate la varianza di \(T\) applicando la Definizione 35.
Ricalcolate la varianza usando (19.11) e verificate di ottenere lo stesso risultato del punto precedente.
Calcolate la deviazione standard di \(T\) e indicate in quale unità di misura è espressa questa quantità.
Solution to Esercizio 166 (•)
Siccome \(\mathbb E(T) = 1 \cdot 0.2 + 2 \cdot 0.5 + 3 \cdot 0.3 = 2.1\), si ha
\[\operatorname{Var}(T) = (1-2.1)^2 \cdot 0.2 + (2-2.1)^2 \cdot 0.5 + (3-2.1)^2 \cdot 0.3 = 0.49 \enspace.\]Si ha \(\mathbb E(T^2) = 1 \cdot 0.2 + 4 \cdot 0.5 + 9 \cdot 0.3 = 4.9\), da cui \(\operatorname{Var}(T) = 4.9 - 2.1^2 = 0.49\), in accordo con il punto precedente.
La deviazione standard è \(\operatorname{SD}(T) = \sqrt{0.49} = 0.7\), ed è espressa in millimetri, come \(T\).
Esercizio 167 (••)
Sia \(X\) una variabile aleatoria che ammette valore atteso \(\mu\) e varianza \(\sigma^2 > 0\), e sia \(Y = a X + b\), con \(a, b \in \mathbb R\).
Esprimete \(\mathbb E(Y)\) e \(\operatorname{Var}(Y)\) in funzione di \(\mu\), \(\sigma^2\), \(a\) e \(b\).
Determinate \(a\) e \(b\) in modo che \(\mathbb E(Y) = 0\) e \(\operatorname{Var}(Y) = 1\).
Solution to Esercizio 167 (••)
Per iTeoremi 26 e Teorema 28si ha \(\mathbb E(Y) = a \mu + b\) e \(\operatorname{Var}(Y) = a^2 \sigma^2\), rispettivamente.
Da \(a^2 \sigma^2 = 1\) segue \(a = \pm 1/\sigma\), e imponendo \(a\mu + b = 0\) si ricava \(b = -a \mu = \mp \mu / \sigma\).
\[Y = \pm\frac{X}{\sigma} \mp\frac{\mu}{\sigma} = \pm \frac{X - \mu}{\sigma} \enspace.\]
Esercizio 168 (•)
Rimbalzando lungo un corridoio, Bouncing Boy percorre un numero di metri \(B\) con supporto \(S_B = \{1, 2, 4, 8\}\), dove i quattro valori sono equiprobabili.
Scrivete la funzione di ripartizione \(F_B\) nei punti del supporto.
Determinate i tre quartili \(x_{0.25}\), \(x_{0.5}\) e \(x_{0.75}\).
Calcolate la distanza interquartile e il range di \(B\), e dite quale dei due indici è più sensibile a un eventuale aumento del valore \(8\).
Solution to Esercizio 168 (•)
Essendo i valori equiprobabili, ciascuno ha massa \(0.25\) e quindi \(F_B(1) = 0.25\), \(F_B(2) = 0.5\), \(F_B(4) = 0.75\) e \(F_B(8) = 1\).
Applicando la Definizione 37, il quantile di livello \(q\) è il più piccolo valore del supporto in cui \(F_B\) raggiunge o supera \(q\): \(x_{0.25} = 1\), \(x_{0.5} = 2\) e \(x_{0.75} = 4\). In questo caso i tre livelli vengono raggiunti esattamente, perché coincidono con i valori assunti da \(F_B\).
La distanza interquartile è \(x_{0.75} - x_{0.25} = 4 - 1 = 3\), mentre il range è \(8 - 1 = 7\). Il range è il più sensibile al valore \(8\): dipende direttamente dal massimo del supporto, quindi aumenterebbe al crescere di quest'ultimo; la distanza interquartile, invece, non cambierebbe.
Esercizio 169 (••)
Riprendendo l'Esempio 97, calcolate la varianza della variabile indicatrice di un evento \(A\) applicando direttamente la Definizione 35.
Solution to Esercizio 169 (••)
Indicando con \(A\) l'evento di riferimento e con \(p\) la sua probabilità, si ha \(\mathbb E(I_A) = p\) e
Esercizio 170 (••)
Scrivete una funzione var che accetta come argomenti:
una lista di valori,
una lista di masse di probabilità che ha la stessa lunghezza dell'argomento precedente e i cui elementi sommano a \(1\),
e che restituisce la varianza della corrispondente variabile aleatoria. Verificate il funzionamento di questa funzione su:
una variabile aleatoria degenere che è sempre uguale a \(1\),
una variabile aleatoria che assume solamente le specificazioni \(0\) e \(1\) con uguale probabilità,
una variabile aleatoria che assume solamente le specificazioni \(0\) e \(1\), rispettivamente con probabilità \(\tfrac{3}{5}\) e \(\tfrac{2}{5}\),
la variabile aleatoria che indica il risultato del lancio di un dado bilanciato a sei facce.
Solution to Esercizio 170 (••)
La cella seguente riporta la definizione della funzione expected_value
fornita nella soluzione dell'Esercizio 157 e la utilizza per calcolare
la varianza, applicando direttamente la Definizione 35. Vengono poi
eseguiti i test indicati.
def expected_value(x, p):
    assert len(x) == len(p), "x and p must have the same length"
    assert abs(sum(p) - 1) < 1e-6, "Probabilities must sum to 1"
    return sum(x_i * p_i for x_i, p_i in zip(x, p))

def variance(x, p):
    mu = expected_value(x, p)
    return sum(p_i * (x_i - mu) ** 2 for x_i, p_i in zip(x, p))

assert variance([1], [1]) == 0
assert variance([0, 1], [0.5, 0.5]) == 0.25
assert variance([0, 1], [3/5, 2/5]) == 0.24
assert variance(np.arange(1, 7), [1/6] * 6) == 35/12
Esercizio 171 (••)
Dimostrate che \(\operatorname{Var}(X) = 0\) se e solo se \(X\) è una variabile aleatoria degenere.
Solution to Esercizio 171 (••)
Il fatto che una variabile aleatoria degenere abbia varianza nulla è una conseguenza diretta del Teorema 28. D'altro canto, se \(\operatorname{Var}(X) = 0\), allora
e notando che ogni singolo addendo nella somma non è mai negativo, ciò implica che per ogni \(x \in S_X\) deve valere \((x - \mathbb E(X))^2 p_X(x) = 0\). Inoltre, \(p_X\) è positiva sui valori del supporto di \(X\), dunque \(x - \mathbb E(X) = 0\). Concludendo, \(x = \mathbb E(X)\) per ogni valore del supporto, che deve quindi essere un insieme singoletto.
Esercizio 172 (••)
Dimostrate l'enunciato del Teorema 28 applicando (19.11).
Solution to Esercizio 172 (••)
Usando la formula alternativa per il calcolo della varianza e tenendo conto delle proprietà del valore atteso, si ha
Esercizio 173 (••)
Con riferimento alla variabile \(T\) dell'Esercizio 166, per la quale \(\mu = \mathbb E(T) = 2.1\) e \(\operatorname{Var}(T) = 0.49\):
Calcolate \(\mathbb E\left((T-c)^2\right)\) per \(c = 2\) e per \(c = 3\).
Verificate i due risultati usando l'identità \(\mathbb E\left((T-c)^2\right) = \operatorname{Var}(T) + (\mu - c)^2\).
Scrivete del codice che visualizzi il grafico di \(\mathbb E\left((T-c)^2\right)\) al variare di \(c\), evidenziandone il minimo e commentando i risultati ottenuti.
Solution to Esercizio 173 (••)
Per \(c = 2\) si ha \(\mathbb E\left((T-2)^2\right) = 1\cdot 0.2 + 0\cdot 0.5 + 1\cdot 0.3= 0.5\), mentre quando \(c = 3\) il valore atteso è \(\mathbb E\left((T-3)^2\right) = 4\cdot 0.2 + 1\cdot 0.5 + 0\cdot 0.3 =1.3\).
Sostituendo nei membri a sinistra dell'identità i valori di \(c\), \(\operatorname{Var}(T)\) e \(\mu\) si ottiene \(0.49 + (2.1-2)^2 = 0.49 + 0.01 = 0.5\) nel primo caso e \(0.49 + (2.1-3)^2 = 0.49 + 0.81 = 1.3\) nel secondo, che coincidono con i valori calcolati direttamente.
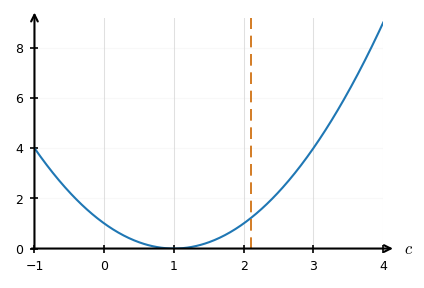
Sappiamo che il minimo di \(\mathbb E\left((T-c)^2\right)\) si trova in corrispondenza di \(c = \mu = 2.1\), quindi possiamo disegnare il grafico richiesto e sovrapporlo a un segmento in corrispondenza del minimo.
import matplotlib.pyplot as plt
import numpy as np

c_values = np.linspace(-1, 4, 400)
exp_deviation = sum(((1 - c_values) ** 2) * p for p in (0.2, 0.5, 0.3))

fig, ax = plt.subplots()
ax.plot(c_values, exp_deviation)
ax.vlines(2.1, 0, 10, color='#cc6600', linewidth=0.8, linestyle=(0, (7, 4)))
ax.set_xlabel(r'$c$')
ax.set_xlim(-1, 4)
ax.set_ylim(0, exp_deviation.max() + 0.2)
ax.grid(axis='y', alpha=0.15)
plt.show()
Esercizio 174 (••••)
Il quantile di una variabile aleatoria coincide sempre con un valore del suo supporto? In caso affermativo, dimostratelo, altrimenti fornite un controesempio (suggerimento: rivedete l'Esempio 90).
Solution to Esercizio 174 (••••)
L'Esempio 90 mostra che la mediana, che il quantile di livello \(0.5\) può non essere un elemento del supporto della variabile aleatoria.
Esercizio 175 (•••)
L'altezza raggiunta da Darkhawk in un balzo è una variabile aleatoria \(X\), misurata in metri, con \(\mathbb E(X) = 40\) e \(\operatorname{Var}(X) = 6.25\).
Calcolate \(\operatorname{SD}(X)\) e \(\mathbb E(X^2)\).
Un secondo sensore misura la stessa altezza in centimetri: posto \(Z = 100 X\), calcolate \(\operatorname{Var}(Z)\) e \(\operatorname{SD}(Z)\), specificando le unità di misura corrispondenti.
Un terzo sensore è collocato su una piattaforma alta tre metri, e misura quindi \(W = X - 3\). Calcolate \(\operatorname{Var}(W)\) e commentate il risultato.
Un quarto sensore misura la distanza \(V = 50 - X\) tra Darkhawk e il soffitto di un hangar alto cinquanta metri. Calcolate \(\operatorname{SD}(V)\).
Solution to Esercizio 175 (•••)
\(\operatorname{SD}(X) = \sqrt{6.25} = 2.5 \, \mathrm{m}\). Riscrivendo (19.11) come \(\mathbb E(X^2) = \operatorname{Var}(X) + \mathbb E(X)^2\) si ottiene \(\mathbb E(X^2) = 6.25 + 1600 = 1606.25 \, \mathrm{m}^2\).
Per il Teorema 28, \(\operatorname{Var}(Z) = 100^2 \cdot 6.25 = 62\,500 \, \mathrm{cm}^2\), e per il Corollario 6, \(\operatorname{SD}(Z) = 100 \cdot 2.5 = 250 \, \mathrm{cm}\). La dispersione fisica è la stessa: è cambiata solo l'unità di misura.
La variabile \(W\) è costruita applicando una traslazione, ponendo quindi \(a = 1\) nel Teorema 28: \(\operatorname{Var}(W) = \operatorname{Var}(X) = 6.25 \, \mathrm{m}^2\). Spostare l'origine delle misure cambia il valore atteso, che diventa \(37\) metri, ma non modifica quanto le altezze siano disperse.
Anche in questo caso viene applicata a \(X\) una trasformazione affine, con \(a = -1\) e \(b = 50\), quindi \(\operatorname{SD}(V) = \lvert -1 \rvert \operatorname{SD}(X) = 2.5 \, \mathrm{m}\): misurare la distanza dal soffitto anziché da terra ribalta l'ordine dei valori, ma non altera la dispersione.
Esercizio 176 (••)
Sia \(X\) una variabile aleatoria con supporto \(S_X = \{\alpha, \beta\}\), dove \(\alpha < \beta\), e sia \(p = \mathbb P(X = \beta)\), con \(p \in (0,1)\).
Verificate che \(X = \alpha + (\beta - \alpha) I\), dove \(I\) è la variabile indicatrice dell'evento \(\{X = \beta\}\).
Sfruttando il punto precedente e l'Esempio 97, mostrate che \(\operatorname{Var}(X) = (\beta-\alpha)^2 p (1-p)\).
Determinate il valore di \(p\) che rende massima la varianza e calcolate il valore massimo, esprimendolo in funzione del range di \(X\).
Solution to Esercizio 176 (••)
La variabile \(I\) vale \(1\) con probabilità \(p\) e \(0\) con probabilità \(1 - p\). Questi due casi corrispondono rispettivamente al verificarsi degli eventi \(X = \beta\) e \(X = \alpha\). In particolare:
con probabilità \(p\) si ha \(X = \beta = \alpha + (\beta - \alpha) \cdot 1\);
con probabilità \(1 - p\) si ha \(X = \alpha = \alpha + (\beta - \alpha) \cdot 0\). Quindi \(X\) e \(\alpha + (\beta - \alpha) I\) assumono gli stessi valori con le medesime probabilità.
La trasformazione applicata a \(I\) è affine, con \(a = \beta - \alpha\) e \(b = \alpha\). Per il Teorema 28 e per l'Esempio 97, si ha
\[\operatorname{Var}(X) = (\beta-\alpha)^2 \operatorname{Var}(I) = (\beta-\alpha)^2 p (1-p) \enspace.\]Il fattore \((\beta-\alpha)^2\) che compare in \(\operatorname{Var}(X)\) non dipende da \(p\), mentre il massimo di \(p(1-p)\) è \(p = \tfrac{1}{4}\), e si verifica in corrispondenza di \(p = \tfrac{1}{2}\). Siccome il range di \(X\) è \(R = \beta - \alpha\), la varianza massima è \(R^2/4\), e si ottiene quando i due valori sono equiprobabili, cioè quando l'esito dell'osservazione di \(X\) è più incerto.
Esercizio 177 (•••)
Il numero di oggetti che Matter-Eater Lad divora in un pasto è una variabile aleatoria \(M\) con supporto \(\mathbb N\) e funzione di massa di probabilità \(p_M(k) = 2^{-k} 𝟙_\mathbb N(k)\).
Verificate che \(p_M\) è una funzione di massa di probabilità e che \(F_M(x) = 1 - 2^{-\lfloor x \rfloor}\).
Determinate i tre quartili di \(M\) e la sua distanza interquartile.
Il range di \(M\) è definito? Motivate la risposta.
Descrivete il box plot di \(M\), specificando dove cadono la scatola, la mediana e i baffi.
Solution to Esercizio 177 (•••)
Le masse sono positive e, per (A.8), \(\sum_{k=1}^{+\infty} 2^{-k} = 1\), dunque \(p_M\) è una funzione di massa di probabilità. Applicando (A.5) si ottiene inoltre
\[F_M(x) = \mathbb P(M \leq x) = \sum_{i=1}^{\lfloor x \rfloor} 2^{-i} = \sum_{i=0}^{\lfloor x \rfloor} 2^{-i} - 1 = 2 (1 - 2^{-\lfloor x \rfloor - 1}) - 1 = 1 - 2^{-\lfloor x \rfloor} \enspace.\]Si ha \(F_M(1) = 0.5\) e \(F_M(2) = 0.75\). Il più piccolo valore in cui la ripartizione raggiunge \(0.25\) è quindi \(x_{0.25} = 1\), che è anche il più piccolo valore in cui raggiunge \(0.5\): pertanto \(x_{0.5} = 1\). Infine \(x_{0.75} = 2\), e la distanza interquartile è \(2 - 1 = 1\).
No: il supporto è \(\mathbb N\), quindi \(\sup S_M = +\infty\) e la Definizione 38 non è applicabile.
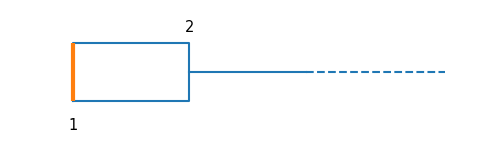
La scatola va da \(x_{0.25} = 1\) a \(x_{0.75} = 2\) e la mediana cade sul suo estremo sinistro, perché \(x_{0.5} = x_{0.25} = 1\). Il baffo sinistro collassa sul bordo della scatola a un punto, dato che il minimo del supporto coincide con il primo quartile, mentre quello destro non ha un estremo finito e va quindi tracciato come nell'Esempio 108, con un tratteggio che indica il proseguimento verso \(+\infty\). La cella seguente permette di disegnare il box plot.
import matplotlib.pyplot as plt

fig, ax = plt.subplots(figsize=(4, 1))

minimum = 1
first_quartile = 1
median = 1
third_quartile = 2
right_whisker_solid_end = 3
right_whisker_dashed_end = 4.2

stats = [{
    "label": "",
    "q1": first_quartile,
    "med": median,
    "q3": third_quartile,
    "whislo": minimum,
    "whishi": right_whisker_solid_end,
    "fliers": [],
}]

box = ax.bxp(stats, orientation='horizontal', widths=0.5)

box['caps'][1].set_visible(False)
right_whisker = box['whiskers'][1]
ax.plot([right_whisker_solid_end, right_whisker_dashed_end], [1, 1],
        color=right_whisker.get_color(),
        linewidth=right_whisker.get_linewidth(),
        linestyle='--')

for x_value, y_value, text in [(median, 0.5, median),
                               (third_quartile, 1.35, third_quartile)]:
  ax.text(x_value, y_value, text, ha='center')

ax.set_xlim(0.5, 4.5)
ax.axis('off')
plt.show()
Esercizio 178 (••••)
Sia \(X\) una variabile aleatoria discreta il cui supporto \(S_X\) ammette minimo \(\alpha\) e massimo \(\beta\), e sia \(R = \beta - \alpha\) il suo range.
Posto \(c = (\alpha+\beta)/2\), mostrate che \(\mathbb E\left((X-c)^2\right) \leq R^2/4\).
Deducete che \(\operatorname{Var}(X) \leq R^2/4\): la varianza di una variabile aleatoria non può quindi essere grande se il suo range è piccolo.
Verificate che disuguaglianza del punto precedente vale per la variabile aleatoria dell'Esempio 98.
Dimostrate che quando la massa di probabilità è equamente ripartita sui due estremi del supporto, \(\operatorname{Var}(X) = R^2/4\).
Solution to Esercizio 178 (••••)
Il valore \(c\) è il punto medio dell'intervallo \([\alpha, \beta]\), che contiene tutto il supporto: per ogni \(x \in S_X\) si ha dunque \(\lvert x - c \rvert \leq R/2\) e quindi \((x-c)^2 \leq R^2/4\). Il valore atteso di una quantità che non supera mai \(R^2/4\) non può superare \(R^2/4\), da cui \(\mathbb E\left((X-c)^2\right) \leq R^2/4\).
Come visto in questo paragrafo, \(\mathbb E\left((X-c)^2\right) = \operatorname{Var}(X) + (\mu-c)^2\) con \(\mu = \mathbb E(X)\), e il termine \((\mu-c)^2\) è non negativo. Pertanto
\[\operatorname{Var}(X) \leq \mathbb E\left((X-c)^2\right) \leq \frac{R^2}{4} \enspace.\]La variabile aleatoria considerata descrive l'esito del lancio di un dado a sei facce e bilanciato, per cui si ha \(\alpha = 1\), \(\beta = 6\) ed \(R = 5\). Il membro destro della disuguaglianza vale perciò \(25/4 = 6.25\), mentre la varianza calcolata nell'Esempio 98 è \(35/12 \approx 2.92\), che rispetta la disuguaglianza.
Se \(\mathbb P(X = \alpha) = \mathbb P(X = \beta) = \tfrac{1}{2}\), allora \(\mathbb E(X) = \tfrac{\alpha + \beta}{2}\), \(\mathbb E(X^2) = \tfrac{\alpha^2 + \beta^2}{2}\) e
\[\operatorname{Var}(X) = \frac{\alpha^2 + \beta^2}{2} -\frac{\alpha^2 + 2\alpha\beta + \beta^2}{2} = \frac{\alpha^2 - 2\alpha\beta + \beta^2}{4} = \frac{(\beta - \alpha)^2}{4} \enspace.\]
19.4.6. Concetti fondamentali#
Pensate ai concetti fondamentali illustrati in questo paragrafo ed elencateli. Nella lista qui sotto sono già presenti gli stessi concetti, ma nascosti. Cliccate sul pulsante per mostrarli sotto forma di parole chiave, quindi confrontateli con la vostra lista. Provate infine a descrivere ciascun concetto con parole vostre.